Wie ein einziger menschlicher Datenpunkt den Kollaps von KI-Modellen verhindert
Wenn KI-Modelle nur noch mit synthetischen Daten trainiert werden, droht der Modellkollaps. Eine neue Studie zeigt, dass bereits ein einziger von Menschen erstellter Datenpunkt diesen Effekt verhindern kann.
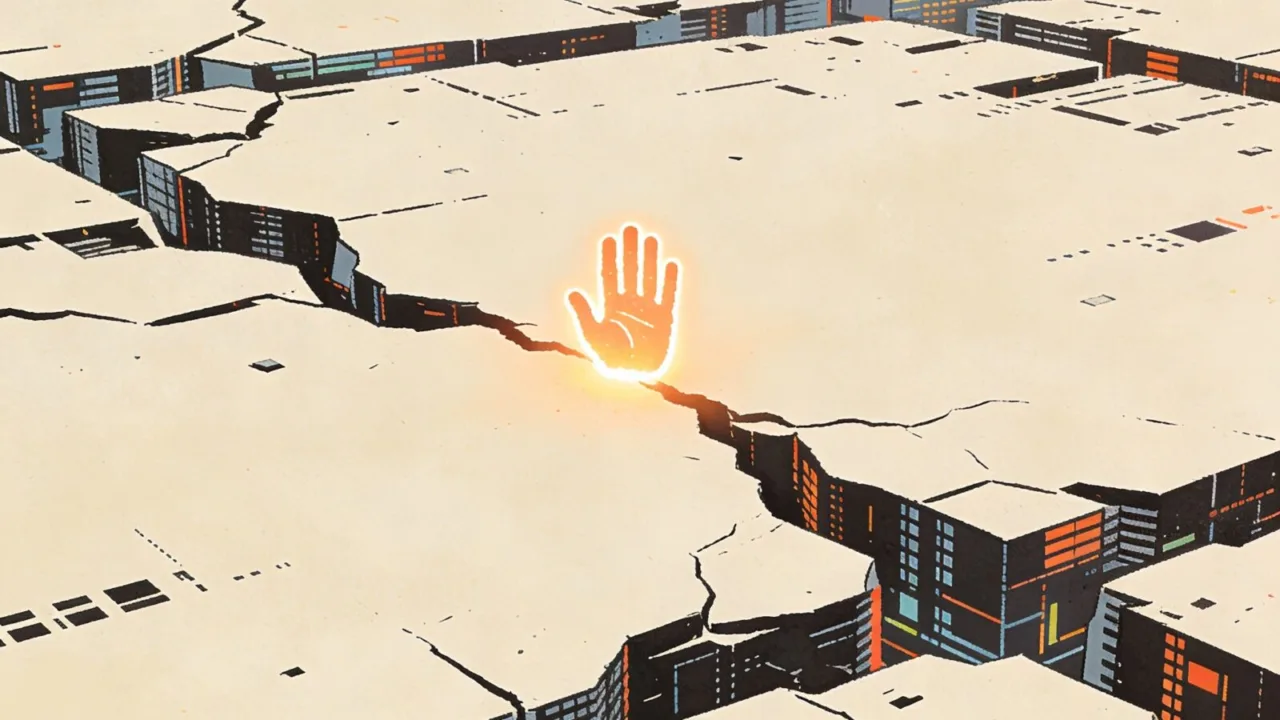
Was passiert, wenn große Sprachmodelle und andere KI-Systeme irgendwann keine neuen, von Menschen erzeugten Trainingsdaten mehr finden? Die Befürchtung: Sie beginnen, sich von synthetischen Daten zu ernähren - und kollabieren. Eine neue Studie zeigt nun einen überraschend einfachen Ausweg.
Die schleichende Gefahr des Modellkollaps
Wenn KI-Modelle mit Daten trainiert werden, die selbst von einer KI generiert wurden, verlieren sie allmählich die Fähigkeit, seltene oder nuancierte Informationen wiederzugeben. Im Frühstadium äußert sich das in glattgebügelten, nichtssagenden Antworten, die zwar grammatikalisch korrekt wirken, aber jede inhaltliche Tiefe vermissen lassen. Im Spätstadium hingegen produzieren die Modelle schlichten Unsinn - ein Phänomen, das Fachleute als Modellkollaps bezeichnen.
„Das ist besonders besorgniserregend, wenn man bedenkt, dass einige Experten davon ausgehen, dass uns bis Ende des Jahres die hochwertigen, von Menschen erzeugten Daten ausgehen werden. Wenn man sich also auf synthetische Daten verlässt, droht eine fast existenzielle Gefahr, die KI zum Kentern zu bringen“, sagt Yasser Roudi, Professor am King’s College London.
Die Gefahr ist nicht bloß akademisch. Schon heute lassen sich bei generativen KI-Werkzeugen wie ChatGPT oder Gemini Anzeichen eines schleichenden Qualitätsverlusts beobachten: Die Antworten werden zunehmend generisch, und die Modelle halluzinieren häufiger. Der Grund dafür liegt in der Art, wie große Sprachmodelle trainiert werden. Sie lernen Muster aus riesigen Datenmengen. Stammen diese Daten jedoch von anderen KI-Systemen, schleichen sich systematische Verzerrungen ein, die sich über mehrere Trainingsgenerationen hinweg aufschaukeln.
Warum das Problem drängt
Die Sorge, dass die Vorräte an menschengemachten Trainingsdaten zur Neige gehen, ist real. Hochwertige Texte, Bilder und Videos, die von Menschen erstellt und kuratiert wurden, sind endlich. Gleichzeitig wächst der Hunger der Modelle. Wenn sie in einer geschlossenen Schleife immer wieder mit den eigenen synthetischen Erzeugnissen gefüttert werden, verlieren sie den Bezug zur realen Welt. Roudi veranschaulicht die Konsequenzen an einem drastischen Beispiel: „Wenn etwa LLMs in Krankenhäusern eingesetzt würden, um Hirnscans zu analysieren und Krebs zu erkennen, könnten sie bei einem Modellkollaps Menschen falsch diagnostizieren.“
Bislang ist ein solcher Kollaps in einem produktiv eingesetzten KI-System zwar noch nicht in vollem Umfang aufgetreten, doch die Warnsignale mehren sich. Die Forschung steht daher vor der doppelten Herausforderung, den Mechanismus des Kollapses genau zu verstehen und praktikable Gegenmaßnahmen zu entwickeln.
Der Blick ins Innere der Modelle
Ein Team um Roudi, dem auch Forschende der Norwegian University of Science and Technology und des Abdus Salam International Centre for Theoretical Physics angehörten, hat sich dieser Aufgabe angenommen. Statt mit riesigen, undurchschaubaren Sprachmodellen zu experimentieren, griffen die Wissenschaftler auf kleinere, mathematisch handhabbare Modelle aus der Klasse der exponentiellen Familien zurück - darunter so vertraute Verteilungen wie die Gauß’sche Glockenkurve.
„Indem man analytisch handhabbare Modelle wie die Exponentialfamilien betrachtet, kann man diese ‚Warum‘- und ‚Wie‘-Fragen beantworten“, erklärt Roudi.
In ihrer Studie, die im Fachjournal Physical Review Letters erschien, simulierten sie ein Closed-Loop-Training: Jede neue Modellgeneration wurde ausschließlich mit Daten trainiert, die das Vorgängermodell erzeugt hatte. Wie erwartet, trat nach wenigen Iterationen der Kollaps ein - die Modelle verloren die Fähigkeit, die ursprüngliche Datenverteilung korrekt abzubilden, und produzierten zunehmend verfälschte Ausgaben.
Die überraschende Entdeckung: Ein einziger Datenpunkt genügt
Doch dann testeten die Forscher eine verblüffend einfache Intervention: Sie fügten dem ansonsten rein synthetischen Trainingsdatensatz einen einzigen von Menschen erstellten Datenpunkt hinzu - und der Kollaps blieb aus. Dieser eine Datenpunkt musste allerdings mit einer „Ground Truth“ verbunden sein, also mit einer unabhängig überprüfbaren, zweifelsfrei richtigen Information.
„Mit anderen Worten, dieser Datenpunkt wäre mit einer ‚Ground Truth‘ verbunden, etwas, von dem wir unbestreitbar wissen, dass es wahr und unabhängig überprüfbar ist“, so Roudi. Ein konkretes Beispiel wäre ein Bildklassifizierer, der mit einem von einem Menschen korrekt beschrifteten echten Foto trainiert wird, anstatt nur mit KI-generierten Bildern und deren automatisch zugewiesenen Labels.
Die Erklärung für diesen Effekt liegt in der Mathematik der exponentiellen Familien: Ein einzelner externer Datenpunkt kann als Anker wirken, der die Modellparameter daran hindert, in einen degenerierten Zustand abzudriften. Er erhält gewissermaßen die Verbindung zur realen Welt aufrecht, selbst wenn der Rest der Trainingsdaten synthetisch ist.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Was bedeutet das für die KI-Entwicklung?
Die Studie liefert keine fertige Blaupause für ChatGPT oder Gemini, wohl aber ein grundlegendes Prinzip. „Diese Forschung ist der erste Schritt, um einige Grundregeln aufzustellen, die verhindern, dass dies in Zukunft passiert“, betont Roudi. Der nächste logische Schritt besteht darin, den Ansatz auf größere und komplexere Modelle zu übertragen und zu prüfen, ob der schützende Effekt auch dort greift.
Sollte sich das Prinzip bestätigen, hätte das weitreichende Konsequenzen für die Trainingspraxis: Schon eine minimale Beimischung sorgfältig kuratierter, von Menschen geprüfter Daten könnte ausreichen, um KI-Systeme vor dem schleichenden Qualitätsverlust zu bewahren. Das wäre nicht nur für die Stabilität kommerzieller KI-Produkte von Bedeutung, sondern auch für sicherheitskritische Anwendungen in Medizin, Verkehr oder Finanzwesen. Die Erkenntnis, dass ein einziger menschlicher Datenpunkt als Anker wirken kann, gibt der KI-Forschung ein einfaches, aber mächtiges Werkzeug an die Hand, um den drohenden Datenkollaps abzuwenden - vorausgesetzt, wir bewahren uns den Zugang zu verlässlichen, von Menschen geprüften Informationen.
Quellen:
- Introducing Gemini Omni (DeepMind Blog)
- Teaching LLMs to reason like Bayesians (Google Research Blog)
- Can AI really simulate human thinking? Research casts doubt on an influential study, suggesting an advanced model was just really good at memorizing patterns. (Live Science)
- Parloa builds service agents customers want to talk to (OpenAI Blog)
- The uncritical adoption of AI in science is alarming - we urgently need guard rails (Nature - News)
- How can we prevent AI models from cannibalizing themselves when human-generated data runs out? Scientists say they’ve found the answer. (Live Science)
More on this from WISSNOX

 geist·Warum Stress das Gehirn daran hindert, Erkenntnisse zu formenEine neue Studie zeigt, dass akuter Stress die Fähigkeit des Gehirns blockiert, alte Erinnerungen mit neuen Informationen zu verknüpfen.