KI-Entscheidungsmodelle im Decision Index
Clef von Cloudflare und Strands Decider von AWS bringen schnelle KI-Entscheidungen ohne Textgenerierung. Praxis-Test, Latenzen und Hardware-Bedarf im Überblick.
👁 131 Aufrufe
Ein Decision Model (Entscheidungsmodell) ist ein KI-Modell, das keinen freien Text generiert, sondern eine Auswahl aus einer vorgegebenen Liste trifft und eine mathematische Wahrscheinlichkeit dazu liefert. Statt einer vagen Antwort wie „Das Ticket betrifft vermutlich Zahlungen“ erhalten Sie zahlungen: 0,97 - und Ihr Code entscheidet direkt über die Weiterverarbeitung. Am 1. Oktober 2026 veröffentlichte Cloudflare die offenen Modelle Clef und Clef-flash, während AWS am selben Tag den Strands Decider 2B vorstellte. Ich habe beide Modelle auf einer RTX 4090 an 30 Kundensupport-Tickets getestet (der Test wurde auf Polnisch durchgeführt).
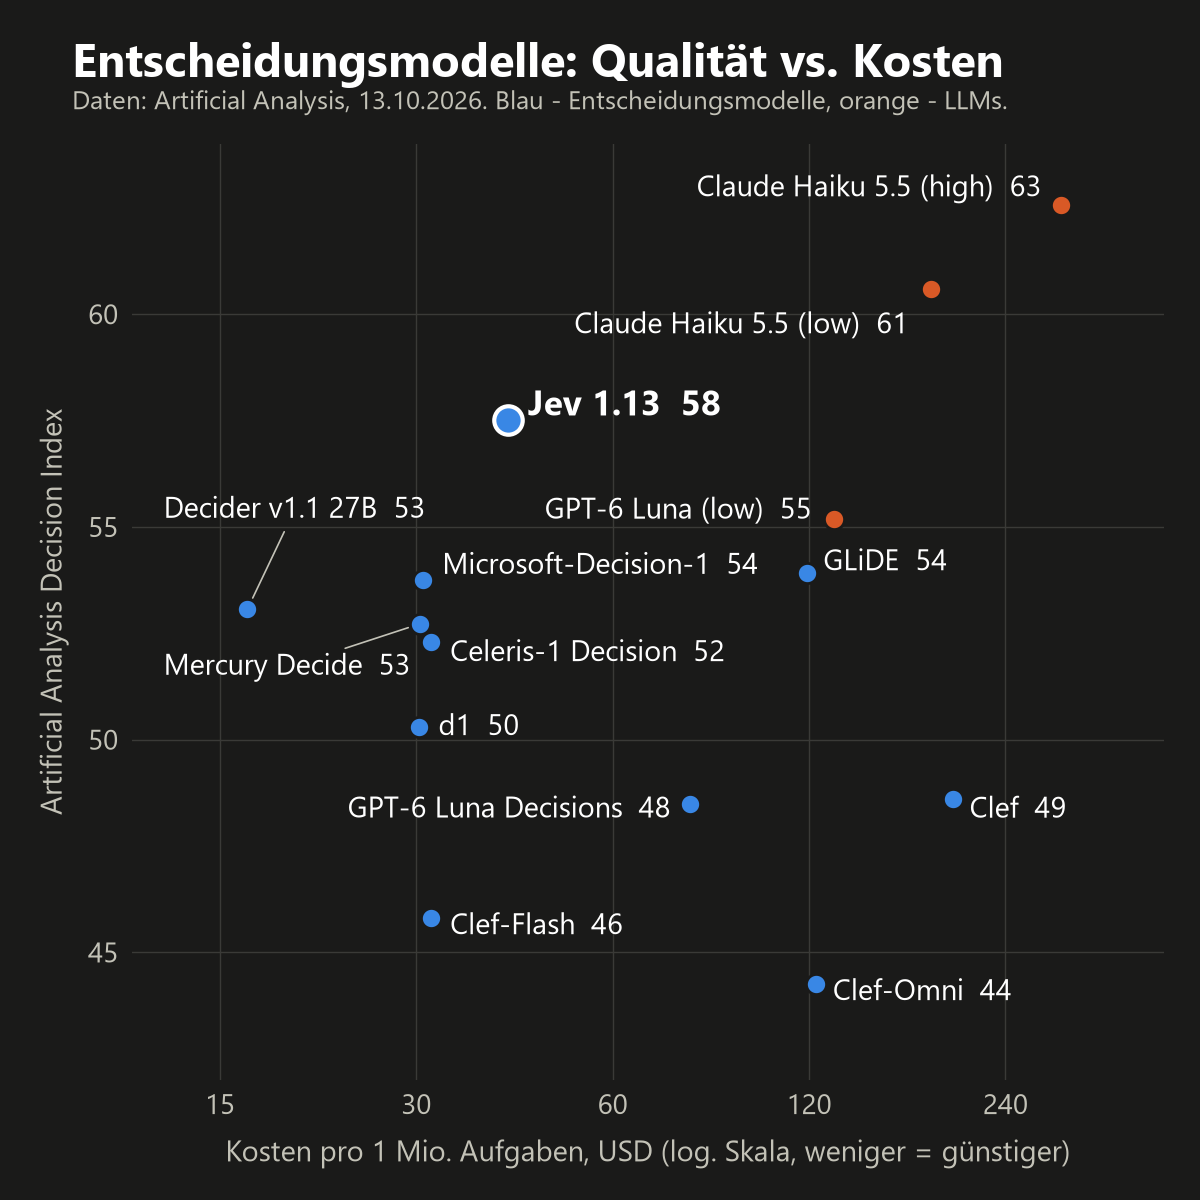
Artificial Analysis Decision Index: das erste unabhängige Ranking von Entscheidungsmodellen (13. Oktober 2026)
Ein Entscheidungsmodell schreibt keinen Text. Es erhält eine strukturierte Frage - Auswahl einer Option, Ja oder Nein, eine Bewertung - und gibt in einem einzigen Aufruf eine Wahrscheinlichkeit für jede zulässige Option zurück. Am 13. Oktober 2026 veröffentlichte Artificial Analysis (AA) den Decision Index v1.0, der 11 solcher Modelle miteinander sowie mit regulären LLMs vergleicht, die dieselben Aufgaben über strukturierte Ausgaben beantworten. Alle nachstehenden Zahlen stammen aus dem AA-Leaderboard mit Stand vom 13. Oktober 2026; die Live-Tabelle kann sich ändern.
Ranking der 11 Entscheidungsmodelle
| Modell (Unternehmen) | Index | Kosten pro 1 Mio. Aufgaben | Mediane Zeit |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 57,5 | 41,5 USD | 127 ms |
| GLiDE (Fastino Labs) | 53,9 | 119,0 USD | 217 ms |
| Microsoft-Decision-1 (Microsoft) | 53,8 | 30,7 USD | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | 16,5 USD | 170 ms |
| Mercury Decide (Inception) | 52,7 | 30,4 USD | 500 ms |
| Celeris-1 Decision (Celeris) | 52,3 | 31,6 USD | 63 ms |
| d1 (Liquid AI) | 50,3 | 30,3 USD | 299 ms |
| Clef (Cloudflare) | 48,6 | 199,4 USD | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | 78,9 USD | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | 31,6 USD | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | 123,1 USD | 172 ms |
Zum Vergleich LLMs bei denselben Aufgaben: Claude Haiku 5.5 (low reasoning) 60,6 bei 184 USD pro 1 Mio. Aufgaben und 1.434 ms, GPT-6 Luna (low) 55,2 bei 131 USD und 1.500 ms, Claude Opus 5.5 (max) 79,0 bei 51.295 USD und 3.571 ms.
Was die vier Tests messen
Jeder Test fließt zu 25 % in den Index ein:
- AA-Omniscience-Decision - 500 private Wissensfragen mit 5 Optionen (4 Antworten plus „Ich weiß es nicht“); zur Hälfte Genauigkeit, zur Hälfte Nicht-Halluzinationsrate, d. h. wie oft ein Modell, das die Antwort nicht weiß, „Ich weiß es nicht“ wählt.
- HLE-MultiChoice - 513 reine Text-Multiple-Choice-Fragen aus Humanity’s Last Exam (schwieriges logisches Denken).
- When2Call (NVIDIA) - direkt antworten, ein Tool aufrufen, um weitere Informationen bitten oder mitteilen, dass es nicht helfen kann.
- WildGuardTest (Ai2) - ist die Anfrage schädlich, handelt es sich um eine Verweigerung, ist die Antwort schädlich (durchschnittlicher F1-Score).
Bei Entscheidungsmodellen wählt AA die Option mit der höchsten Wahrscheinlichkeit (bei Ja/Nein: Ja, wenn p mindestens 0,5 beträgt). LLMs erhalten einen festen System-Prompt und antworten im JSON-Format. Entscheidungsmodelle werden nur nach Input abgerechnet, LLMs nach Input und Output.
Stärken und Schwächen pro Test
- Wissen ist die Schwachstelle aller Entscheidungsmodelle: 28-41 % Genauigkeit gegenüber 52 % bei Claude Haiku 5.5 (low) und 66 % bei GPT-6 Luna (low). Jev 1.13 erreicht 34,6 %, Microsoft-Decision-1 28,2 %, der Spitzenwert liegt bei d1 mit 41,0 % - d1 antwortet jedoch fast nie mit „Ich weiß es nicht“ (1,7).
- Antwort mit „Ich weiß es nicht“: Microsoft-Decision-1 39,8, Jev 1.13 35,2, Mercury Decide 32,0; kein anderes Entscheidungsmodell liegt über 17, Celeris-1 erzielt 0.
- Logisches Denken (HLE-MultiChoice): Jev 1.13 20,9, jedes andere Entscheidungsmodell 15,4 oder weniger.
- Tool-Aufrufe (When2Call): GLiDE und Celeris-1 83,7 - über Claude Haiku 5.5 low (72,6) und GPT-6 Luna low (77,0).
- Sicherheitsklassifizierung (WildGuardTest): GLiDE 95,1, das beste Ergebnis in der gesamten Tabelle einschließlich der LLMs; Decider 93,8, Jev 93,6, Claude Haiku 5.5 low 92,6. Schwächstes Ergebnis: GPT-6 Luna Decisions 82,8.
- Laut AA neigen alle Entscheidungsmodelle zu Überkonfidenz, vor allem bei Wissen und logischem Denken; die Kalibrierung bei When2Call und WildGuardTest ist relativ gut.
Kosten im Verhältnis zur Qualität
- Auf der Pareto-Grenze für Kosten und Qualität platziert AA drei Modelle: Decider v1.1 27B (16,5 USD pro 1 Mio. Aufgaben), Microsoft-Decision-1 (30,7 USD) und Jev 1.13 (41,5 USD).
- Claude Haiku 5.5 (low) erzielt 3 Punkte mehr als Jev 1.13, ist laut AA jedoch 11-mal langsamer und 4,4-mal teurer.
- Reine Klassifizierung (WildGuardTest, pro 1 Mio. Aufgaben): Decider 12,1 USD, Microsoft-Decision-1 12,5 USD, Mercury Decide 12,6 USD, Celeris-1 16,0 USD, Jev 22,8 USD, GLiDE 84,3 USD - gegenüber 91,5 USD für Claude Haiku 5.5 (low) und 3.774 USD für Claude Opus 5.5 (low).
Preise (USD pro 1 Mio. Input-Token, Output kostenlos, Stand 13. Oktober 2026)
| Modell | Anbieter | OpenRouter |
|---|---|---|
| Jev 1.13 | 0,042 | 0,042 |
| GLiDE | 0,15 (alle internen Durchläufe abgerechnet) | - |
| Microsoft-Decision-1 | 0,042 (Microsoft Foundry) | 0,042 |
| Decider v1.1 27B | 0,02 | 0,02 |
| Mercury Decide | 0,04 (Aktion 0,02) | 0,02 |
| Celeris-1 Decision | 0,04 | - |
| d1 | 0,04 | 0,04 |
| Clef | 0,24 (Workers AI) | ab 0,042 |
| Clef-Flash | 0,038 | ab 0,021 |
| Clef-Omni | 0,15 | 0,15 |
| GPT-6 Luna Decisions | 0,10 (+10 % für EU/EWR-Verarbeitung) | 0,10 |
Wann ein Entscheidungsmodell anstelle eines LLM sinnvoll ist
- Die Antwort stammt aus einer festen Menge an Optionen: Weiterleitung von Tickets an eine Abteilung, Ja/Nein-Flags, Moderation, Entscheidung über den Aufruf eines Tools. Genau das messen drei der vier AA-Tests, und hier reichen Entscheidungsmodelle an kleine LLMs heran oder übertreffen sie.
- Volumen und Latenz sind entscheidend: Entscheidungsmodelle antworten in etwa 60-500 ms (AA-Median) und kosten einige Dutzend Dollar pro 1 Mio. Aufgaben; LLMs benötigen für dieselben Aufgaben 1,4-3,6 s und kosten ab etwa 130 USD pro 1 Mio. Aufgaben.
- Eine Wahrscheinlichkeit wird benötigt, nicht nur ein Label - beispielsweise um Fälle mit geringer Konfidenz an eine Person oder ein leistungsstärkeres Modell zu übergeben.
- Ein LLM bleibt die bessere Wahl für Wissensfragen (Entscheidungsmodelle erreichen 28-41 % im Wissenstest von AA) und für alles, was eine schriftliche Textausgabe erfordert.
Unser Test mit 50 Support-Tickets in einer nicht-englischen Sprache
Am 13. Oktober 2026 haben wir 9 Entscheidungsmodelle über OpenRouter und zwei LLMs (Claude Haiku 5.5 und GPT-6 Luna, Reasoning auf Low) auf 50 E-Commerce-Support-Tickets auf Polnisch (Abteilung aus 7 Optionen plus Dringlichkeits-Flag) und 10 Unterhaltungen im When2Call-Stil angewendet. Die Musterlösung wurde vor dem Durchlauf festgelegt. Kleine Stichprobe - die Ergebnisse sind als Richtwerte zu verstehen.
- Abteilung bei 47 eindeutigen Tickets: Entscheidungsmodelle 41-44 korrekt, beide LLMs 45. Jev 1.13 erzielte das niedrigste Ergebnis (41); Microsoft-Decision-1, Decider, Mercury Decide und Clef 44.
- Dringlichkeit: Decider und GPT-6 Luna Decisions 48 von 50; Microsoft-Decision-1 42 von 50 (8 Fehlalarme bei einem Schwellenwert von 0,5).
- Tool-Entscheidung: 7 Entscheidungsmodelle und beide LLMs 10 von 10, Mercury Decide 9, Clef-Flash und Clef-Omni 6.
- Aus Europa über OpenRouter gemessene mediane Latenz: Entscheidungsmodelle 310-619 ms, Claude Haiku 5.5 1.689 ms, GPT-6 Luna 1.371 ms.
- Gemessene Kosten pro 1 Mio. solcher Aufgaben: Mercury Decide 4,4 USD (Aktionspreis), Decider 7,8 USD, Microsoft-Decision-1 11,5 USD, Jev 1.13 26,8 USD (benötigte für diesen Text etwa 640 Input-Token pro Aufgabe gegenüber etwa 275 bei Microsoft-Decision-1), Claude Haiku 5.5 96,7 USD.
- Konfidenz eignet sich als Filter: Ab einer Konfidenz von mindestens 0,9 lag Jev bei 37 von 39 Tickets richtig, Decider bei 39 von 41. Eine Kaskade - Microsoft-Decision-1 zuerst, Claude Haiku 5.5 erst unterhalb einer Konfidenz von 0,8 - erzielte 45 von 47, denselben Wert wie Haiku allein, bei rund 18 USD statt etwa 101 USD pro 1 Mio. Klassifizierungen.
Wie der Zugriff funktioniert
OpenRouter stellt 9 der 11 bewerteten Modelle über einen separaten Endpunkt bereit: POST https://openrouter.ai/api/alpha/decisions (Felder state und questions) - Entscheidungsmodelle funktionieren nicht über /chat/completions. GLiDE und Celeris-1 Decision sind ausschließlich über die APIs ihrer Hersteller verfügbar. Decider v1.1 27B (Apache-2.0, etwa 49 GiB GPU-Speicher), d1-3B (LFM Open License, kostenlos bei weniger als 10 Millionen USD Jahresumsatz) und die Cloudflare-Clef-Modelle (Apache-2.0) verfügen über offene Gewichte.
Artikel zu Entscheidungsmodellen
- Decision Index v1.0 bewertet Decision Models
- Decision Model vs LLM: Unterschiede und Einsatzbereiche
- Decision Model Preise: Kosten pro Million Tokens und Tasks
- Welches Decision Model waehlen? Kriterien und Benchmarks
Quellen
- Artificial Analysis - Decision Index announcement
- Artificial Analysis - Decision Index leaderboard
- Artificial Analysis - Decision Index methodology
- OpenRouter - Decisions API
- TypeSafe - Jev models
- Fastino - GLiDE
- Microsoft - Microsoft-Decision-1 in Foundry
- Perplexity - Decisions API
- Inception - Mercury Decide
- Celeris - Celeris-1 Decision
- Liquid AI - d1
- Cloudflare - Clef
- OpenAI - Decisions guide
Stand: 7. Oktober 2026
- Cloudflare Clef (27B, Basis Qwen3.8-27B) und Clef-flash (9B, Basis Qwen3.5-9B) - Apache-2.0-Lizenz, Gewichte auf Hugging Face, Hosting über Workers AI für ca. 0,21 EUR (0,24 USD) bzw. ca. 0,08 EUR (0,09 USD) pro Million Input-Token (Umrechnungskurs: 1 EUR = 1,1181 USD, EZB-Referenzkurs vom 12.10.2026 via EZB).
- Strands Decider 2B von AWS - Apache-2.0, Gewichte, Trainingsdaten und Skripte sind öffentlich verfügbar; läuft problemlos auch auf CPUs.
- Kev 1.0 (Jared Palmer) - Familie offener Modelle von 0,8B bis 27B, trainiert ausschliesslich auf Englisch.
- Aplomb 1 von EmpirioLabs (Launch am 29.09.) - 5,3B, verarbeitet Text, JSON, Bilder, Videos und Audio, Kontextfenster von 1 Mio. Token, Gewichte unter eigener Lizenz, API für ca. 0,018 EUR (0,02 USD) pro Million Input-Token (EZB-Referenz vom 12.10.2026). Mehr dazu.
- Alle Modelle nutzen dieselbe Schnittstellen-Logik wie Jev von TypeSafe (System One), das diese Modellkategorie am 15. September eröffnete.
- Mein Test: Clef-flash und Strands Decider ordneten die Abteilung in 30 von 30 Support-Anfragen korrekt zu (getestet auf Polnisch) - bei einer Latenz von 112 ms bzw. 135 ms pro Entscheidung im Median.
Was ist ein Decision Model?
Klassische Large Language Models (LLMs) generieren Text Wort für Wort. Selbst wenn man sie anweist, nur mit einem einzigen Wort oder einem JSON-Objekt zu antworten, durchlaufen sie die Textgenerierung. Ein Decision Model funktioniert grundlegend anders:
- Es erhält einen Zustand (State) - etwa den Ticket-Text, Bestelldaten als JSON oder bei Clef auch ein Bild.
- Es erhält Fragen mit einer geschlossenen Liste möglicher Antworten: z. B. „Welche Abteilung?“ mit den Optionen
zahlungen,lieferung,retoure… - Es verarbeitet den Zustand in einem einzigen Prefill-Durchlauf und liefert für jede erlaubte Option eine Wahrscheinlichkeit zurück. Keine Generierung, kein nachgelagertes Parsing, kein Risiko für Halluzinationen ausserhalb der Liste.
Alle Modelle dieser Familie unterstützen drei standardisierte Fragetypen, die durch Jev von TypeSafe etabliert wurden:
| Typ | Fragestellung | Rückgabe |
|---|---|---|
choice |
Wähle eine Option aus einer Liste | Ausgewählte Option, Konfidenzwert und Wahrscheinlichkeitsverteilung |
noul |
Ja oder Nein? | Wahrscheinlichkeit für „Ja“ zwischen 0 und 1 |
score |
Bewertung auf einer Skala (z. B. kein Einfluss, gering, gross, kritisch) | Erwarteter Score, Konfidenz und Verteilung |
Der entscheidende Vorteil für Entwickler: Der Wert ist eine vom Modell berechnete Wahrscheinlichkeit und keine erfundene Aussage wie „Ich bin zu 90 % sicher“, die ein LLM im Flastext generiert. Dadurch lassen sich klare Schwellenwerte implementieren: Liegt der Wert über 0,8, läuft der Prozess vollautomatisch; liegt er darunter, wird der Vorgang einem menschlichen Prüfer zugewiesen.
Einsatzbereiche: Wofür sich Decision Models eignen (und wofür nicht)
Typische Stärken:
- Ticket-Routing - Welche Abteilung ist zuständig, liegt eine Eskalation vor, welche Sprache wird gesprochen, droht eine Kündigung?
- Content-Moderation - Verstösst ein Kommentar gegen Richtlinien, handelt es sich um Spam, ist ein Bild freigabefähig (Clef verarbeitet Bilder)?
- Dokumentenklassifizierung - Belegart, Kostenkategorie, Vorhandensein bestimmter Vertragsklauseln.
- Tool-Auswahl in KI-Agenten - Statt ein grosses LLM zu fragen „Welche Funktion soll aufgerufen werden?“, entscheidet das Decision Model blitzschnell über die Tool-Liste (mehr zum Konzept in unserem Beitrag über Function Calling).
- Guardrails & Gatekeeping - Erfüllt eine Antwort die Kriterien, muss an einen Menschen übergeben werden oder welches Modell soll die Anfrage bearbeiten?
Ungeeignete Szenarien:
- Texte verfassen, zusammenfassen, übersetzen, Chats führen oder Programmcode schreiben - ein Entscheidungsmodell generiert keinen Text.
- Offene Fragen („Was meint der Kunde damit?“) - ohne feste Auswahlliste gibt es keine Berechnungsbasis.
- Mehrstufiges, komplexes Reasoning - die Autoren von Strands Decider weisen ausdrücklich darauf hin, dass das Modell bei komplexen Denkaufgaben deutlich hinter Reasoning-Modellen zurückbleibt.
In der Praxis arbeiten Decision Models meist Hand in Hand mit LLMs: Das kleine Modell trifft Hunderte schnelle Vorabentscheidungen, während das grosse Modell nur dort generiert, wo Textausgabe unverzichtbar ist. Wie eine solche Architektur im Detail aufgebaut wird, zeigt der Leitfaden KI-Agenten von Grund auf entwickeln.
Verfügbare Decision Models im Überblick
| Modell | Entwickler | Grösse und Basis | Lizenz | Verfügbarkeit |
|---|---|---|---|---|
| Jev | TypeSafe | Nicht angegeben | Proprietär (Closed Weights) | API TypeSafe (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + Joint Schema Head | Apache-2.0 | Workers AI, Hugging Face (55 GB) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + Joint Schema Head | Apache-2.0 | Workers AI, Hugging Face (19 GB) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + Pointer Head | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/3.8) | Apache-2.0 | Hugging Face, GitHub |
| Aplomb 1 | EmpirioLabs | 5,3B, Qwen3.5-4B | EmpirioLabs Model License 1.0 (kostenlos u. a. für interne Nutzung bei < 1 Mio. USD Umsatz) | Hugging Face (Gated), API EmpirioLabs |
| Decisions API | OpenAI | Luna-Modell | Proprietär | Eingeschränkte Preview, keine Preise |
Clef, Clef-flash, Strands Decider und Kev folgen der System-One-API von Jev (POST /v1/systemone mit den Feldern state und questions). Derselbe Client-Code funktioniert übergreifend - lediglich Endpunkt und Modellname müssen angepasst werden. Aplomb 1 nutzt den Endpunkt POST /v1/decisions und bietet Kompatibilität mit Chat-Formaten von OpenAI, Anthropic und Gemini. Details zur Decisions API von OpenAI finden Sie im Artikel zur Agents API.
Cloudflare Clef und Clef-flash
Clef nutzt ein eingefrorenes Qwen-Backbone, verarbeitet den Input in einem einzigen Durchlauf (reiner Prefill) und übergibt die Hidden States an einen sogenannten Joint Schema Head. Dieses Modul bewertet sämtliche Optionen aller Fragen gleichzeitig und kann Querbeziehungen zwischen Fragen herstellen. Nach Angaben von Cloudflare ist es das erste Modell dieser Architektur mit Bild-Encoder und einem Kontextfenster von 64.000 Token. Hintergründe und Benchmarks finden Sie im News-Artikel zu Cloudflare Clef sowie im Firmenporträt über Cloudflare.
Amazon Strands Decider 2B
Das kompakteste Modell: AWS entfernt bei Qwen3.5-2B-Base den Language Head und ersetzt ihn durch einen Pointer Head mit knapp über einer Million Parametern, ergänzt um einen LoRA-Adapter (Rank 16). Auf Hugging Face steht der Checkpoint strands-decider-2B-hobson-v19 inklusive Trainingsdaten bereit. Der Latenz-Median liegt laut Hersteller bei rund 115 ms auf einer RTX 3090 und 153 ms auf einem Apple MacBook mit M3-Chip. Im JevBench-Benchmark erreichte das Modell 167 von 231 Aufgaben (72,3 %).
Kev 1.0
Kev stammt von Jared Palmer (bekannt durch Formik und Turborepo): vier Modellgrössen von 0,8B bis 27B, LoRA und Pointer Head auf Qwen-Basis unter Apache-2.0. Dank System-One-Kompatibilität greifen SDKs von TypeSafe nahtlos darauf zu. Das Modell wurde jedoch ausschliesslich auf englischen Datensätzen trainiert und validiert; die 9B-Version belegt laut Model Card etwa 22 GB Grafikspeicher.
EmpirioLabs Aplomb 1
Aplomb 1 (veröffentlicht am 29. September 2026, Dokumentationsstand 5./6. Oktober) verarbeitet Text, JSON, bis zu 16 Bilder, 8 Audiodateien und 4 Videos in einem Request bei 1 Mio. Token Kontext. Die 5,3 Milliarden Parameter basieren auf Qwen3.5-4B und benötigen rund 12 GB VRAM in bf16. Neben den Standardtypen unterstützt Aplomb 1 den Fragetyp tool zur Funktionsauswahl mit Wahrscheinlichkeitsverteilungen für Argumente.
- Hersteller-Benchmarks: 44,86 Punkte im Decision Index 0.2.1 (interner Lauf von EmpirioLabs am 5.10., kein offizielles Board-Listing); Bildverarbeitung: POPE 89,0, MMStar 68,6, AI2D 87,0.
- Audio: Einziges Modell im Vergleich mit nativer Audioverarbeitung (z. B. 91,9 % bei Stimmerkennung).
- Lizenz: Keine Apache-2.0-Lizenz. Kostenfrei für Forschung, Bildung und interne Nutzung in Unternehmen mit unter 1 Mio. USD Jahresumsatz. Grössere Unternehmen und Hosting-Dienstleister benötigen eine kommerzielle Lizenz.
- API-Preise: ca. 0,018 EUR (0,02 USD) pro Million Input-Token, Output kostenfrei (Umrechnungskurs: 1 EUR = 1,1181 USD, EZB vom 12.10.2026).
Weitere Details zu Benchmarks und Lizenzbedingungen beschreibt der Bericht zu EmpirioLabs Aplomb 1.
Preise und Hardware-Anforderungen
| Modell | Hosting | Preis | Lokaler Betrieb |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef |
ca. 0,21 EUR (0,24 USD) / Mio. Input-Token | 55 GB Gewichte in bf16; auf 24 GB VRAM nur quantisiert lauffähig (kein offizielles File) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash |
ca. 0,08 EUR (0,09 USD) / Mio. Input-Token | 19 GB Gewichte; gemessener Peak: 18,3 GB VRAM |
| Strands Decider 2B | Kein Direkt-Hosting, eigener Server | 0 USD (nur Infrastrukturkosten) | 4,4 GB Download; gemessen 3,8 GB VRAM; läuft auch auf CPU/Mac |
| Kev-9B | Kein Direkt-Hosting | 0 USD | ca. 22 GB VRAM laut Entwickler |
| Aplomb 1 | API EmpirioLabs | ca. 0,018 EUR (0,02 USD) / Mio. Input-Token, Output frei | ca. 12 GB in bf16 laut Dokumentation |
| Jev | API TypeSafe | ca. 0,038 EUR (0,042 USD) / Mio. Input-Token, Output frei | Nicht lokal verfügbar |
Cloudflare Workers AI bietet ein tägliches Kontingent von 10.000 „Neuronen“ in Free- und Paid-Tarifen. Clef verbraucht 21.818 Neuronen pro Million Input-Token, Clef-flash 8.182. Das ermöglicht täglich rund 458.000 Token bei Clef bzw. 1,2 Millionen Token bei Clef-flash im kostenfreien Rahmen (Stand der Umrechnung: 1 EUR = 1,1181 USD, EZB-Referenzkurs vom 12.10.2026). Ein kurzes Support-Ticket mit zwei Fragestellungen umfasst etwa 150 bis 250 Token.
Praxis-Test: 30 Support-Tickets auf einer RTX 4090
Für den Test wurden 30 Kundensupport-Tickets aus dem E-Commerce- und SaaS-Bereich zusammengestellt: Zahlungen, Versand, Retouren, Benutzerkonten, Störungen und Vertrieb (jeweils 5 Tickets). Der Test wurde mit polnischsprachigen Originaldaten durchgeführt, teilweise absichtlich ohne diakritische Zeichen, mit Tippfehlern oder mit Überschneidungen zwischen Abteilungen. Jedes Modell sollte die zuständige Abteilung (6 Optionen) sowie die Dringlichkeit (Bearbeitung noch heute erforderlich: Ja/Nein) bestimmen. Die Decision Models wurden über ihre native API angesprochen, klassische LLMs via Ollama oder OpenRouter mit striktem JSON-Schema (Temperature 0).
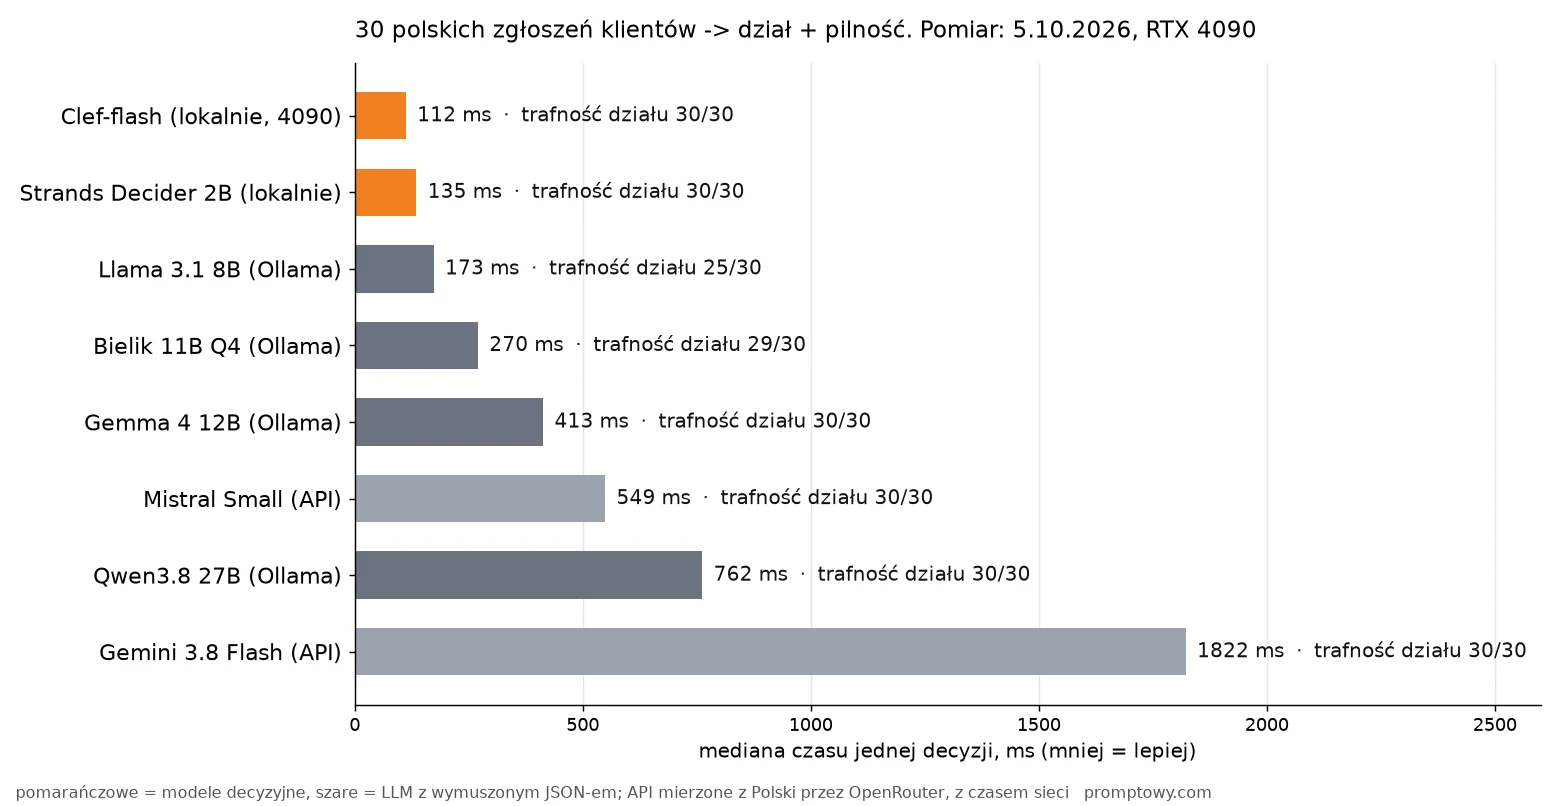
| Modell | Abteilung (Treffer) | Dringlichkeit (Treffer) | Latenz (Median) | Speicherbedarf |
|---|---|---|---|---|
| Clef-flash (lokal) | 30/30 | 26/30 (28/30 bei Schwelle 0,95) | 112 ms | 18,3 GB VRAM |
| Strands Decider 2B (lokal) | 30/30 | 24/30 (26/30 bei Schwelle 0,4) | 135 ms | 3,8 GB VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | 4,9 GB Dateigrösse |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | 6,7 GB Dateigrösse |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | 7,0 GB Dateigrösse |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | 16 GB Dateigrösse |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Erkenntnisse aus der Testreihe:
- Die reine Abteilungsauswahl forderte die Modelle kaum: 6 von 8 Modellen erreichten 30/30 Treffer. Lediglich Llama 3.1 8B fiel mit 25/30 ab (Verwechslungen bei Rechnungen und Hardware-Reklamationen).
- Enormer Geschwindigkeitsvorteil: Clef-flash agierte auf derselben Hardware 3,7-mal schneller als Gemma 4 12B und fast 7-mal schneller als Qwen3.8 27B. Diese Werte wurden ohne spezialisierte Flash-Attention-Kernel unter Windows erzielt (transformers berechnete die linearen Attention-Layer im Standardmodus).
- Schwellenwerte erfordern Feintuning: Strands Decider neigte im Test zu vorsichtigen Wahrscheinlichkeitswerten bei der Dringlichkeit: Kein Ticket überschritt den Standard-Schwellenwert von 0,5. Bei einer angepassten Schwelle von 0,4 stieg die Genauigkeit auf 26/30. Clef-flash zeigte das umgekehrte Verhalten: Bei 0,5 traten 4 Fehlalarme auf, bei einer Schwelle von 0,95 blieben nur 2 Fehler.
- Mehrsprachigkeit gegeben: Obwohl primär auf englischen Daten trainiert, verarbeiteten die Modelle die polnischen Tickets zuverlässig. Ein Gegencheck der übersetzten Texte ins Englische brachte identische Ergebnisse: Clef-flash und Strands erreichten jeweils 29/30 Treffer (beide strauchelten an einem Tarifwechsel innerhalb des Abrechnungszeitraums).
- Dringlichkeit bleibt Ermessenssache: 6 Fälle waren a priori als dringend eingestuft (z. B. 502-Serverausfall, Kontokompromittierung). Fast alle Modelle stuften zusätzlich eine fehlgeschlagene Sofortüberweisung als dringend ein - eine betriebswirtschaftlich nachvollziehbare Entscheidung.
Die API-Kosten beliefen sich auf ca. 0,036 EUR (0,04 USD) für 180 Anfragen an Mistral und Gemini via OpenRouter (EZB-Referenzkurs vom 12.10.2026: 1 EUR = 1,1181 USD). Bei Gemini 3.8 Flash liess sich das interne Reasoning nicht komplett deaktivieren, was die Latenz von 1,8 Sekunden erklärt.
Warum Clef 27B und Kev nicht lokal im Test liefen
- Clef 27B belegt 55 GB in bf16. Auf 24 GB VRAM passt das Modell ohne Quantisierung nicht. Da Cloudflare eigene Modellköpfe einsetzt (
joint_schema_model.py), lässt sich das Modell nicht ohne Weiteres über Ollama oder GGUF-Pipelines in llama.cpp laden. - Kev-9B setzt den Download der Basis Qwen3.5-9B-Base voraus (zusätzliche 19 GB), während der Autor das Modell explizit nur für englische Eingaben ausweist.
- Workers AI erfordert einen Cloudflare-Account, worauf für diesen rein lokalen Benchmark verzichtet wurde.
Decision Models vs. LLM mit Structured Output
Klassische LLMs können strukturierte Ausgaben über JSON-Schemata erzwingen (Details hierzu im Artikel Structured Output: JSON-Antworten steuern). Die Ansätze unterscheiden sich jedoch grundlegend:
| Kriterium | Decision Model | LLM + Structured Output |
|---|---|---|
| Ungültige Optionen | Strukturell unmöglich | Durch striktes Schema selten, JSON-Parser kann dennoch scheitern (siehe Fehlerhafte JSON-Ausgaben) |
| Konfidenz | Echte Wahrscheinlichkeitsverteilung | Nicht vorhanden oder vom Modell rein sprachlich generiert |
| Parallele Fragen | Kaum zusätzliche Rechenzeit | Jedes Ausgabefeld erfordert zusätzliche Token-Generierung |
| Begründung | Keine Ausgabe möglich | Kann Erläuterungen generieren |
| Komplexes Reasoning | Eingeschränkt | Deutlich überlegen, insbesondere Reasoning-Modelle |
| Cloud-Kosten | Abrechnung rein nach Input | Input + Output (+ Denk-Token) |
Faustregel für Architekturen: Wenn die Antwort aus einer festen Liste stammt und hohe Transaktionsvolumina anfallen, sind Decision Models die wirtschaftlichere und schnellere Wahl. Werden Argumentationen oder mehrstufige Ableitungen benötigt, bleibt das klassische LLM gesetzt. Ideal ist ein zweistufiger Ansatz: Das Entscheidungsmodell filtert eindeutige Fälle ab; Zweifelsfälle unterhalb des Schwellenwerts wandern an ein grosses Modell oder den menschlichen Support.
Schnellstart: Lokale Ausführung in 10 Minuten
- Python 3.10+ sowie PyTorch mit CUDA-Unterstützung installieren (CPU-Betrieb funktioniert ebenfalls).
- Paket installieren:
pip install strands-decider(ca. 4,4 GB Download). - CLI-Test ausführen (nachfolgend ein deutsches Anwendungsbeispiel, übersetzt aus dem polnischen Originaltest):
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 --state "Sie haben den Monatsbeitrag doppelt von meinem Konto abgebucht" --choice "Welche Abteilung?=zahlungen,lieferung,retoure,konto,stoerung,vertrieb" --noul "Ist das Anliegen dringend?" - HTTP-Server starten (
strands-decider serve ... --port 8000) und Anfragen im System-One-Format absetzen. Der interne Server lauscht auf 127.0.0.1 ohne Authentifizierung - für den Produktivbetrieb ist ein Reverse Proxy erforderlich. - Bei 24 GB VRAM lässt sich Clef-flash nutzen:
snapshot_download("Cloudflare/clef-flash")laden und über die bereitgestelltesystemone()-Routine ansprechen.
Ohne lokale GPU bieten sich Workers AI oder die TypeSafe-API an. Wer Modelle über Ollama ausführt, bleibt auf generative LLMs beschränkt, da Decision Models spezifische Architekturen innerhalb von transformers erfordern.
Für wen lohnt sich der Einsatz?
- Empfohlen für: Support-Teams und E-Commerce-Plattformen mit automatisiertem Ticket-Routing; Agenten-Pipelines mit hohem Aufkommen an Verzweigungslogik; Bild- und Textmoderation; Workflows, die bisher teure LLMs nur für Ja/Nein-Entscheidungen nutzen.
- Nicht empfohlen für: Anwendungsfälle, die Freitext, Chat-Interaktionen oder Code-Erzeugung verlangen; Systeme mit nur wenigen Anfragen pro Tag; Projekte ohne Datengrundlage zur Kalibrierung eigener Schwellenwerte.
Häufige Fragen (FAQ)
Was zeichnet ein KI-Decision-Model aus?
Es generiert keinen Flasstext, sondern berechnet Wahrscheinlichkeitsverteilungen für vorgegebene Antwortoptionen. Es unterstützt primär drei Fragetypen: Einfachauswahl (Choice), Ja/Nein-Abfragen (Noul) und Skalenbewertungen (Score).
Was ist Cloudflare Clef?
Eine offene Modellfamilie von Cloudflare, bestehend aus Clef (27B auf Qwen3.8-27B) und Clef-flash (9B auf Qwen3.5-9B). Beide Modelle stehen unter Apache-2.0 auf Hugging Face bereit, laufen auf Workers AI und unterstützen multimodale Inputs (Text, JSON, Bilder, Videos) bei 64.000 Token Kontext.
Ist die Nutzung von Clef kostenfrei?
Die Modellgewichte sind unter Apache-2.0 frei verfügbar. Auf Cloudflare Workers AI fallen ca. 0,21 EUR (0,24 USD) für Clef bzw. ca. 0,08 EUR (0,09 USD) für Clef-flash pro Million Input-Token an (EZB-Referenzkurs vom 12.10.2026: 1 EUR = 1,1181 USD). Das tägliche Gratis-Kontingent der Plattform deckt hunderttausende Token ab.
Funktionieren die Modelle mit anderen Sprachen ausser Englisch?
Im Praxistest arbeiteten Clef-flash und Strands Decider 2B auch auf nicht-englischen Texten zuverlässig und erreichten 30 von 30 Treffern bei der Abteilungsauswahl. Allerdings verschieben sich die Wahrscheinlichkeitsverteilungen je nach Sprache, sodass Schwellenwerte anhand eigener Beispieldaten kalibriert werden müssen. Kev ist rein auf Englisch ausgelegt.
Welche Hardware wird für den lokalen Betrieb benötigt?
Clef-flash belegte im Test 18,3 GB VRAM und läuft auf Grafikkarten wie der RTX 3090, 4090 oder 5090. Das grosse Clef (55 GB) verlangt Beschleuniger der Enterprise-Klasse (z. B. H100) oder Quantisierung. Strands Decider 2B benötigt unter 4 GB VRAM und läuft auch auf CPUs oder Apple-Silicon-Rechnern. Weitere Details finden Sie in der Übersicht VRAM-Bedarf für lokale KI.
Wie unterscheidet sich das Modell von Function Calling?
Function Calling in LLMs umfasst sowohl die Auswahl einer Funktion als auch die Generierung der passenden Argumente. Ein Decision Model übernimmt hochpräzise den ersten Schritt - die Tool-Auswahl -, kann jedoch keine dynamischen Textargumente schreiben. Beide Ansätze lassen sich ideal kombinieren.
Was ist Aplomb 1?
Ein multimodales Entscheidungsmodell von EmpirioLabs (5,3B Parameter) mit 1 Million Token Kontext. Es verarbeitet Text, Audio, Bild und Video und bietet einen spezialisierten Fragetyp zur Tool-Auswahl. Die Gewichte stehen unter einer restriktiven Lizenz; die API liegt bei ca. 0,018 EUR (0,02 USD) pro Million Input-Token (EZB vom 12.10.2026).
Ist Strands Decider für kommerzielle Projekte freigegeben?
Ja. Modell, Trainingsskripte und die Basis Qwen3.5-2B-Base stehen unter der Apache-2.0-Lizenz. Der enthaltene HTTP-Server bietet jedoch keine integrierte Zugriffsverwaltung und sollte produktiv hinter einem API-Gateway betrieben werden.
Welche Rolle spielen Jev und System One?
Jev ist das proprietäre Vorreitermodell von TypeSafe. Das zugehörige API-Protokoll System One definiert die Struktur aus Statuswerten, typisierten Fragen und Wahrscheinlichkeitsantworten, an der sich Clef, Kev und Strands Decider orientieren. Mehr dazu im Bericht über TypeSafe Jev.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Quellen
- Cloudflare: Introducing Clef (1.10.2026)
- Cloudflare/clef und Cloudflare/clef-flash auf Hugging Face
- Preisübersicht Workers AI
- Strands Agents: Introducing Strands Decider 2B (1.10.2026) und Model Card
- Kev auf GitHub und jaredpalmer/kev-9b
- empiriolabsai/aplomb-1 und Dokumentation zu Aplomb 1 (Abruf: 7.10.2026)
- Eigener Hardware-Benchmark: 5. Oktober 2026, RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18, Ollama.
Zuletzt geprüft: 5. Oktober 2026; Angaben zu Aplomb 1 aktualisiert am 7. Oktober 2026.
More on this from WISSNOX