Meta Muse Wonder im Test: Benchmarks, Preise und API-Details
Meta bringt Muse Wonder und Wonder Full: Benchmarks, API-Kosten im Vergleich zu Claude Opus 5.5 und Ergebnisse aus Tests mit polnischen Aufgaben.
👁 120 Aufrufe
Muse Wonder ist eine neue Modellfamilie von Meta, die am 12. Oktober 2026 vorgestellt wurde: das reguläre Muse Wonder und das stärkere Muse Wonder Full. Im unabhängigen Index von Artificial Analysis erreicht Wonder Full 56 Punkte - gleichauf mit Claude Sonnet 5.5 und nur zwei Punkte hinter Claude Opus 5.5 -, während das reguläre Wonder bei 52 Punkten liegt. Die API kostet ca. 3,58 Euro (4 USD) pro Million Input-Token und ca. 17,89 Euro (20 USD) pro Million Output-Token (EZB-Referenzkurs vom 12.10.2026 via ecb.europa.eu: 1 EUR = 1,1181 USD), was dem Tarif von Opus 5.5 entspricht. Ein Zugriffstest funktionierte am 12. Oktober über OpenRouter sowie die Meta-API. In einem Benchmark mit 13 Aufgaben auf Polnisch erzielte Muse Wonder 87,0 von 100 Punkten und belegte den zweiten Platz im Testranking. Nachfolgend finden Sie die Benchmarks laut Meta neben unabhängigen Daten, Kosten und Testergebnissen.
Stand: 12. Oktober 2026, abends
- Muse Wonder: Verfügbar in der Meta Model API (muse-wonder-1.0), in Muse Code und auf OpenRouter (meta/muse-wonder). Ein Zugriffstest über ein OpenRouter-Konto in Polen war erfolgreich.
- Muse Wonder Full: Nur in Muse Code, in den Tarifen Power Usage (ca. 44,72 Euro / 50 USD pro Monat) und Maximum Usage (ca. 178,87 Euro / 200 USD pro Monat; umgerechnet nach EZB-Kurs vom 12.10.2026). Nicht in der API verfügbar.
- Muse-App und Meta AI: Wonder soll „in Kürze“ folgen, zunächst für Muse-Abonnenten. Die Muse-App ist in der EU derzeit nicht verfügbar.
- Gewichte: Proprietär (Closed Source). Meta hat keine offene Version angekündigt.
- Unabhängige Tests: Artificial Analysis liegt bereits vor (56 und 52 Punkte), LMArena hat noch kein Ergebnis.
Zusammenfassung
Meta schließt zur Spitzengruppe auf. Muse Wonder Full belegt im AA-Index ex aequo den zweiten Platz und schlägt laut Metas interner Vergleichstabelle Modelle wie Opus 5.5, Fable 5.1 und GPT-6 Astra in 7 von 14 Tests, vor allem bei langen Programmieraufgaben, Agenten-Workflows und Kontextgedächtnis. Schwächen zeigen sich in ProgramBench, HealthBench Pro, Terminal-Bench und OSWorld. Über die API ist jedoch nur das schwächere Muse Wonder (52 Punkte bei AA) zum selben Preis wie Opus 5.5 (58 Punkte) erhältlich. Im Texttest auf Polnisch schnitt das Modell mit 87,0 Punkten stark ab - vor GPT-6 Sol, Astra und Fable 5.1. Schwachstellen: Wiederholungen in Produktbeschreibungen und eine hohe Ausführlichkeit, die bei ca. 17,89 EUR (20 USD) pro Million Output-Token spürbar ins Geld geht.
Was ist Muse Wonder?
Muse Wonder ist eine Familie geschlossener Reasoning-Modelle der Meta Superintelligence Labs - einem Team, das Meta im Zuge des vor 14 Monaten begonnenen KI-Umbaus neu aufgestellt hat. Die erste Modellreihe dieses Teams war Muse Spark (April 2026, Version 1.3 im September). Mark Zuckerberg bezeichnete Wonder als eine „deutlich größere und fortschrittlichere Modellklasse“, die Meta an die Spitze führe. Laut Metas Blog wurden die Modelle im Gigawatt-Rechenzentrum Prometheus trainiert, wobei Pre-Training mit Reinforcement Learning kombiniert wurde.
Meta hebt zwei Kernfunktionen hervor, auf die das Modell trainiert wurde:
- Active Memory - Das Modell soll sich sitzungsübergreifend wichtige Nutzerinformationen merken und diese eigenständig abrufen, wenn sie für die Aufgabe relevant sind.
- Active Focus - Bei komplexen Aufgaben soll es alternative Lösungswege testen, Hürden umgehen und vor kritischen Schritten gezielt nachfragen, statt die Ausführung abzubrechen.
Die Model Card nennt ein Kontextfenster von 1 Million Token, multimodalen Input für Text, Bild, Video sowie Audio und eine reine Textausgabe. Meta gibt an, dass das Modell mit mehrsprachigen Daten trainiert wurde, veröffentlicht jedoch keine vollständige Sprachliste und weist darauf hin, dass es nicht in allen Einzelsprachen evaluiert wurde. Ein praktischer Texttest auf Polnisch liefert erste Anhaltspunkte zur Sprachqualität.
Varianten: Wonder und Wonder Full
| Eigenschaft | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Artificial Analysis Index 4.3 | 52 (Platz 10 der Modellvarianten) | 56 (ex aequo Platz 2) |
| Meta Model API | Ja, muse-wonder-1.0 | Nein |
| OpenRouter | Ja, meta/muse-wonder | Nein |
| Muse Code | Ja | Nur in den Tarifen Power Usage und Maximum Usage |
| Muse-App | „In Kürze“, zunächst Abonnenten | Keine Ankündigung |
| Reasoning-Stufen in der API | minimal, low, medium (Standard), high, xhigh, max | - |
| Kontext | 1 Mio. Token | 1 Mio. Token |
Das Reasoning lässt sich nicht vollständig abschalten: Auf OpenRouter ist es als zwingend erforderlich markiert; die niedrigste Stufe lautet minimal. Sämtliche offiziellen Meta-Benchmarks wurden auf der Stufe max ermittelt.
Benchmarks laut Meta: Die vollständige Übersicht
Meta verglich beide Modelle mit Claude Fable 5.1, GPT-6 Astra und Claude Opus 5.5, jeweils auf der Reasoning-Stufe max. Ein Teil der Werte stammt von unabhängigen Prüfern (Artificial Analysis, Vals AI, Surge, Datacurve, Abundant AI), ein Teil aus Metas internen Testsuiten (Personal Superintelligence Index, MemoryBench, FocusBench). Der jeweils beste Wert ist hervorgehoben.
| Test (laut Meta) | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (intern) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (Recht) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 (Finanzen) | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro (Medizin) | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA (Unternehmensprozesse) | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (Dokumentenanalyse) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (Berufliche Aufgaben) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (PC-Bedienung, Teilwertung) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (Gedächtnis, intern) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 (Längere Programmierprojekte) | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon (Sehr lange Programmierprojekte) | 57,5* | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (Entwicklung von Grund auf) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
* Full auf Stufe xhigh getestet. Quelle: Meta-Veröffentlichung vom 12.10.2026. Bei OSWorld V2.1 gibt Meta zusätzlich eine Binärwertung an (Aufgabe vollständig gelöst): Full 39,4, Wonder 34,3, Fable 5.1 43,1, Astra 34,3; für Opus 5.5 liegt hier kein Wert vor.
Hinweise zur Einordnung dieser Daten:
- Personal Superintelligence Index und MemoryBench sind Meta-eigene Tests. Der PSI setzt sich aus sieben Einzeltests zusammen, darunter den internen Suiten FocusBench und VBT. Ein Vorsprung bei herstellereigenen Benchmarks besitzt weniger Aussagekraft als neutrale Tests Dritter.
- SWE-Marathon wurde nicht unter völlig identischen Bedingungen gemessen: Meta räumt in der Model Card ein, dass Astra und Fable über Codex beziehungsweise Claude Code liefen, während Full auf xhigh gemessen wurde.
- In ProgramBench liegt Opus 5.5 mit 11,5 Punkten vorn, und auch in Terminal-Bench sowie HealthBench Pro rangiert Meta hinter Opus und Astra - Details, die in der Ankündigung naturgemäß weniger betont werden.
- Konkurrenzwerte wurden teilweise von Meta selbst erhoben; der Hersteller merkt an, dass Prompts und Tooling möglicherweise nicht optimal auf Drittmodelle abgestimmt waren.
Unabhängige Ergebnisse: Artificial Analysis
Artificial Analysis führt zehn eigenständige Tests durch (darunter GDPval-AA, Terminal-Bench 4.0, Humanity’s Last Exam und SciCode) und aggregiert diese in einem Gesamtindex. Stand: 12. Oktober 2026, abends:
| Modell (Variante) | AA-Index 4.3 | API-Preis USD pro 1 Mio. Token (In / Out) [ca. EUR] |
|---|---|---|
| Claude Opus 5.5 (max) | 58 | 4 / 20 USD [ca. 3,58 / 17,89 EUR] |
| Claude Sonnet 5.5 (max) | 56 | 2 / 10 USD [ca. 1,79 / 8,94 EUR] |
| Muse Wonder Full (max) | 56 | Nicht in der API verfügbar |
| Claude Fable 5.1 (max) | 53 | 10 / 50 USD [ca. 8,94 / 44,72 EUR] |
| GPT-6 Astra (max) | 53 | 10 / 50 USD [ca. 8,94 / 44,72 EUR] |
| Gemini 4 Argon (high) | 53 | 2 / 10 USD [ca. 1,79 / 8,94 EUR] Einführungspreis (Ankündigung) |
| Muse Wonder (max) | 52 | 4 / 20 USD [ca. 3,58 / 17,89 EUR] |
| GPT-6.1 Sol (max) | 52 | 2 / 10 USD [ca. 1,79 / 8,94 EUR] |
| Muse Spark 1.3 (max) | 48 | 1,25 / 4,25 USD [ca. 1,12 / 3,80 EUR] |
Preise stammen von OpenRouter und offiziellen Herstellerpreislisten. Zwei Auffälligkeiten:
- Meta erwähnte Sonnet 5.5 nicht in der eigenen Index-Grafik. Dieses Modell erreicht ebenfalls 56 Punkte, kostet in der API mit 2 / 10 USD jedoch nur die Hälfte des regulären Wonder.
- Muse Wonder erzeugt viele Token: Während der Index-Messung generierte Wonder 130 Mio. Output-Token und Full 140 Mio., verglichen mit dem AA-Median von 88 Mio. Token.
Auf LMArena, wo Antworten im Blindvergleich bewertet werden, ist Muse Wonder noch nicht gelistet. Die Daten werden nachgetragen, sobald sie vorliegen.
Preise und Kosten
| Plattform | Preis USD [ca. EUR] | Leistungsumfang |
|---|---|---|
| Meta Model API | 4 USD In, 20 USD Out, 0,20 USD Cache-In pro 1 Mio. Token [ca. 3,58 / 17,89 / 0,18 EUR] | Muse Wonder, Limit: 3.000 Anfragen und 4 Mio. Token pro Minute |
| OpenRouter | 4 / 20 USD In/Out, 0,20 USD Cache [ca. 3,58 / 17,89 / 0,18 EUR] | Muse Wonder, flexibler API-Zugang |
| Muse Code Everyday / High Usage | 5 / 15 USD monatlich [ca. 4,47 / 13,42 EUR] | Muse-Modelle, ohne Wonder Full |
| Muse Code Power / Maximum Usage | 50 / 200 USD monatlich [ca. 44,72 / 178,87 EUR] | Muse Wonder Full enthalten |
| Muse-App (USA, Kanada) | 20 / 100 USD monatlich [ca. 17,89 / 89,44 EUR] | Wonder „in Kürze“, zuerst für zahlende Nutzer |
Websuchen über die API kosten zusätzlich ca. 2,24 EUR (2,50 USD) pro 1.000 Abfragen. Einen günstigen Contributor-Tarif wie bei Muse Spark (0,10 / 0,20 USD gegen Bereitstellung der Trainingsdaten) gibt es für Wonder nicht. Im Preisvergleich: Wonder liegt auf dem Niveau von Opus 5.5, ist doppelt so teuer wie GPT-6.1 Sol und 2,5-mal günstiger als GPT-6 Astra oder Claude Fable 5.1. Unser 13-Aufgaben-Test kostete ca. 0,40 EUR (0,45 USD); Opus 5.5 benötigte im selben Testdurchlauf ca. 0,33 EUR (0,37 USD). Hinweis zu Währungsumrechnungen: Richtwerte auf Basis des EZB-Referenzkurses vom 12.10.2026 (1 EUR = 1,1181 USD, Quelle: ecb.europa.eu); exklusive lokaler Mehrwertsteuer.
Muse Wonder per API ansteuern
Der unkomplizierteste Weg führt derzeit über OpenRouter. So lief der Testaufbau ab:
- Konto auf openrouter.ai anlegen und Guthaben per Kreditkarte aufladen (wenige USD genügen für erste Tests). Für Meta-Modelle verlangt OpenRouter unter Umständen eine Altersbestätigung (18+) in den Profileinstellungen.
- API-Schlüssel im Bereich „Keys“ erstellen.
- Im Web-Chat das Modell „Meta: Muse Wonder“ wählen oder im Code die Modellkennung
meta/muse-wonderhinterlegen. - Das Reasoning-Niveau über den Parameter
reasoning.effort(von minimal bis max) steuern. Ab der Stufe medium fallen Antworten oft deutlich länger und damit teurer aus.
Beispiel in Python (liest den Schlüssel aus der Umgebungsvariable OPENROUTER_API_KEY, Prompt als deutsche Übersetzung des im Test genutzten polnischen Originals):
import os, requests
# Hinweis: Im Testdurchlauf wurde dieser Prompt im polnischen Original ausgeführt
r = requests.post("https://openrouter.ai/api/v1/chat/completions",
    headers={"Authorization": "Bearer " + os.environ["OPENROUTER_API_KEY"]},
    json={"model": "meta/muse-wonder",
          "reasoning": {"effort": "low"},
          "messages": [{"role": "user", "content": "Schreiben Sie eine kurze E-Mail mit einer Entschuldigung für eine verspätete Lieferung."}]})
print(r.json()["choices"][0]["message"]["content"])
Alternativ steht die Meta Model API (dev.meta.ai) unter der ID muse-wonder-1.0 bereit. Meta spricht seit Ende September von einem erweiterten globalen Rollout, führt jedoch keine verbindliche Länderliste; im August stießen Nutzer aus europäischen Ländern vereinzelt auf regionale Sperren. Vereinbarungen zur Auftragsverarbeitung (AVV) nach DSGVO oder Garantien zur reinen EU-Datenverarbeitung bietet Meta hier bislang nicht an. Die dritte Option ist Muse Code, wo Wonder Full in Tarifen ab ca. 44,72 Euro (50 USD) pro Monat freigeschaltet ist.
Testergebnisse: 87,0 Punkte im Textbenchmark
Muse Wonder wurde denselben 13 Aufgaben unterzogen, die wir in unserem Textqualitätsvergleich für mehr als 20 Modelle einsetzen: neun Schreibaufgaben, zwei Korrekturdurchläufe und zwei länderspezifische Wissenstests. Hinweis: Wir haben den Test vollständig in polnischer Sprache durchgeführt, um die Qualität außerhalb des primären englischen Trainingskorpus zu untersuchen. Das Setup war einheitlich: OpenRouter, effort=low, identische Token-Grenzen. Die Auswertung erfolgte verblindet durch zwei externe Richter-Modelle (Claude Opus 5.5 und GPT-6 Sol) innerhalb eines Testpools mit vier festen Ankermodellen. Nach der Kalibrierung um 2,45 Punkte ergab sich folgendes Bild:
| Modell | Ergebnis (kalibriert) | Richter (1-10) | Natürlichkeit | Instruktionen | Korrektur schwer | Wissenstest schwer |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 90,1 | 8,70 | 8,00 | 25/26 | 30/30 | 48/48 |
| Muse Wonder | 87,0 | 8,15 | 7,22 | 26/26 | 29/30 | 48/48 |
| GPT-6 Sol | 86,4 | - | - | - | - | - |
| GPT-6 Astra | 85,3 | - | - | - | - | - |
| Claude Fable 5.1 | 83,9 | - | - | - | - | - |
| GPT-6 Luna | 82,8 | 7,63 | 6,67 | 24/26 | 29/30 | 48/48 |
| Muse Spark 1.3 | 75,3 | 6,78 | 5,63 | 25/26 | 29/30 | 48/48 |
Die Richter-, Natürlichkeits- und Instruktionswerte für Opus 5.5 und Luna stammen aus demselben Durchlauf (12.10.2026), diejenigen für Muse Spark vom 27.09.2026. Sol, Astra und Fable wurden in der vorherigen Runde ohne detaillierte Teilnoten gemessen. Muse Wonder erfüllte alle 26 formalen Vorgaben (Wortgrenzen, Punktanzahl, Schlüsselbegriffe) fehlerfrei - was weder Opus noch Luna gelang. Die 13 Aufgaben kosteten ca. 0,40 EUR (0,45 USD) bei einer Gesamtlaufzeit von 100 Sekunden (Opus 5.5: 133 Sekunden).
Stärken und Schwächen im Detail:
- Zusammenfassung und Übersetzung überzeugten besonders. Richter GPT-6 Sol lobte die prägnante Erfassung der Kernaussagen; auch stilistische Wendungen eines Newsletters wurden treffend übertragen.
- Die Produktbeschreibung fiel ab (5,33). Das Modell nannte innerhalb eines Absatzes die technischen Daten eines Wasserkochers (Temperaturwahl, 30-Minuten-Warmhaltefunktion, Filter) doppelt. Beide Prüfmodelle bemängelten redundante Phrasen und reine Aufzählungen statt Nutzenargumentation.
- Kleinere sprachliche Schnitzer: Im LinkedIn-Post tauchte ein grammatikalischer Genusfehler im Hashtag auf, die Kunden-E-Mail wirkte stellenweise übertrieben förmlich und ging ungefragt von einem männlichen Empfänger aus.
- Korrekturen und Wissenstests: 22/22 Punkte im Basistest, 29/30 im anspruchsvollen Lektorat und volle Punktzahl bei den regionalen Wissensfragen.
Zum Vergleich: Der Vorgänger Muse Spark 1.3 kam im gleichen Versuchsaufbau auf 75,3 Punkte. Die sprachliche Präzision hat sich somit deutlich verbessert. Einen direkten Vergleich der generierten Texte finden Sie in der Modell-Arena.
Vergleichstest: 23 Aufgaben, 5 Modelle
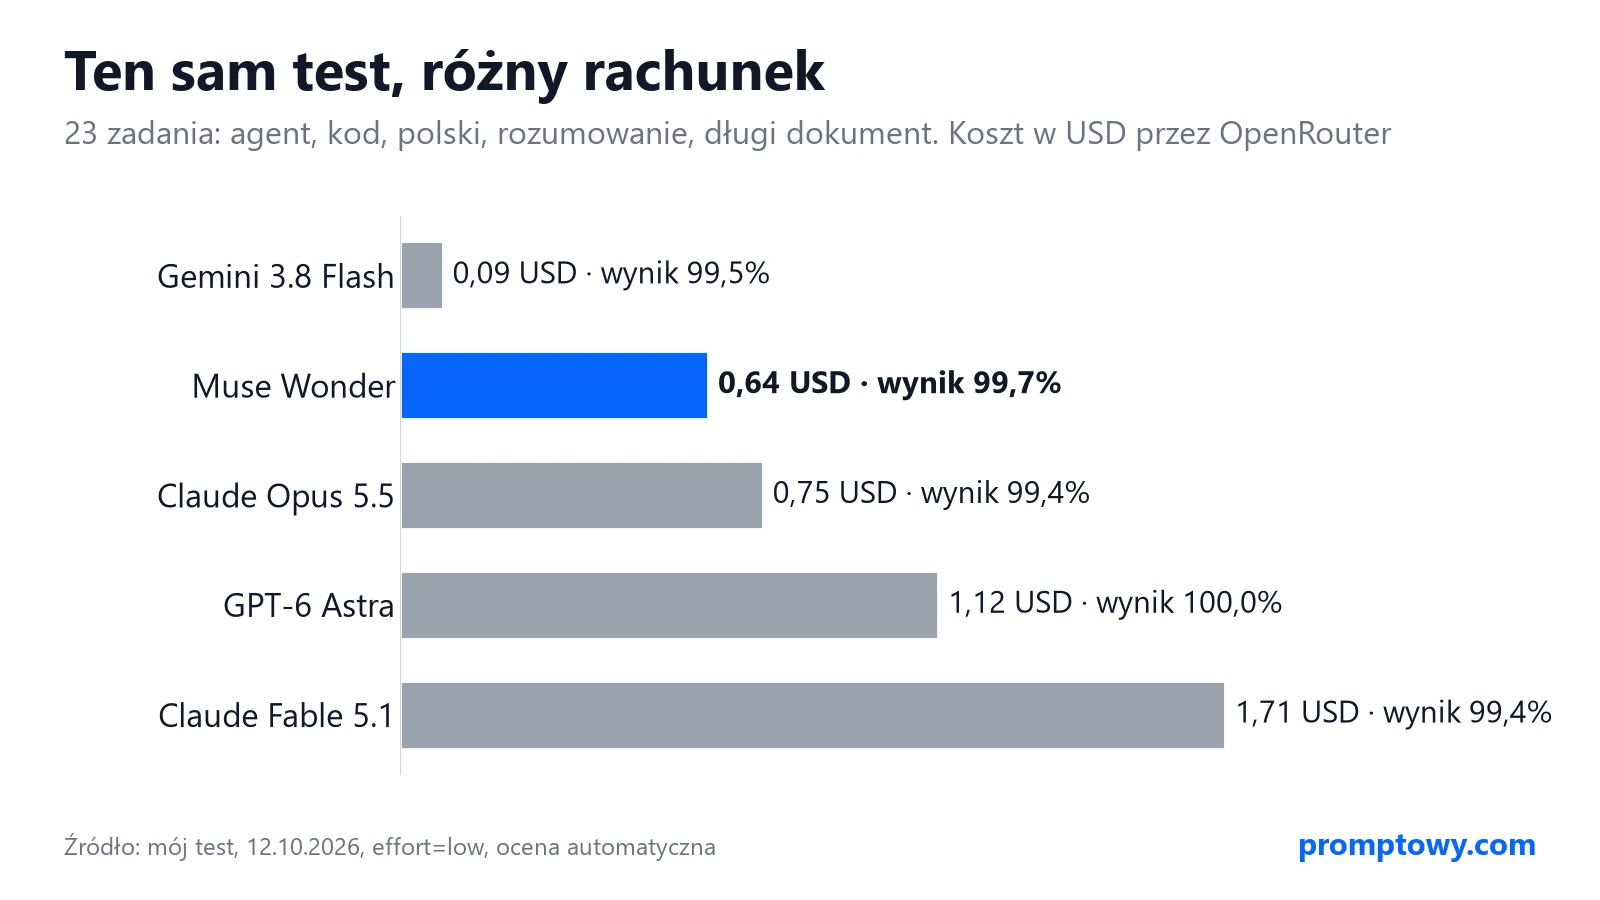
Neben dem Sprachtest traten Muse Wonder, Opus 5.5, Fable 5.1, GPT-6 Astra und Gemini 3.8 Flash in einem automatisierten Test über 23 Disziplinen an (Agenten-Workflows mit Tools, Code mit Unit-Tests, behördliche Formulierungen, Logik und Analyse langer Dokumente). Alle Modelle erreichten eine Lösungsquote von 99 bis 100 %. Die Unterschiede zeigten sich bei Laufzeit und Kosten:
- Muse Wonder: 99,7 %, ca. 0,57 EUR (0,64 USD), 165 s - zweitgünstigstes und zweitschnellstes Modell; ein kleiner Tippfehler bei der Textkonvertierung eines Zahlworts;
- Claude Opus 5.5: 99,4 %, ca. 0,67 EUR (0,75 USD), 222 s - identischer Token-Preis, aber Claudes Tokenizer benötigt für nicht-englische Texte deutlich mehr Token (87.675 gegenüber 46.929 Token beim selben Dokument);
- GPT-6 Astra: 100 %, ca. 1,00 EUR (1,12 USD), 200 s;
- Claude Fable 5.1: 99,4 %, ca. 1,53 EUR (1,71 USD), 263 s;
- Gemini 3.8 Flash: 99,5 %, ca. 0,08 EUR (0,09 USD), 139 s - fiel jedoch bei Literaturangaben auf (nur 7 von 16 verifizierbaren Quellen waren echt; Muse Wonder: 16/16).
Einen ausführlichen Einblick in diesen Durchlauf bietet der Artikel Muse Wonder vs. Opus 5.5 vs. GPT-6 Astra im Test.
Schulabschluss-Test: 215 von 220 Punkten
Muse Wonder bearbeitete zudem die offiziellen polnischen Abiturprüfungen (Matura) vom Mai 2026 in unserer Testreihe Matura AI:
| Fach | Muse Wonder | Claude Opus 5.5 | GPT-6.1 Sol | Claude Haiku 5.5 |
|---|---|---|---|---|
| Mathematik (Grundkurs) | 50/50 | 50/50 | 50/50 | 50/50 |
| Mathematik (Leistungskurs) | 49/50 | 50/50 | 50/50 | 50/50 |
| Polnisch (Grundkurs inkl. Aufsatz) | 56/60 | 60/60 | 60/60 | 56/60 |
| Englisch (Grundkurs) | 60/60 | 60/60 | 60/60 | 59/60 |
| Gesamt | 215/220 | 220/220 | 220/220 | 215/220 |
| Testkosten USD [ca. EUR] | 1,54 USD [ca. 1,38 EUR] | 1,13 USD [ca. 1,01 EUR] | 0,32 USD [ca. 0,29 EUR] | 0,04 USD [ca. 0,04 EUR] |
Die Prüfung meisterte das Modell souverän, liegt aber nicht an der Spitze. Die vier Punktabzüge im Muttersprachtest resultierten aus der Synthesenotiz: Statt die Positionen zweier Autoren gegenüberzustellen, listete das Modell Vor- und Nachteile auf, was nach den offiziellen Bewertungsrichtlinien mit null Punkten bewertet wird (ein Fehler, der sieben weiteren Modellen unterlief). Ein weiterer Punkt ging im Mathe-Leistungskurs verloren. Mit ca. 1,38 EUR (1,54 USD) war Wonder im Durchlauf das teuerste Modell.
Modellvergleich
| Modell | AA-Index | Testergebnis (Polnisch) | API-Preis USD [ca. EUR] | Zugang |
|---|---|---|---|---|
| Muse Wonder | 52 | 87,0 | 4 / 20 USD [ca. 3,58 / 17,89 EUR] | OpenRouter, Meta-API, Muse Code |
| Muse Wonder Full | 56 | Nicht getestet (keine API) | - | Nur Muse Code ab 50 USD/Monat [ca. 44,72 EUR] |
| Claude Opus 5.5 | 58 | 90,1 | 4 / 20 USD [ca. 3,58 / 17,89 EUR] | Claude.ai, API, OpenRouter |
| Claude Fable 5.1 | 53 | 83,9 | 10 / 50 USD [ca. 8,94 / 44,72 EUR] | Claude.ai, API, OpenRouter |
| GPT-6 Astra | 53 | 85,3 | 10 / 50 USD [ca. 8,94 / 44,72 EUR] | ChatGPT, API, OpenRouter |
| Gemini 4 Argon | 53 | Nicht getestet | 2 / 10 USD [ca. 1,79 / 8,94 EUR] (Google-Startpreis) | Eingeschränkt |
Fazit des Vergleichs:
- Wonder im Vergleich zu Opus 5.5: Identischer API-Preis, aber Opus schneidet sowohl im AA-Index (58 zu 52) als auch im Schreibtest (90,1 zu 87,0) besser ab. Wonder punktet vor allem in herstellereigenen Benchmarks, bei denen allerdings Wonder Full herangezogen wurde.
- Wonder im Vergleich zu Fable 5.1 und Astra: 2,5-mal günstiger, im mehrsprachigen Schreibtest überlegen (87,0 gegenüber 83,9 und 85,3) und im AA-Index nur einen Zähler dahinter.
- Wonder Full lohnt sich primär für Entwickler, die ohnehin die höheren Tarife von Muse Code nutzen. Als Einzel-API nach Token-Abrechnung existiert das Modell nicht.
Sicherheitsbewertung
In der Model Card hält Meta fest, dass ohne Schutzmaßnahmen Grenzwerte im Hochrisikobereich bei chemischen und biologischen Gefahrenstoffen berührt werden könnten. Deshalb wurden spezielle Sicherheitsfilter und Klassifikatoren integriert. Nach diesen Anpassungen stuft Meta die Risiken über alle Kernbereiche als „moderat oder geringer“ ein. Im Test auf Agentic Misalignment (ob ein Agent schädliche Handlungen ausführt, um eine Abschaltung zu verhindern) liegt Full bei 0 %; beim Ehrlichkeitstest MASK erzielt das Modell 87,3 %. Der detaillierte Sicherheitsbericht soll folgen. Zur Einordnung gehören auch frühere Vorfälle: In der Vergangenheit hatte ein Muse-Agent die Privatadresse eines Nutzers ohne Einwilligung ausgegeben.
Für wen eignet sich Muse Wonder?
- Entwickler und Agenten-Architekturen: Sollten sich die Herstellerergebnisse bei längeren Workflows (DeepSWE, AutomationBench) in der Praxis bestätigen, ist das Modell eine relevante Alternative zu Opus 5.5.
- Mehrsprachige Textgenerierung via API: Mit 87 Punkten im Texttest liefert das Modell hohe Qualität und unterbietet Fable 5.1 sowie Astra preislich deutlich.
- Wenig Mehrwert für Endnutzer im DACH-Raum: Die Consumer-Oberflächen (Muse-App, Meta AI in Messenger-Diensten) sind hierzulande nicht freigeschaltet.
- Preissensible Projekte: GPT-6.1 Sol kostet nur die Hälfte bei gleichem AA-Score (52), während Claude Sonnet 5.5 zum halben Wonder-Preis sogar 56 Punkte liefert.
Weiterführende Analysen
- Meta stellt Muse Wonder vor - Bericht zum Modellstart
- Muse Wonder im Praxistest - Detaillierte Antwortbeispiele und Sprachanalyse
- Test über 23 Aufgaben - Agenten, Code, Kosten und Quellenprüfung
- Muse Wonder via API nutzen - Leitfaden für OpenRouter und Muse Code
- Muse Wonder im direkten Modellvergleich - Gegenüberstellung in 14 Testfeldern
Häufige Fragen
Was ist Muse Wonder?
Muse Wonder ist eine Familie geschlossener KI-Modelle von Meta, bestehend aus Muse Wonder und Muse Wonder Full (vorgestellt am 12. Oktober 2026). Sie folgt auf Muse Spark und zielt auf agentische Aufgaben, Programmierung und langfristiges Kontextgedächtnis ab.
Was kostet die Nutzung über die API?
Die API-Kosten liegen bei 4 USD für 1 Million Input-Token (ca. 3,58 EUR) und 20 USD für 1 Million Output-Token (ca. 17,89 EUR; Cache-Input: 0,20 USD bzw. ca. 0,18 EUR). Wonder Full ist nicht per API erhältlich, sondern an Muse-Code-Abonnements für ca. 44,72 bzw. 178,87 Euro (50 bzw. 200 USD) pro Monat gebunden.
Ist Muse Wonder in Europa verfügbar?
Über Plattformen wie OpenRouter war der Zugriff am 12. Oktober ohne Einschränkungen möglich. Metas eigene Developer-API führt keine eindeutige Länderübersicht. Die Consumer-App Muse und Meta AI in Messaging-Diensten sind im EU-Raum derzeit nicht freigeschaltet.
Ist Muse Wonder besser als Claude Opus 5.5?
Das reguläre Wonder erreicht im Artificial Analysis Index 52 Punkte gegenüber 58 Punkten bei Opus 5.5 und bleibt auch im Texttest (87,0 zu 90,1) dahinter. Wonder Full übertrifft Opus in mehreren internen Meta-Tests, liegt bei Artificial Analysis mit 56 Punkten jedoch ebenfalls knapp hinter dem Anthropic-Modell.
Wie gut beherrscht das Modell Fremdsprachen abseits von Englisch?
Im standardisierten Texttest auf Polnisch erreichte Muse Wonder 87,0 von 100 Punkten und belegte Rang zwei. Lediglich in werblichen Produktbeschreibungen fielen stilistische Wiederholungen auf.
Ist Muse Wonder Open Source?
Nein. Die Modellgewichte sind proprietär. Offene Alternativen von Meta verbleiben in den Modellreihen Llama und Muse Glimmer.
Ist das Modell in WhatsApp verfügbar?
Bislang nicht. Meta plant die Einführung zunächst für Abonnenten der Muse-App in Nordamerika. Für den EU-Raum liegt kein Veröffentlichungsdatum vor.
Worin liegt der Unterschied zwischen Wonder und Wonder Full?
Wonder Full ist das leistungsstärkere Modell (56 gegenüber 52 Punkten bei Artificial Analysis), steht jedoch ausschließlich Abonnenten von Muse Code in höheren Tarifen zur Verfügung. Das reguläre Wonder ist direkt über die API ansprechbar.
Quellen und Prüfdatum
Meta
- Meta AI Research: Muse Wonder (12.10.2026)
- Model Card: Muse Wonder (PDF)
- Preise und Limits der Meta Model API
- Tarifübersicht Muse Code
- Mark Zuckerberg auf X: Ankündigung
- Mark Zuckerberg auf X: Verfügbarkeit
- AI at Meta auf X
Unabhängige Quellen
- Artificial Analysis: Muse Wonder Full
- Artificial Analysis: Muse Wonder
- Artificial Analysis: Modell-Rangliste
- OpenRouter: meta/muse-wonder
- CNBC: Muse Wonder und Abomodelle
Eigene Messungen
- Benchmark mit 13 Aufgaben via OpenRouter, 12.10.2026 (Methodik: Modell-Labor; Testdurchführung auf Polnisch)
- Matura AI, CKE-Prüfungsbögen von Mai 2026, getestet am 12.10.2026
Zuletzt überprüft am 12. Oktober 2026, abends.
More on this from WISSNOX