World Models erklärt: Genie 3, Odyssey, Cosmos und V-JEPA
Was sind World Models in der KI? Wie sich Genie 3, Odyssey-3, Cosmos und V-JEPA von Videogeneratoren unterscheiden - inklusive Test und Physics-IQ.
👁 115 Aufrufe
Ein Weltmodell (World Model) ist eine KI, die weder reinen Text verfasst noch ein fertiges Video ausgibt, sondern vorhersagt, wie sich eine Umgebung nach einer konkreten Aktion verändert. Dadurch lässt sich eine generierte Welt wie in einem Videospiel erkunden, während ein Roboter Handlungen virtuell simulieren kann, bevor er sie physisch ausführt. In dieser Übersicht analysieren wir die wichtigsten Modelle - Genie, Odyssey, Cosmos, V-JEPA und Atlas - inklusive technischer Details, Verfügbarkeit und unserer Testergebnisse.
Stand: 9. Oktober 2026
- Neueste Veröffentlichung: Odyssey-3 (8.10.2026) - kostenlose Web-Vorschau ohne Registrierung verfügbar.
- Größtes Medieninteresse: Genie 3 von Google DeepMind, integriert als Project Genie im Tarif Google AI Ultra.
- Offene Modellgewichte: NVIDIA Cosmos und Meta V-JEPA 2 - stehen zum Download und für den lokalen Einsatz bereit.
- Praxistest: Testläufe mit Odyssey-3 - Ergebnisse im Detail weiter unten.
Was ist ein World Model?
Ein großes Sprachmodell prognostiziert das nächste Token. Ein World Model prognostiziert den nächsten Zustand einer Welt: das darauffolgende Einzelbild, veränderte Objektpositionen oder Kamerabewegungen. Zentral ist dabei das Steuersignal. Das Modell verarbeitet Vorgaben wie „Spieler bewegt sich vorwärts“ oder „Greifarm schließt sich“ und errechnet die unmittelbare physikalische Konsequenz.
Der Unterschied zu klassischen Videogeneratoren wie Veo:
- Ein Videogenerator berechnet den gesamten Clip im Voraus und liefert ein starres Video.
- Ein World Model generiert Frames schrittweise in Echtzeit als Reaktion auf direkte Steuerbefehle.
- Ein World Model muss eine konsistente räumliche Erinnerung besitzen: Wer umdreht und zurückgeht, sollte dasselbe Gebäude am selben Platz vorfinden (dies ist aktuell noch die größte Hürde).
Hintergründe dazu, warum Forschende Weltmodelle als nächsten Entwicklungsschritt nach LLMs betrachten, finden Sie hier: World Models - KI mit physikalischem Verständnis.
Funktionsweise im Detail
Die meisten bildgenerierenden Weltmodelle basieren auf ähnlichen Architekturen:
- Training auf Videodaten: Das System analysiert Millionen Stunden Videomaterial, häufig Gameplay-Aufnahmen und Dashcam-Videos, verknüpft mit den exakten Steuereingaben (Tastatur, Lenkrad, Robotersteuerung).
- Autoregressive Vorhersage: Ausgehend von den letzten Frames und den Steuersignalen wird das nächste Frame vorhergesagt - analog zu LLMs, jedoch mit Bildinformationen statt Wörtern.
- Diffusionsprozess: Jedes neue Frame entsteht durch Rauschunterdrückung (Denoising). Um Echtzeitgeschwindigkeiten zu erreichen, werden die Modelle destilliert, sodass wenige Schritte genügen.
- Speicherfenster: Das Modell blickt nur auf ein begrenztes Zeitfenster zurück. Sobald ein Objekt diesen Kontext verlässt, muss das System es neu generieren - daher verändern Gebäude häufig ihre Form.
Einen anderen Weg verfolgt V-JEPA: Statt Pixel darzustellen, sagt das Modell Zustände in einem abstrakten Repräsentationsraum voraus. Es ermöglicht keine interaktive Begehung, erfordert jedoch deutlich weniger Rechenleistung und eignet sich hervorragend für die Bewegungsplanung von Robotern.
Grenzen und Schwachstellen
- Objektpersistenz: Nach einer Kameradrehung verändert sich die Umgebung häufig gravierend. In Odyssey-3 trat dieser Effekt bereits nach rund 10 Sekunden auf.
- Kurze Sitzungen: Kostenlose Demos sind oft auf wenige Minuten begrenzt; Genie 3 hält laut Google eine konsistente Welt für einige Minuten stabil.
- Auflösung: Mit 480p bis 720p liegen World Models noch deutlich hinter modernen 4K-Videogeneratoren.
- Fehlendes lokales Detailwissen: Die Modelle erfassen zwar den generischen Stil einer europäischen Altstadt, kennen jedoch keine spezifischen regionalen Wahrzeichen.
- Hersteller-Benchmarks: Unabhängige Prüfungen sind rar, und Entwickler wählen meist Szenarien, in denen die eigenen Modelle optimal abschneiden.
Anwendungsbereiche in der Praxis
- Robotik und autonomes Fahren: Training in fotorealistischen Simulationen statt kostenintensiver Tests auf realer Hardware. Dies ist das Kernfeld für NVIDIA und Odyssey.
- Autonome KI-Agenten: Generierung unbegrenzter Trainingsumgebungen für Problemlösungen und Spiele.
- Gaming und Filmvorproduktion: Schnelles Prototyping von Raumstimmungen, Konzepten und Level-Layouts.
- Grundlagenforschung: Überprüfung, inwieweit KI-Architekturen physikalische Kausalitäten verstehen (z. B. via Physics-IQ).
Die wichtigsten World Models im Überblick
| Modell | Entwickler | Funktionsweise | Verfügbarkeit | Modellgewichte |
|---|---|---|---|---|
| Odyssey-3 / Pro | Odyssey | Interaktive Echtzeit-Welt via Prompt, 832×480 / 1280×720, Ego- und Third-Person-Perspektive | Kostenlose Web-Demo ohne Login; API auf Anfrage | Nein |
| Genie 3 (Project Genie) | Google DeepMind | Begehbare Welt aus Text oder Bild, 720p, 24 fps | Google AI Ultra Tarif, ab 18 Jahren | Nein |
| Cosmos (inkl. Cosmos 3 und Cosmos 3 Edge) | NVIDIA | World Models für Robotik und Fahrzeuge, Trainingsdatengenerierung | Frei verfügbar | Ja (NVIDIA-Lizenz) |
| V-JEPA 2 | Meta | Prognosen im latenten Konzeptraum ohne Pixel-Rendering; Bewegungsplanung | Frei verfügbar | Ja |
| Atlas und Marble | World Labs | 3D-Szenen und Videos aus Einzelbildern, Export als 3D-Splats | Marble im Web; Atlas angekündigt | Nein |
Genie 3 und Project Genie
Genie 3 wurde von Google DeepMind im August 2025 vorgestellt. Das Modell rendert interaktiv begehbare Umgebungen in 720p bei 24 Bildern pro Sekunde. Im Januar 2026 integrierte Google die Technologie experimentell in die Labs als Project Genie - zunächst exklusiv für Google AI Ultra Abonnenten in den USA, bevor der Zugriff laut Berichten vom Mai 2026 schrittweise ausgeweitet wurde. Project Genie kombiniert Genie 3 mit Nano Banana und Gemini. Eine Einordnung der Plattform finden Sie in unserer Analyse: World Models - die neue Grenze nach den LLMs.
Odyssey-3
Odyssey aus Palo Alto veröffentlichte Odyssey-3 am 8. Oktober 2026. Das System arbeitet als autoregressiver Diffusions-Transformer, der Folge-Frames unter Berücksichtigung der Steuerungsschritte entrauscht. Durch Destillierung werden nur noch wenige Rechenschritte pro Frame benötigt, was flüssige Interaktion ermöglicht. Dieselbe Modellarchitektur soll in Robotern, Fahrzeugen und Drohnen zum Einsatz kommen. Ein ausführliches Review bietet unser Beitrag Odyssey-3 im Praxistest.
NVIDIA Cosmos
Cosmos ist NVIDIAs Open-Source-Familie für sogenannte Physical AI. Sie dient primär der Erzeugung synthetischer Sensor- und Fahrdaten für Roboter und autonome Systeme. Die Edge-Variante ist für lokale On-Device-Berechnungen optimiert. Die Inbetriebnahme beschreibt unsere Anleitung NVIDIA Cosmos 3: Erste Schritte, weitere Details liefert der Bericht zu Cosmos 3 Edge.
V-JEPA 2 und Yann LeCuns Ansatz
V-JEPA 2 von Meta erschien im Juni 2025 und verzichtet bewusst auf pixelgenaue Bildsynthese: Die KI sagt Zustände abstrakt in Repräsentationsräumen voraus. Diesen Ansatz forciert Chef-Wissenschaftler Yann LeCun, der die Berechnung einzelner Bildpixel für ineffizient hält. Die Modellgewichte sind offen verfügbar. Zu LeCuns Ausrichtung lesen Sie auch: Yann LeCun und AMI Labs.
World Labs: Marble und Atlas
Das von Fei-Fei Li gegründete Startup konzentriert sich auf Spatial Intelligence. Marble erzeugt interaktive 3D-Räume, während das am 1. September 2026 vorgestellte Modell Atlas aus einem einzigen Standbild bis zu 60 Sekunden Videomaterial in 1440p mit präziser Kamerakontrolle und 3D-Punktwolken-Export generiert. Mehr dazu im Bericht World Labs präsentiert Atlas.
Ergebnisse im Benchmark Physics-IQ
Physics-IQ misst, wie exakt Modelle physikalische Gesetzmäßigkeiten vorhersagen: Gravitation, Kollisionen und Flüssigkeitsdynamik. Nachfolgend sind die von Odyssey zum Launch publizierten Resultate aufgeführt. Da andere Hersteller abweichende Testvarianten nutzen, werden diese nicht vermischt.
Praxistest: Odyssey-3 mit spezifischen Szenarien
Odyssey-3 ließ sich am 9. Oktober 2026 ohne Account und kostenfrei direkt im Browser testen. Wir haben das Modell unter anderem mit gezielten Prompts gefüttert: einer ostmitteleuropäischen Gebirgslandschaft (Bieszczady-Hochebene) auf Englisch, demselben Prompt auf Polnisch sowie dem Krakauer Hauptmarkt im Winter.
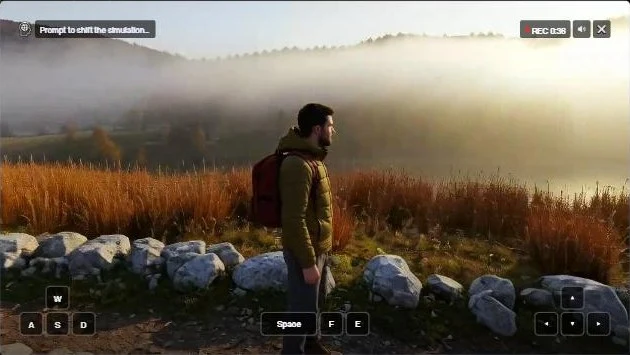
| Testkriterium | Ergebnis |
|---|---|
| Verarbeitung nicht-englischer Prompts | Verstanden (im Test auf Polnisch verifiziert) |
| Landschaftsstimmung (Nebel, Gräser, Gelände) | Gut getroffen |
| Spezifische Architekturmerkmale regionaler Bauten | Nein - rein generische europäische Gebäude |
| Bewegungs- und Drehungsflüssigkeit | Gut und verzögerungsarm |
| Objektpersistenz nach Umdrehen | Schwach - Gebäude veränderten Struktur und Form |
Unser Fazit: Die atmosphärische Stimmung wird überzeugend erzeugt. Spezifische reale Orte werden jedoch nicht akkurat abgebildet, und die Objektpersistenz bricht schnell zusammen. Für visuelle Moodboards reicht die Leistung bereits aus, für architekturgetreue Simulationen noch nicht.
Erste Schritte: Drei Zugangswege
- Direkt im Browser: Unter experience.odyssey.systems eine Textbeschreibung eingeben und die Welt per WASD und Pfeiltasten erkunden.
- Via Google-Abonnement: Project Genie über Google AI Ultra in den Google Labs freischalten (Verfügbarkeit im Account prüfen).
- Lokal auf eigener Hardware: NVIDIA Cosmos oder V-JEPA 2 über Hugging Face beziehen. Erfordert eine leistungsfähige Workstation mit NVIDIA-GPU und Python-Kenntnisse.
Abgrenzung: World Models vs. KI-Spiele-Engines
World Models dürfen nicht mit interaktiven Spiele-Engines verwechselt werden. Während Systeme wie Google Labs Playground vollständige Regelsysteme, Punktestände und Spielmechaniken berechnen, erzeugen reine Weltmodelle lediglich einen physikalisch animierten Navigationsraum ohne Spiellogik. Mehr zu spielerischen Ansätzen finden Sie in unserer Analyse zu Spieleentwicklung mit Google Playground.
Häufige Fragen (FAQ)
Wie unterscheidet sich ein World Model von einem Videogenerator?
Klassische Generatoren rechnen eine Szene linear von Start bis Ende durch. Ein World Model reagiert in Echtzeit auf interaktive Steuerbefehle und bemüht sich, bereits generierte Bereiche räumlich konsistent zu halten.
Gibt es frei nutzbare World Models?
Ja. Odyssey-3 bietet eine kostenlose Demo im Browser. Die Modellgewichte von NVIDIA Cosmos und Metas V-JEPA 2 stehen quelloffen für den lokalen Einsatz bereit.
Ist Genie 3 in DACH verfügbar?
Project Genie setzt den Tarif Google AI Ultra voraus. Da Google den Zugang schrittweise über Labs freischaltet, hängt die Verfügbarkeit vom individuellen Kontostatus ab.
Besitzen World Models ein echtes Physikverständnis?
Bislang nur ansatzweise. Spitzenwerte im Physics-IQ-Benchmark liegen bei rund 66 Punkten. Einfache visuelle Phänomene wie Lichtverläufe, Gehbewegungen und Nebel wirken bereits plausibel, komplexe Interaktionen bleiben fehleranfällig.
Lassen sich diese Modelle lokal betreiben?
Cosmos und V-JEPA 2 lassen sich auf leistungsstarker GPU-Hardware lokal ausführen. Odyssey-3 und Genie 3 laufen ausschließlich über die Cloud-Infrastruktur der jeweiligen Anbieter.
Welchen Nutzen bieten die Systeme aktuell für Kreative?
Sie eignen sich zur schnellen Vorvisualisierung von Spielszenen, für Licht- und Raumskizzen sowie als interaktive Prototypen vor der aufwendigen 3D-Produktion.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Quellen und Prüfstand
- Odyssey - Meet Odyssey-3
- Google - Project Genie
- 9to5Google zu Project Genie
- Wikipedia - Genie (world model)
- Eigene Testläufe mit Odyssey-3. Stand der Daten: 9. Oktober 2026.
More on this from WISSNOX



 stand der ki·ROAR Framework: Bessere Zeitreihen per Retrieval AugmentationDas Framework ROAR verbessert Zero-Shot-Zeitreihenprognosen: Es lernt gezielt, wann historische Referenzdaten die Vorhersage wirklich optimieren.