Muse Wonder im Test: 23 Aufgaben gegen Opus 5.5 und GPT-6
Muse Wonder, Claude Opus 5.5, GPT-6 Astra und Gemini 3.8 Flash im Test bei 23 Aufgaben: Agenten, Code und Dokumente im Kosten- und Tempovergleich.
Aktualisierung (9. November 2026): Claude Fable 5.2 und Mythos 5.2 sind erschienen - Preise, Zugang und Benchmarks im Überblick zu Claude Fable 5.2.
👁 115 Aufrufe
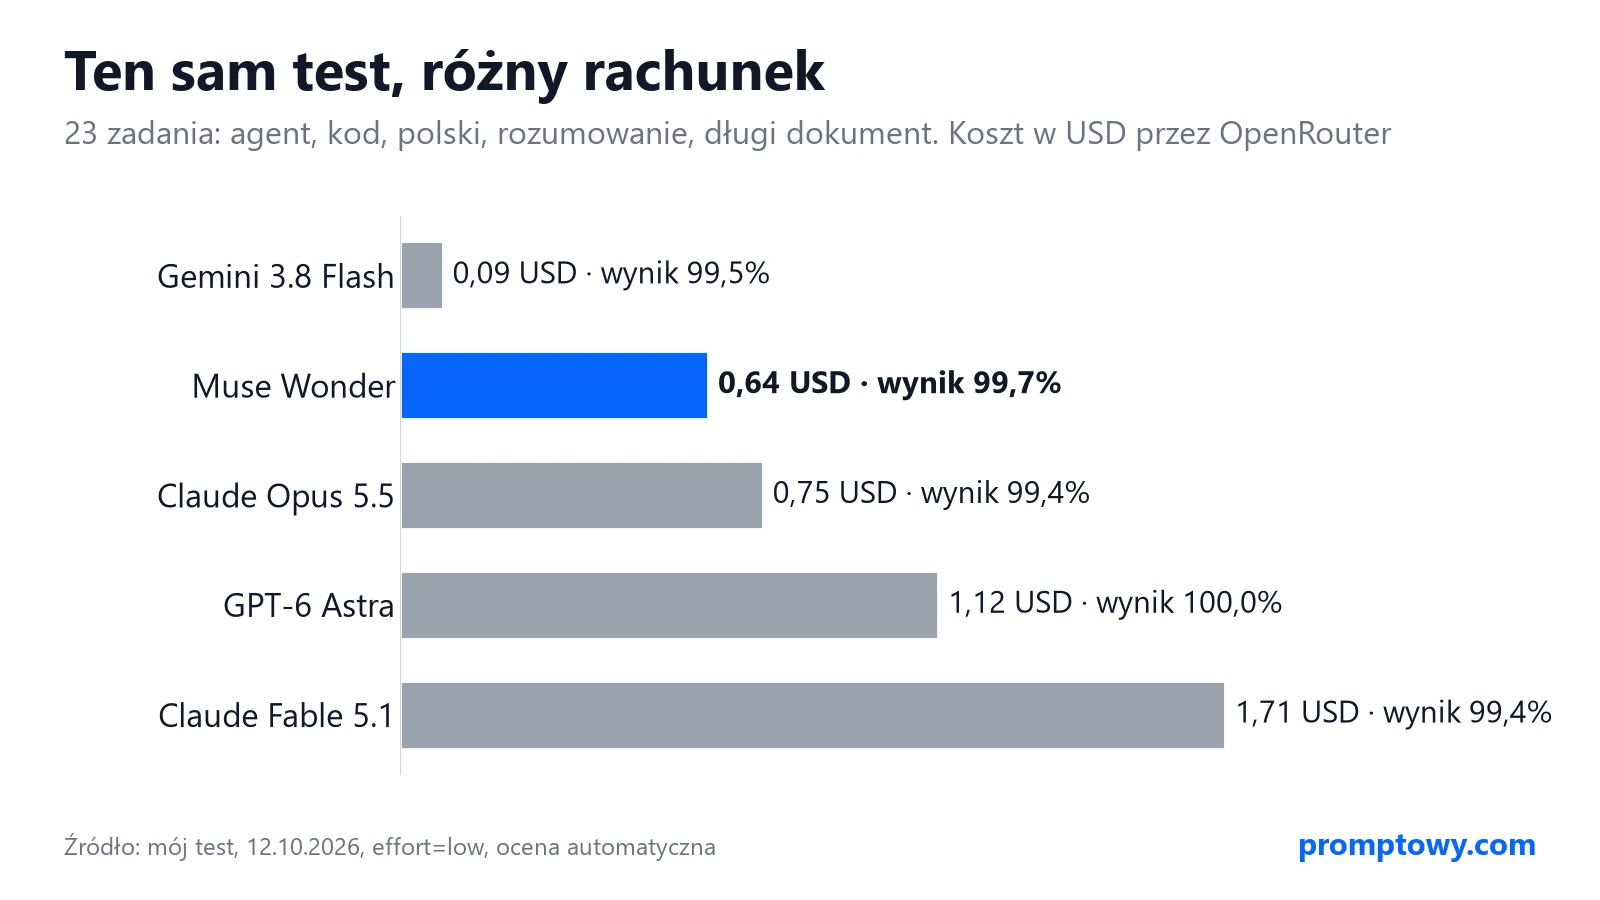
Ich habe Muse Wonder und vier Konkurrenten dieselben 23 Aufgaben gestellt: Tool-Nutzung per Agent, Code mit Unit-Tests, behördliche Schreiben, logisches Schließen und ein Dokument mit 47.000 bis 88.000 Token. Das Ergebnis hat mich mehr überrascht als Metas offizielle Benchmarks: Bei diesen praktischen Anforderungen erreichten alle fünf Modelle 99 bis 100 %. Die echten Unterschiede zeigten sich bei den Kosten, der Laufzeit und einzelnen Fehlern. Muse Wonder war am zweitgünstigsten und am zweitschnellsten. Alle Messwerte, Grafiken und Details finden Sie unten, eine Modellübersicht im Leitfaden zu Muse Wonder.
Testdurchlauf vom 12. Oktober 2026, Abend
- Modelle: Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash. Alle über OpenRouter mit Reasoning-Level „low“.
- 23 Aufgaben in zwei Durchgängen, automatische Auswertung (Unit-Tests, Prüfung der Tool-Aufrufe, exakte Antworten), ohne zwischengeschalteten KI-Juror. Hinweis: Der Test wurde auf Polnisch durchgeführt.
- Separater Test zu erfundenen Quellen (16 Publikationen pro Modell, Verifizierung via Crossref und OpenAlex).
- Gesamtkosten des Tests: ca. 4,51 EUR (5,04 USD; Umrechnung nach EZB-Referenzkurs vom 12.10.2026: 1 EUR = 1,1181 USD via EZB). Sämtliche Logs und Antworten liegen als Dateien vor.
Testergebnisse im Überblick
| Modell | Ergebnis (23 Aufgaben) | Kosten | Gesamtdauer | Echte Quellen | Ausrutscher |
|---|---|---|---|---|---|
| Muse Wonder | 99,7% | ca. 0,57 EUR (0,64 USD) | 165 s | 16/16 | Tippfehler im Code (fehlerhafter Schriftzug im polnischen Originaltest) |
| Claude Opus 5.5 | 99,4% | ca. 0,67 EUR (0,75 USD) | 222 s | 16/16 | Zusammenfassung über Wortlimit |
| Claude Fable 5.1 | 99,4% | ca. 1,53 EUR (1,71 USD) | 263 s | 16/16 | Zusammenfassung über Wortlimit |
| GPT-6 Astra | 100% | ca. 1,00 EUR (1,12 USD) | 200 s | 16/16 | keine |
| Gemini 3.8 Flash | 99,5% | ca. 0,08 EUR (0,09 USD) | 139 s | 7/16* | Heiligabend auch 2024 als Feiertag gewertet |
Das Ergebnis ist der Durchschnitt aus 23 Aufgaben mit identischer Gewichtung (bei Aufgaben mit mehreren Kriterien zählt der Anteil der erfüllten Punkte). * Gemini 3.8 Flash beim Quellentest stammt aus meiner früheren Messung vom 12. Oktober mit demselben Prompt. Währungsumrechnungen beruhen auf dem EZB-Referenzkurs vom 12.10.2026 (1 EUR = 1,1181 USD via EZB).
Aufbau der Testaufgaben
| Kategorie | Aufgaben | Bewertung |
|---|---|---|
| Agent mit Tools | Reiseplanung (3 Tools, 4 Bedingungen, Preisfallen), Shop-Rückgabe (keine Retoure nach Fristablauf), EUR-Rechnungsumrechnung nach Wechselkursen mit Serverausfall bei der ersten Anfrage | Korrektheit der Tool-Aufrufe, getroffene Auswahl, numerisches Ergebnis |
| Code | Steuernummern-Validierung, Intervall-Zusammenführung, polnische Werktage (inklusive Feiertagsänderung ab 2025), Betrag in Worten für Rechnungen | Lokal ausgeführte Unit-Tests (8 bis 19 Testfälle pro Aufgabe) |
| Sprachaufgaben (Polnisch) | Korrektur von 10 Fehlern, Zusammenfassung in 3 Punkten mit maximal 60 Wörtern, behördlicher Widerspruch, Deklination von 10 Orts- und Eigennamen | Checkliste der Vorgaben und exakte Wortformen |
| Reasoning | 11 Aufgaben mit eindeutiger Lösung (Kombinatorik, Kalenderlogik, Ritter- und Knappen-Rätsel) | Exakte Antwort |
| Langes Dokument | 80 Vorstandsprotokolle, 5 Fragen (darunter ein nachträglich revidierter Beschluss und eine Fangfrage nach nicht vorhandenen Angaben) | Exakte Antworten |
Wichtigste Erkenntnis: Praxisaufgaben differenzieren kaum noch
Bei der Reiseplanung riefen alle fünf Modelle die Tools parallel auf (4 Aufrufe in 2 Runden), sortierten den frühen Flug um 6:05 Uhr sowie das Hotel mit einer Bewertung von 7,4 aus und landeten bei exakt demselben Rechnungsbetrag. Beim Retouren-Szenario verweigerte jedes Modell nach 32 Tagen vorschriftsmäßig die Rücknahme. Bei den Rechnungen unternahmen alle nach dem simulierten Serverausfall einen zweiten Abrufversuch, ließen bereits beglichene Posten aus und nannten das korrekte Gesamtergebnis. Auch bei der Dokumentenanalyse erkannten alle Modelle zuverlässig, dass eine TikTok-Kampagne im Text gar nicht vorkam und eine Lagerfläche in einem späteren Protokoll korrigiert worden war. Das ist ein gutes Zeichen für Anwender: Bei Standardaufgaben bezahlt man heute primär für den Markennamen, nicht für das Ergebnis.
Wo die Unterschiede liegen
Kosten: Muse Wonder günstiger als Opus trotz identischer Tokenpreise
Muse Wonder und Claude Opus 5.5 verlangen auf dem Papier dieselben API-Preise: ca. 3,58 EUR (4 USD) pro Million Input-Token und ca. 17,89 EUR (20 USD) pro Million Output-Token (EZB-Referenzkurs vom 12.10.2026). Trotzdem fiel Opus im Gesamttest um 18 % teurer aus. Die Ursache zeigt sich bei langen Dokumenten: Für denselben polnischen Text zählte Metas Tokenizer 46.929 Token, Gemini 53.511, GPT-6 Astra 55.371 und die Claude-Modelle von Anthropic 87.675 Token. Der Tokenizer von Claude benötigt für slawische Sprachen wie Polnisch beinahe doppelt so viele Einheiten. Bei Dokumentenanalysen schlägt das spürbar durch: Eine einzelne Frage an das Protokoll-Paket kostete bei Muse Wonder ca. 0,17 EUR (0,19 USD), bei Opus 5.5 ca. 0,31 EUR (0,35 USD) und bei Fable 5.1 ca. 0,79 EUR (0,88 USD).
| Modell | Token für dasselbe Dokument | Kosten für Dokumentenabfrage |
|---|---|---|
| Muse Wonder | 46 929 | ca. 0,17 EUR (0,19 USD) |
| Gemini 3.8 Flash | 53 511 | ca. 0,04 EUR (0,04 USD) |
| GPT-6 Astra | 55 371 | ca. 0,62 EUR (0,69 USD) |
| Claude Opus 5.5 | 87 675 | ca. 0,31 EUR (0,35 USD) |
| Claude Fable 5.1 | 87 675 | ca. 0,79 EUR (0,88 USD) |
Bei kurzen Prompts dreht sich das Bild teilweise um: Muse Wonder generiert selbst auf Reasoning-Level „low“ recht viele Denk-Token (bei der Reiseplanung 636 Denk-Token gegenüber 46 bei Opus) und kann bei simplen Einzelanfragen daher teurer sein als Opus.
Antwortzeiten
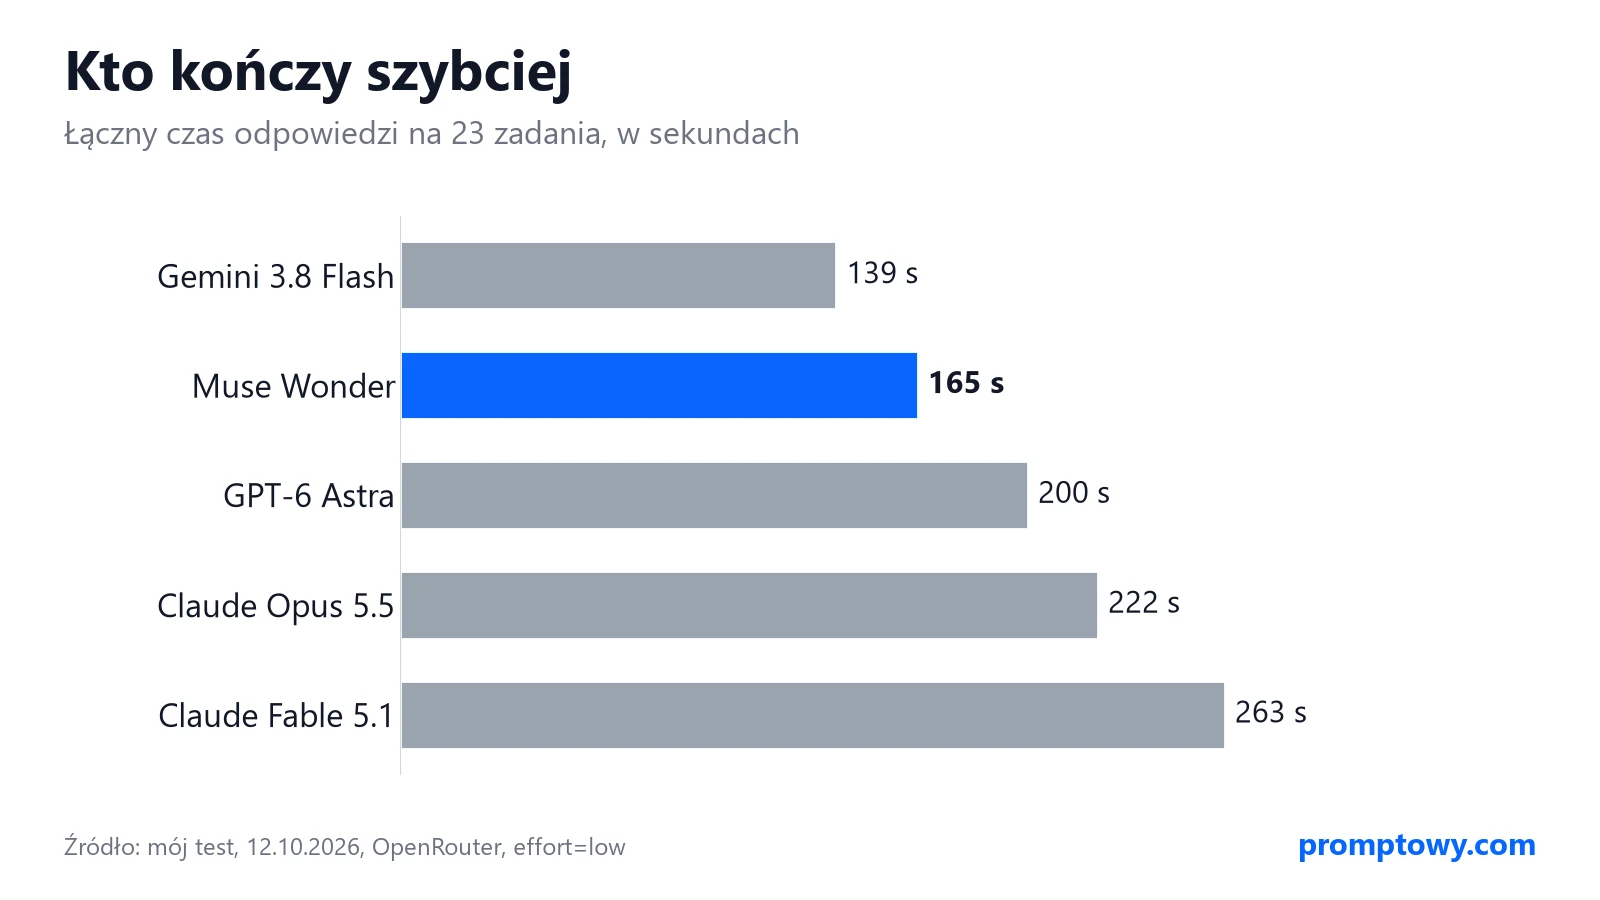
Am langsamsten agierte Fable 5.1: Für die Formulierung des Widerspruchs benötigte das Modell 80 Sekunden bei Kosten von ca. 0,25 EUR (0,28 USD). Muse Wonder erledigte denselben Text in 12 Sekunden für ca. 0,03 EUR (0,03 USD).
Auffällige Fehler im Detail
- Muse Wonder: fehlerhafter Schriftzug im polnischen Originaltest. In einer Funktion zur Umwandlung von Geldbeträgen in ausgeschriebene Wörter trug das Modell einen erfundenen Zahlbegriff in das Array ein. 15 von 16 Unit-Tests liefen fehlerfrei durch, doch ein Betrag wurde mit einem Phantasiewort ausgegeben. Für den Produktiveinsatz auf Rechnungen wäre das ein K.-o.-Kriterium.
- Muse Wonder: erfundenes Datum im Schriftsatz. Im Widerspruchsschreiben setzte das Modell eigenmächtig den „14. Oktober 2026“ ein, obwohl im Prompt kein Datum vorgegeben war. Die anderen Modelle ließen an dieser Stelle neutrale Platzhalter. Punktabzug gab es dafür nicht, im Produktiveinsatz erfordert das jedoch manuelle Prüfung.
- Claude Opus 5.5 und Fable 5.1: Wortlimit verfehlt. Die Zusammenfassung durfte höchstens 60 Wörter umfassen; die beiden Modelle lieferten 62 und 66 Wörter. Muse Wonder traf exakt 60, GPT-6 Astra landete bei 59.
- Gemini 3.8 Flash: Feiertagslogik. Das Modell definierte Heiligabend rückwirkend für sämtliche Jahre als gesetzlichen Feiertag, obwohl die Neuregelung erst ab 2025 greift. Der Testfall für Dezember 2024 schlug dadurch fehl.
Halluzinierte Quellen: Die Spitzenmodelle bleiben präzise
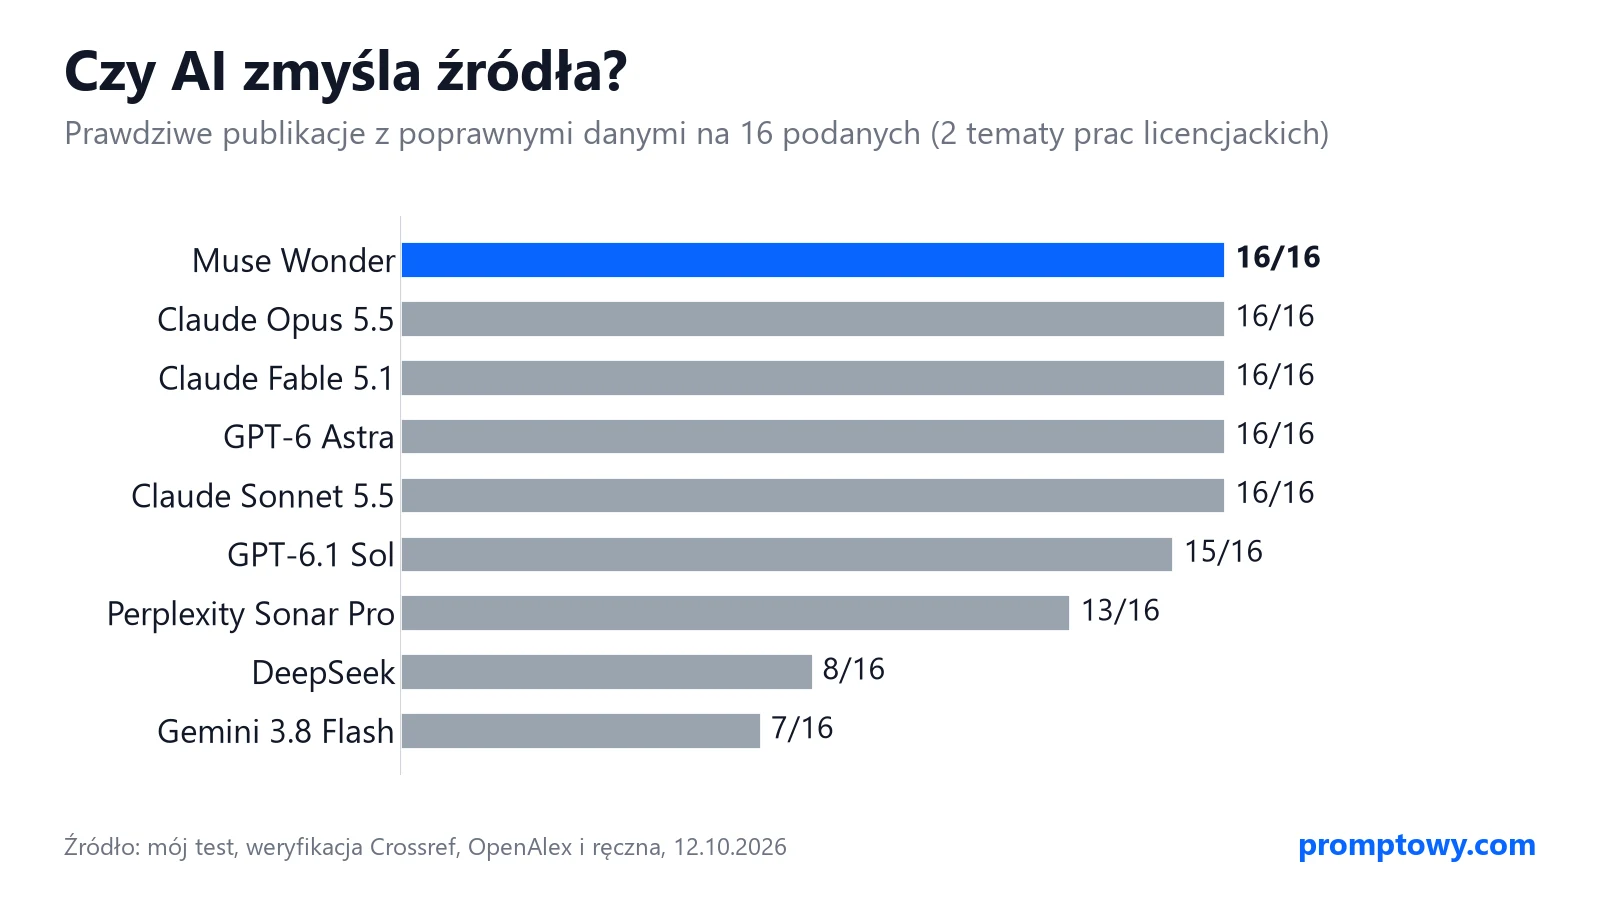
Gefordert waren jeweils 8 Literaturhinweise für wissenschaftliche Arbeiten zu zwei Themen: Einfluss sozialer Medien auf Jugendliche sowie Bürgerbudgets in Kommunen. Jeder Treffer wurde über Crossref und OpenAlex abgeglichen; vier Positionen, die in den Registern fehlten (spezifische Berichte polnischer Stiftungen sowie ein Artikel der Fachzeitschrift Métropoles), wurden manuell nachgeprüft. Alle existieren tatsächlich. Muse Wonder, Opus 5.5, Fable 5.1 und Astra lieferten 16 von 16 echten Titeln. Gemini 3.8 Flash brachte im früheren Test mit demselben Prompt lediglich 7 verifizierte Quellen zustande und erfand beim länderspezifischen Thema sieben Referenzen komplett. Für bibliografische Recherchen ist das günstigere Modell daher ungeeignet.
Vergleich mit Metas Benchmarks und Schreibtests
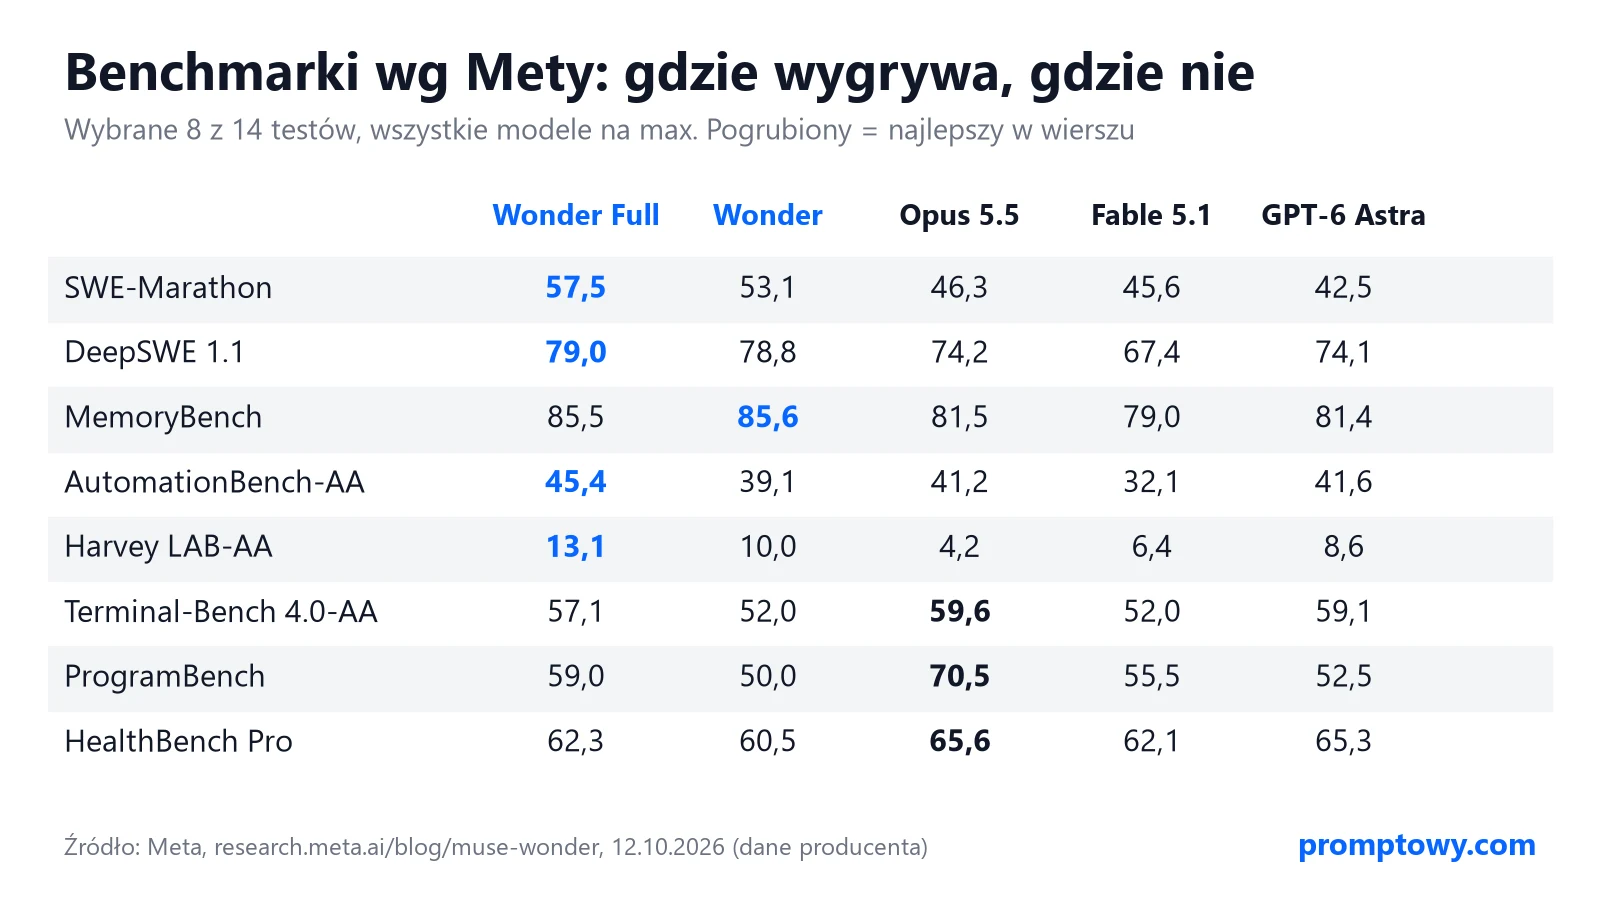
Meta hebt in den eigenen Auswertungen vor allem hervor, dass Muse Wonder Full bei umfangreichen Programmieraufgaben und Agenten-Workflows führt, während Opus 5.5 in Tests wie ProgramBench, Terminal-Bench oder HealthBench Pro vorn liegt. Mein Test bezog sich auf die reguläre Version von Muse Wonder via API. Bei Aufgaben dieser Komplexität zeigen sich zwischen den Spitzenmodellen kaum Qualitätsunterschiede. In einem separaten Blindtest zur Textqualität in polnischer Sprache, der stilistische Nuancen stärker gewichtet, erreichte Muse Wonder 87,0 Punkte, Opus 5.5 kam auf 90,1, Astra auf 85,3 und Fable 5.1 auf 83,9 Punkte (Details siehe Muse Wonder im Polnisch-Test).
Grenzen dieses Tests
- Jede Aufgabe wurde in einem einzigen Durchlauf getestet. Bei Quoten von 99 bis 100 % ist eine Abweichung bei einer Teilaufgabe statistischer Zufall und kein Qualitätsvorsprung.
- Das Reasoning-Level war einheitlich auf „low“ gesetzt, um faire Bedingungen und geringe Kosten sicherzustellen. Auf Maximaleinstellung würden sich Messwerte und Ausgaben verschieben.
- Es handelte sich um praxisnahe Anforderungen, nicht um Extremfälle. Für Grenzbereiche wie mehrstündige Coding-Projekte oder komplexe Hochschulmathematik sind externe Auswertungen wie die von Artificial Analysis aussagekräftiger.
- Die automatisierte Prüfung bewertet Fakten und formale Kriterien, nicht den individuellen Schreibstil.
Fazit
Wer KI-Modelle für standardisierte Arbeitsabläufe über die API ansteuert, erhält mit Muse Wonder dieselbe Zuverlässigkeit wie mit Opus 5.5, Fable 5.1 oder Astra. Bei umfangreichen Textdokumenten in ostmitteleuropäischen Sprachen spart Metas Modell dank des effizienten Tokenizers spürbar Geld. Das beste Preis-Leistungs-Verhältnis für reine Alltagsaufgaben bietet Gemini 3.8 Flash, sofern keine Quellenangaben verlangt werden. Dieses Urteil basiert auf dem beschriebenen Testdurchlauf vom 12. Oktober 2026.
Häufig gestellte Fragen
Welches Modell hat den Test gewonnen?
GPT-6 Astra erreichte 100 %, Muse Wonder 99,7 %, Gemini 3.8 Flash 99,5 %, Opus 5.5 und Fable 5.1 jeweils 99,4 %. Die minimalen Abweichungen resultierten aus Einzelfehlern, nicht aus generellen Leistungsunterschieden.
Ist Muse Wonder günstiger als Claude Opus 5.5?
Die offiziellen Tokenpreise sind identisch. Bei Texten in Sprachen wie Polnisch benötigt Muse Wonder jedoch weniger Token als Claude. Im 23-Aufgaben-Test lagen die Gesamtkosten bei ca. 0,57 EUR (0,64 USD) gegenüber ca. 0,67 EUR (0,75 USD) bei Opus, und bei der Analyse des langen Dokuments bei ca. 0,17 EUR (0,19 USD) statt ca. 0,31 EUR (0,35 USD).
Erfindet Muse Wonder Quellenangaben?
Im durchgeführten Quellentest wurden 16 von 16 geforderten Literaturhinweisen nachweisbar korrekt wiedergegeben.
Quellen und Methodik
- Eigener Test über OpenRouter vom 12.10.2026: 23 Aufgaben (in polnischer Sprache getestet), Reasoning-Level low, automatische Auswertung (Unit-Tests, Tool-Call-Prüfung, exakter Abgleich)
- Quellentest: Prüfung über Crossref und OpenAlex, 4 Einträge manuell recherchiert
- OpenRouter: Modellpreise
- Meta AI Research: Muse Wonder (Benchmark-Übersicht)
- Artificial Analysis: Modell-Ranglisten
More on this from WISSNOX


 magazin (alt)·Muse Wonder Preis: Kosten der Meta-KI im DetailAlle Kosten zu Metas Muse Wonder: API-Preise für Input, Output und Caching im direkten Preisvergleich.