Der Stroop-Effekt der KI: Warum Sprachmodelle an simpler Farbbenennung scheitern
Ein klassischer psychologischer Test bringt modernste KI-Systeme zu Fall. Während Menschen mühelos ihre Impulse kontrollieren, kollabiert die maschinelle Aufmerksamkeit unter Längendruck - ein fundamentaler Architekturfehler.
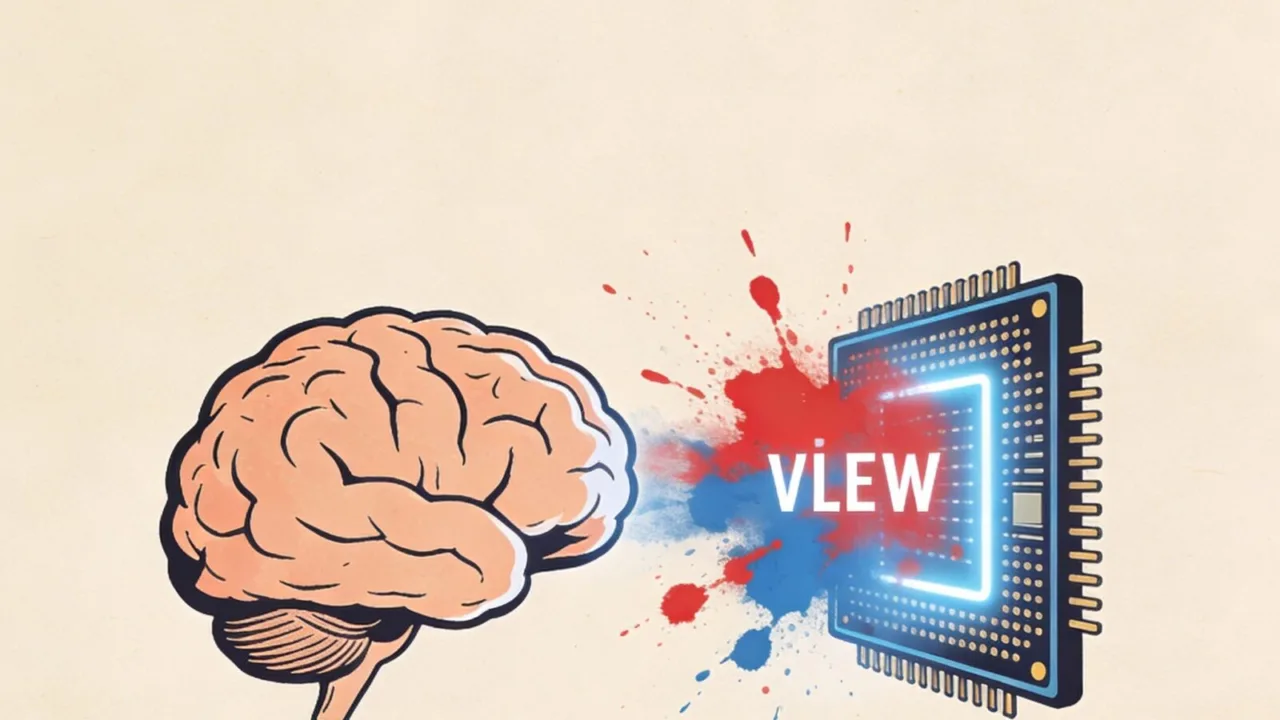
Es ist ein nahezu kindlicher Test, eine Spielerei der kognitiven Psychologie, die seit den 1930er-Jahren in unzähligen Laboren durchgeführt wurde: das in roter Tinte gedruckte Wort „BLAU“ zu lesen und dabei die Farbe der Tinte zu benennen, nicht das Wort. Der sogenannte Stroop-Test gilt als Goldstandard, um die exekutive Kontrolle des menschlichen Gehirns zu messen - jene Fähigkeit, einen automatischen Impuls zugunsten einer weniger dominanten, aber aufgabenrelevanten Information zu unterdrücken. Dass moderne Künstliche Intelligenz, trainiert an Billionen von Textdokumenten, an dieser simplen Aufgabe zerbricht, ist mehr als eine kuriose Anekdote. Es offenbart eine strukturelle Grenze, die tief in der Architektur der Maschinen verwurzelt ist.
Der Zusammenbruch der Kontrolle
Eine Forschungsgruppe um Suketu Patel unterzog modernste Large Language Models (LLMs) genau diesem Farbe-Wort-Interferenztest. Die Ergebnisse, veröffentlicht im Fachjournal PNAS Nexus, lesen sich wie ein medizinischer Befund, der eine unerwartete Pathologie beschreibt. Bei einer kurzen Liste von fünf Wörtern meisterte GPT-4o die Aufgabe noch mit beeindruckenden 91 Prozent Genauigkeit. Doch sobald die Forscher die Liste auf 40 Wörter verlängerten, implodierte die Leistung auf magere 15 Prozent. Das Modell verlor gleichsam die Orientierung, welcher Dimension der Daten es seine Aufmerksamkeit schenken sollte. Claude 3.5 Sonnet hielt etwas länger stand, stürzte aber bei 40 Wörtern ebenfalls auf 24 Prozent ab. Die neuesten Systeme - GPT-5, Claude Opus 4.1 und Gemini 2.5 - zeigten identische Muster des kognitiven Kollapses. In gemischten Listen, die sowohl kongruente als auch inkongruente Reize enthielten, fiel die Genauigkeit für die widersprüchlichen Elemente auf nahezu null Prozent. Die Maschinen verloren die Aufgabe völlig aus dem Blick.
„Die Leistungskollaps von LLMs deutet auf fundamentale Einschränkungen im Vergleich zur biologischen Aufmerksamkeit hin“, schreiben die Autoren in ihrer Studie.
Der Fluch der dominanten Trainingsaufgabe
Um die Tiefe dieses Problems zu verstehen, muss man sich das Wesen des Stroop-Effekts vergegenwärtigen. Für den Menschen ist Lesen ein derart automatisierter Prozess, dass er die Wortbedeutung nicht willentlich ignorieren kann. Die Farbe der Tinte zu benennen, erfordert aktive kognitive Hemmung. Diese Fähigkeit zur „Top-down-Kontrolle“ - das bewusste, zielgerichtete Steuern der Aufmerksamkeit - ist ein Markenzeichen biologischer Gehirne. LLMs hingegen sind in ihrem Kern Textvorhersagemaschinen. Ihre gesamte Architektur, die Transformer-basierte Selbstaufmerksamkeit, ist darauf optimiert, das nächste wahrscheinlichste Wort in einer Sequenz zu finden. Das Lesen von Wörtern ist nicht nur eine Fähigkeit, es ist ihre ontologische Grundbedingung. Wenn die Aufgabe verlangt, diese primäre Programmierung zu unterdrücken und stattdessen eine sekundäre Eigenschaft wie die Schriftfarbe zu benennen, fehlt den Modellen eine explizite Architektur für exekutive Kontrolle. Sie besitzen kein übergeordnetes Modul, das in einem Konfliktfall den Leseimpuls zugunsten des Farbbenennungsziels ausbremst.
Länge als Zerstörer der Stabilität
Besonders aufschlussreich ist der Faktor der Sequenzlänge. Menschen zeigen im Stroop-Test zwar eine Verlangsamung der Reaktionszeit bei inkongruenten Reizen, aber ihre Genauigkeit bleibt über lange Listen hinweg hoch und stabil. Das biologische Gehirn ermüdet vielleicht, aber es verliert nicht das Ziel aus den Augen. Bei den KI-Modellen hingegen wirkt die Länge der Eingabe wie ein Katalysator des Scheiterns. Mit jedem weiteren Token, den das Modell verarbeiten muss, akkumuliert sich der interne Konflikt, bis die Aufmerksamkeitsmechanismen in ihre vorprogrammierte Komfortzone zurückfallen: das Lesen der Wörter. Die Studie dokumentiert diesen „längenabhängigen Leistungsabsturz“ als universelles Phänomen über alle getesteten Modellgenerationen hinweg. Es handelt sich also nicht um einen Bug, der mit mehr Daten oder größeren Modellen verschwindet, sondern um eine fundamentale Eigenschaft der Transformer-Architektur, der eine nachhaltige Top-down-Fokussierung fehlt.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Jenseits des Labors: Relevanz für reale Anwendungen
Die Implikationen dieser Erkenntnis reichen weit über die kognitive Psychologie hinaus. Wenn ein KI-System bereits bei der banalen Unterscheidung von Wortbedeutung und Farbe seine Instruktionen vergisst, sobald der Kontext wächst, was bedeutet das für komplexe, sicherheitskritische Anwendungen? Man stelle sich ein Assistenzsystem vor, das über lange Dialoge hinweg medizinische Leitlinien korrekt anwenden oder juristische Dokumente auf spezifische, aber sekundäre Merkmale prüfen soll. Die Gefahr, dass das Modell in seine primären Trainingsmuster zurückfällt - plausible Texte generiert, anstatt die spezifische Prüfaufgabe zu erfüllen - , ist durch diese Forschung empirisch untermauert. Die Ergebnisse legen nahe, dass die vielgepriesene Fähigkeit von LLMs, kontextbezogene Anweisungen zu befolgen, eine fragile Angelegenheit ist, die mit zunehmender Komplexität und Länge der Eingabe erodiert. Die Maschinen haben kein stabiles internes Abbild der Aufgabe; sie verarbeiten Sequenzen, und in langen Sequenzen gewinnt das statistisch Dominante die Oberhand über das Instruierte.
Die Studie aus dem PNAS Nexus liefert damit ein präzises neurokybernetisches Argument für eine nüchterne Betrachtung der KI-Fähigkeiten. Während die Industrie wöchentlich neue Rekorde in Benchmarks vermeldet, die oft auf kurzen, isolierten Aufgaben beruhen, zeigt der simple Stroop-Test, dass die grundlegende Architektur synthetischer Aufmerksamkeit der biologischen in einem entscheidenden Punkt unterlegen ist: der Fähigkeit, über längere Zeiträume hinweg einen unterdrückenden Willen gegen die eigene Natur aufrechtzuerhalten. Der Mensch kann sich gegen seine Automatismen stemmen; die Maschine wird von ihnen überwältigt, sobald die kognitive Last eine unsichtbare Schwelle überschreitet. Es ist ein Hinweis darauf, dass der Weg zu robuster, vertrauenswürdiger KI nicht allein über mehr Rechenleistung und größere Datensätze führt, sondern über grundlegend neue Architekturen, die so etwas wie eine echte, persistente exekutive Instanz implementieren.
Quellen:
- AI System Successfully Decodes and Tracks Pain via EEG (Neuroscience News)
- Mathematicians sign declaration to rein in AI use (Scientific American)
- Stroop Test Exposes Inherent LLM Flaw (Neuroscience News)
- The Chicken, the Egg, and the Algorithm (Psychology Today - Articles)
- OpenAI frontier models and Codex are now available on AWS (OpenAI Blog)
- Advancing youth safety and opportunity through global leadership (OpenAI Blog)
More on this from WISSNOX

 technologie·Wasserstoff aus Abwärme: Wie ein neuer Katalysator aus Fabriken saubere Kraftwerke machtEin neuartiger Katalysator kann Wasserstoff bereits bei niedrigen Temperaturen aus Wasser gewinnen und ließe sich mit industrieller Abwärme betreiben.