LTX Video lokal im Test: Open-Source-Videomodell auf RTX 4090
LTX-Video 13B distilled erzeugt auf einer RTX 4090 5 Sekunden Video in nur 18 Sekunden. Ich habe das Modell lokal gemessen, mit LTX-2 verglichen und die Lizenzbedingungen geprüft.
👁 121 Aufrufe
Das distillierte Modell LTX Video 13B von Lightricks ist das schnellste offene Videomodell, das ich bisher auf meiner eigenen Grafikkarte getestet habe: Ein 5-Sekunden-Clip in 768×512 entsteht auf einer RTX 4090 in gerade einmal 18 Sekunden, bei etwa 16 GB VRAM-Belegung. Die Nutzung ist bedingt kostenlos für kommerzielle Projekte freigegeben, sofern Ihr Unternehmensumsatz unter 10 Millionen USD pro Jahr liegt. Einen Überblick über weitere Systeme finden Sie in meinem Hub lokale KI-Modelle.
Stand: 17. Oktober 2026
- Modell: LTX-Video 13B 0.9.8 distilled (16. Juli 2025), 8 Schritte, reines Video ohne Ton. FP8-Dateien: 15,7 GB Modell und 5,2 GB T5-Encoder (zusammen 20,9 GB).
- Meine Messung auf RTX 4090 (ComfyUI 0.41): 5-Sekunden-Clip in 768×512 in 18-20 s, in 1216×704 in 37 s; erster Clip inklusive Modell-Ladezeit von SSD 63 s. VRAM-Peak bei 15,3-16,4 GB der gesamten Karte.
- Lizenz: LTXV Open Weights erlaubt kommerzielle Nutzung bis 10 Mio. USD Jahresumsatz ohne Ausschluss der EU. Veröffentlichte Inhalte müssen zwingend als maschinengeneriert gekennzeichnet werden.
- LTX-2, 2.3 und 2.5 (2026) generieren Bild plus Ton mit offenen Gewichten, benötigen jedoch mindestens 19-22 GB allein für die Modelldatei sowie den Gemma-Encoder.
LTX-Video vs. LTX-2: Was unterscheidet die Modellfamilien?
Lightricks bietet zwei verschiedene Familien offener Videomodelle sowie eine eigenständige Desktop-Software an. Da die Bezeichnungen ähnlich klingen, die Systemanforderungen sich jedoch drastisch unterscheiden, hilft eine direkte Gegenüberstellung der Parameter und Dateigrößen.
| Modell | Parameter | Audio | Kleinste Modelldatei |
|---|---|---|---|
| LTX-Video 0.9.8 2B distilled | 2 Mrd. | Nein | 4,5 GB (fp8) |
| LTX-Video 0.9.8 13B distilled | 13 Mrd. | Nein | 15,7 GB (fp8) |
| LTX-2 (Januar 2026) | 19 Mrd. | Ja | 20,0 GB (fp4) |
| LTX-2.3 (März 2026) | 22 Mrd. | Ja | 21,7 GB (nvfp4) |
| LTX-2.5 (August 2026) | 22 Mrd. | Ja | 18,7 GB (nvfp4) |
Zu den reinen Modellgewichten kommen die Text-Encoder hinzu: Für LTX-Video ist dies der T5-Encoder (5,2 GB in FP8). Die Modelle LTX-2 und LTX-2.3 nutzen den Gemma 3 12B Encoder (9,45 GB im kleinsten Paket von Comfy-Org), während LTX-2.5 auf Gemma 4 12B (15,4 GB in Int8) setzt. Wie Sie andere Modelle quantisieren, erkläre ich im Beitrag über GGUF und Quantisierung. Das Format NVFP4 ist für Grafikkarten der RTX 50-Serie gedacht. LTX-2.5 verlangt zudem einen Hugging-Face-Login zur Lizenzannahme vor dem Download.
LTX Desktop
LTX Desktop ist eine Open-Source-Anwendung von Lightricks (Apache 2.0 Lizenz, Version 1.3.0 vom 9. Oktober 2026) für Windows, Linux und macOS mit Apple Silicon. Die Software generiert Videomaterial aus Text, Bild sowie Ton und beinhaltet Schnittfunktionen. Laut Dokumentation gelten folgende Vorgaben:
- Lokal läuft standardmäßig LTX 2.5 Fast (optional LTX 2.3 Fast), während LTX 2.5 Pro der kostenpflichtigen Cloud vorbehalten bleibt.
- Unter Windows wird eine Nvidia-Grafikkarte mit mindestens 15 GiB VRAM, 16 GB Arbeitsspeicher (32 GB empfohlen) und rund 72 GB freier Speicherplatz für das Basisset von LTX 2.5 Fast vorausgesetzt.
- Texteingaben werden standardmäßig über einen kostenlosen API-Key in der Cloud verarbeitet, sofern in den Einstellungen kein lokaler Encoder aktiviert wird.
LTX Video local: Meine Messungen auf der RTX 4090
Mein Testsystem besteht aus einer Nvidia GeForce RTX 4090 (24 GB VRAM), einem Intel Core i9-14900KF, 64 GB RAM und Windows 11. Als Testumgebung diente ComfyUI 0.41.0 mit dem Checkpoint ltxv-13b-0.9.8-distilled-fp8 und dem Encoder t5xxl fp8. Die Parameter: 8 Schritte mit integriertem Zeitplan (ManualSigmas), CFG 1, Euler-Sampler, 24 Bilder pro Sekunde und VAE-Decode mit Kachelung (Tiled). Die Belegung des VRAMs habe ich alle 0,5 Sekunden per nvidia-smi protokolliert (inklusive rund 1,7 GB Systemlast vor Testbeginn).
| 5-Sekunden-Clip (121 Frames) | Auflösung | Gesamtzeit | VRAM-Peak |
|---|---|---|---|
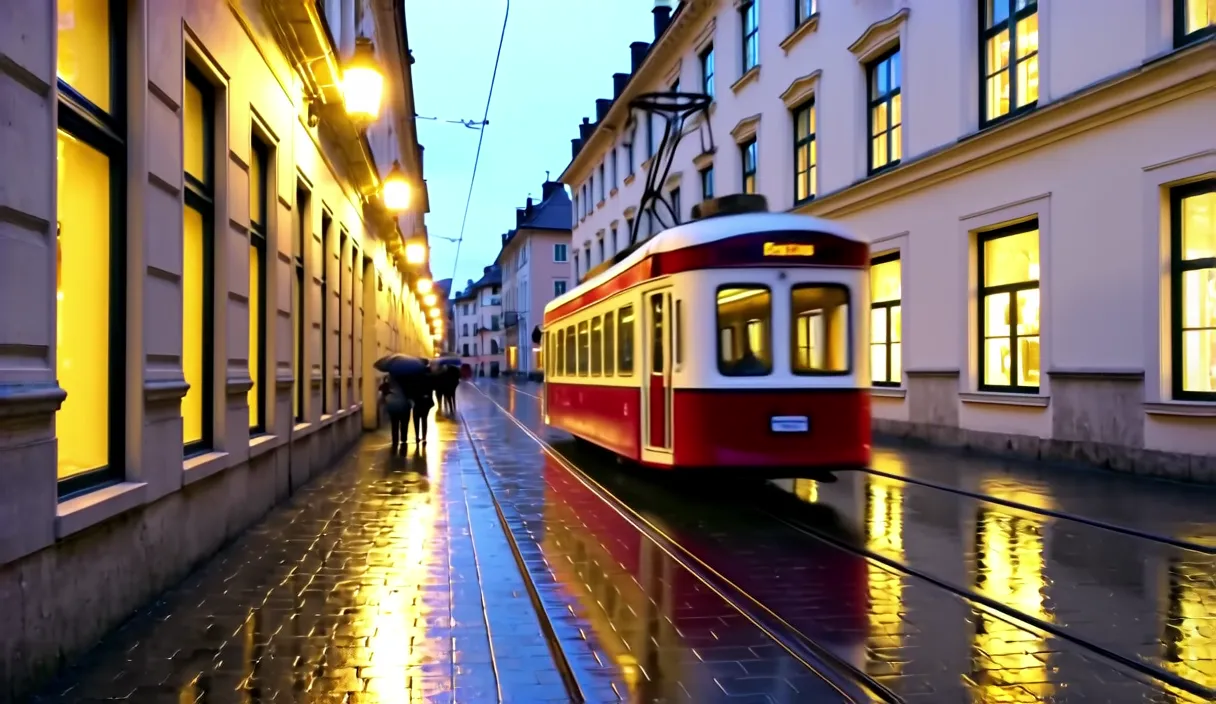
| Straßenbahn (Kaltstart mit Laden) | 768×512 | 63,2 s | 15,6 GB |
| Straßenbahn (Modell im Speicher) | 768×512 | 18,0 s | 15,5 GB |
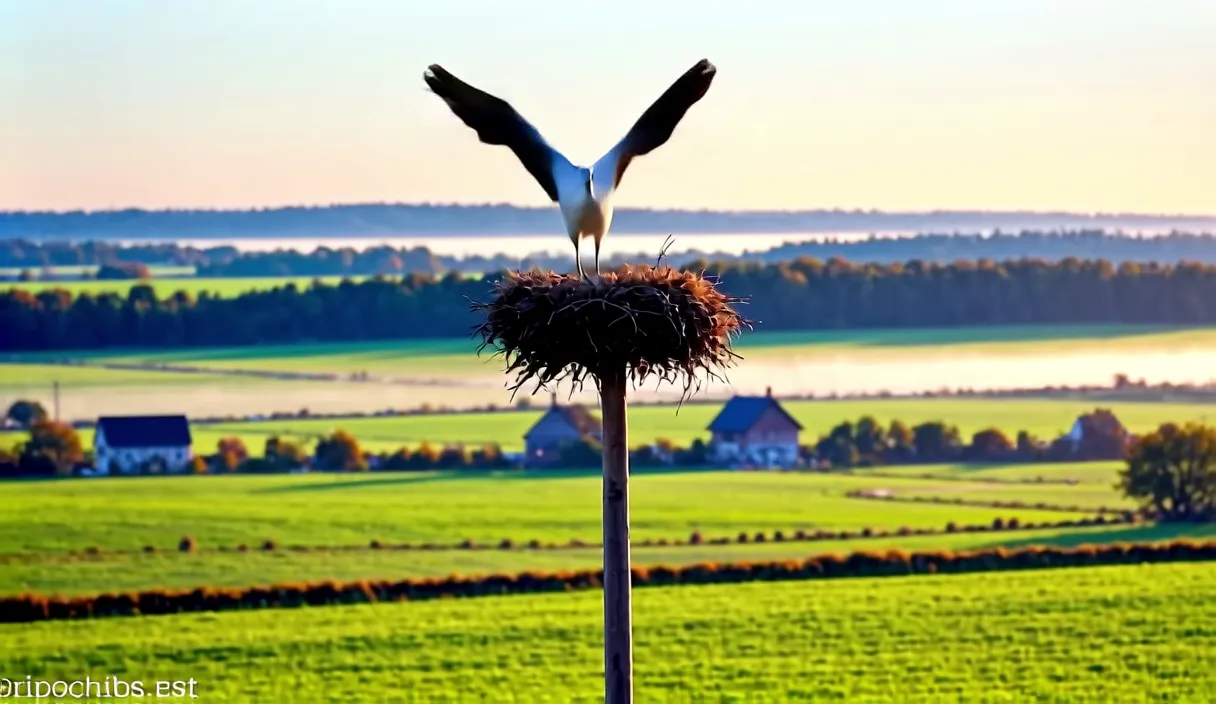
| Storch auf Nest | 768×512 | 20,2 s | 15,3 GB |
| Storch auf Nest | 1216×704 | 37,1 s | 16,4 GB |
| Straßenbahn | 1216×704 | 36,5 s | 16,4 GB |
Die reine Sampling-Phase (8 Schritte) dauerte laut ComfyUI-Protokoll lediglich 8 Sekunden bei 768×512 und 22 Sekunden bei 1216×704. Die restliche Zeitspanne entfällt auf den Text-Encoder und das VAE-Decoding. Beim ersten Durchlauf fiel zudem das Einlesen der 20,9 GB großen Modelldateien von einer externen USB-SSD ins Gewicht. ComfyUI lief mit dem Parameter --disable-smart-memory.
In einem früheren Test am 3. Oktober 2026 (unter ComfyUI 0.37) mit einer komplexen Regenszene auf dem Marktplatz verbrauchte ein 5-Sekunden-Clip (1216×704) bei LTX-Video 13B 5,7 Wh an GPU-Energie bei 17,8 GB VRAM-Peak (reine Generierung: 20 Sekunden). Zum Vergleich benötigte Wan 2.2 5B in 1280×704 für dieselbe Szene 20 Schritte, rund 4 Minuten Rechenzeit und 19 Wh Energie bei 17,3 bis 23,4 GB VRAM.
Bildqualität und Schwächen in der Praxis
Die generierten Szenen zeigen deutliche Unterschiede je nach Motivkomplexität:
- Straßenbahn im Regen: Nasses Pflaster mit Lichtreflexionen, Passanten mit Regenschirmen und eine gleichmäßige Kamerafahrt funktionierten hervorragend. Das Zielschild an der Tram war jedoch typischer Zeichensalat.
- Storch: Der Prompt forderte eine Landung auf dem Nest. Das Modell platzierte den Vogel jedoch ab Frame 1 direkt ins Nest und ließ ihn nur mit den Flügeln schlagen. Die geforderte Kirche im Hintergrund fehlte, und unten links entstand ein verschwommenes Gebilde, das wie ein Wasserzeichen wirkt.
- Kutschen-Szene (3. Oktober): Bei der Testszene eines Marktplatzes verwandelte LTX-Video das weiße Pferd einer Kutsche innerhalb von zwei Sekunden in einen weißen Lieferwagen mit Schirm.
Schritt-für-Schritt-Anleitung für ComfyUI
Für die manuelle Einrichtung von LTX-Video 13B in ComfyUI sind folgende Schritte erforderlich:
- Starten Sie ComfyUI unter Windows mit der Umgebungsvariable
PYTHONUTF8=1. - Laden Sie aus dem offiziellen Hugging-Face-Repository Lightricks/LTX-Video die Datei
ltxv-13b-0.9.8-distilled-fp8.safetensors(15,7 GB) herunter und legen Sie diese im OrdnerComfyUI/models/checkpointsab. Für Grafikkarten mit 8 bis 12 GB VRAM empfiehlt sichltxv-2b-0.9.8-distilled-fp8.safetensors(4,5 GB). - Laden Sie aus dem Repository
comfyanonymous/flux_text_encodersdie Dateit5xxl_fp8_e4m3fn_scaled.safetensors(5,2 GB) in das VerzeichnisComfyUI/models/text_encoders. Das VAE ist bereits im Checkpoint integriert. - Wählen Sie im Menü unter Workflow > Browse Templates die Vorlage „LTXV Text to Video“. Passen Sie im Node Load Checkpoint die Modelldatei auf 13B an und wählen Sie im Node Load CLIP den Typ
ltxvmitt5xxl fp8. - Verbinden Sie den SamplerCustom-Node statt mit dem Standard-Scheduler mit einem ManualSigmas-Node und tragen Sie exakt folgende Werte ein:
1.0, 0.9937, 0.9875, 0.9812, 0.975, 0.9094, 0.725, 0.4219, 0.0. Setzen Sie den CFG-Wert strikt auf 1. - Wählen Sie Auflösungen, die ein Vielfaches von 32 sind (z. B. 768×512 oder 1216×704), und Bildanzahlen nach der Formel
8n + 1(121 Frames ergeben exakt 5 Sekunden bei 24 fps). - Nutzen Sie bei VRAM-Engpässen während der Ausgabe den Node VAE Decode (Tiled).
Lizenz und kommerzielle Nutzung
LTX-Video (ab Version 0.9.6 einschließlich 13B 0.9.8) unterliegt der LTXV Open Weights License. Für neuere Modelle gelten die LTX-2 Community License bzw. die LTX-2.x Community License. Die Bedingungen gestalten sich wie folgt:
- Umsatzgrenze: Die freie kommerzielle Nutzung ist gestattet, solange der Jahresumsatz Ihres Unternehmens unter 10 Millionen USD liegt. Liegt der Umsatz darüber, muss eine gesonderte Lizenz erworben werden.
- Kennzeichnungspflicht: Eine Klausel verlangt, dass alle öffentlich zugänglich gemachten Inhalte deutlich sichtbar als maschinengeneriert markiert werden müssen.
- Regionale Gültigkeit: Die Lizenz enthält im Gegensatz zu manchen Konkurrenten keine Ausschlussklauseln für die Europäische Union.
Im Vergleich dazu stehen Wan 2.2 unter der Apache-2.0-Lizenz und Kandinsky 6 unter der MIT-Lizenz. Beide Lizenzen verzichten auf finanzielle Umsatzschwellen. Details zur Wirtschaftlichkeit lokaler Setups analysiere ich im Artikel lokales KI-Modell oder API-Kosten.
LTX-Video, Wan 2.2 oder Kandinsky 6?
Welches Modell für Ihre Zwecke optimal ist, hängt vom Arbeitsschwerpunkt ab:
- LTX-Video 13B distilled: Ideal für schnelle Entwürfe, Mockups und Prompt-Iterationen. Das Sampling benötigt nur 20 Sekunden, neigt jedoch bei komplexen Handlungen zu Artefakten und Objektverwandlungen.
- Wan 2.2 5B: Bietet sauberere Bildruhe und eine uneingeschränkte Apache-2.0-Lizenz, erfordert jedoch mit rund 4 Minuten pro 5-Sekunden-Clip deutlich mehr Geduld.
- Kandinsky 6 Lite: Die beste Wahl, wenn Video direkt synchron mit Audio und Sprache generiert werden soll (ca. 1:51 bis 2:28 Minuten pro Clip in 864×480).
Mein Dienst Jantaris bietet 30 Videomodelle auf einem Prepaid-Guthaben in USD - etwa Kling 3.0 ab 0,09625 $ pro Sekunde (720p) und Veo 3.1 Lite für 0,177 $ pro 8-s-Clip; fehlgeschlagene Generierungen kosten 0 $. Alle Preise: der Jantaris-Leitfaden.
Häufig gestellte Fragen (FAQ)
Was ist der Unterschied zwischen LTX-Video und LTX-2?
LTX-Video umfasst die Versionen der 0.9.x-Reihe (2B und 13B), nutzt den T5-Encoder und erzeugt rein stummes Videomaterial. Die LTX-2-Familie (LTX-2, 2.3 und 2.5) umfasst bis zu 22 Milliarden Parameter, basiert auf Gemma-Encodern und generiert Video sowie Ton simultan.
Wie viel VRAM benötigt LTX-Video 13B lokal?
In meinen Messungen auf der RTX 4090 lag der VRAM-Spitzenwert bei 15,3 bis 16,4 GB für Auflösungen zwischen 768×512 und 1216×704. Eine Grafikkarte mit 16 GB VRAM stellt daher das praktische Minimum für das 13B-Modell dar, während für kleinere Karten mit 8 bis 12 GB die 2B-Variante existiert.
Lässt sich LTX-2 auch lokal ausführen?
Ja, die Modellgewichte für LTX-2, 2.3 und 2.5 sind auf Hugging Face verfügbar und werden von ComfyUI 0.41 unterstützt. Zudem stellt Lightricks die App LTX Desktop bereit, die laut Entwicklerangaben mindestens 15 GiB VRAM und rund 72 GB Festplattenspeicher verlangt.
Versteht LTX-Video deutsche Prompts?
Nein, der verwendete T5-Text-Encoder wurde primär mit englischsprachigen Datensätzen trainiert. Prompts sollten daher auf Englisch verfasst werden, wobei spezifische Objekte am besten über ihre visuelle Erscheinung beschrieben werden.
Welche maximale Clip-Länge erzeugt LTX-Video 13B?
Standardmäßig werden kurze Sequenzen von 5 Sekunden (121 Frames) berechnet. Laut Entwicklerdokumentation beherrscht das Modell über spezialisierte ComfyUI-Erweiterungsknoten auch bis zu 60 Sekunden lange Clips, was jedoch zusätzliche Workflows voraussetzt.
Quellen
- Lightricks/LTX-Video auf Hugging Face (Model Card, Dateigrößen und Spezifikationen).
- LTXV Open Weights License (Lizenzbestimmungen und Umsatzschwellen).
- Lightricks/LTX-Video auf GitHub (Versionshistorie und Release 0.9.8).
- Lightricks/LTX-2.5 auf Hugging Face (LTX-2.x Modellreihe und Gemma-Encoder).
- LTX Desktop Repository auf GitHub (Systemvoraussetzungen und Release 1.3.0).
- Eigene Messungen auf RTX 4090 unter ComfyUI 0.41.0 und ComfyUI 0.37.0.
Geprüft am 17. Oktober 2026.
More on this from WISSNOX

 ki-werkzeuge·Higgsfield Login und Konto: Registrierung, Settings und HilfeWie funktionieren Registrierung, Login und Kontoverwaltung bei Higgsfield AI? Wir erklären die wichtigsten Einstellungen, typische Fehlerquellen und Sicherheitsregeln.