Qwen-Image-2.1 im Test: Lokale RTX 4090 gegen Cloud-Modelle
Qwen-Image-2.1 lokal auf der RTX 4090 im Härtetest: Textgenauigkeit, Layout-Treue, 10 sequentielle Bildbearbeitungen und Detailgrad im Vergleich.
👁 116 Aufrufe
Qwen-Image-2.1 führt derzeit als bestes Open-Weights-Bildmodell das Ranking von Artificial Analysis an. Ich habe das Modell denselben vier Praxistests unterzogen, die ich bereits für Ideogram 4.5 und FLUX 3 durchgeführt habe. Qwen lief lokal auf meiner RTX 4090, während die Vergleichsmodelle über APIs angesprochen wurden. Das Ergebnis ist zweigeteilt: Einzelne Bilder sehen hervorragend aus und entstehen in 6 bis 20 Sekunden für minimale Stromkosten. Bei Texten, exaktem Layout und sequentiellen Bearbeitungen behalten geschlossene Modelle jedoch klar die Oberhand.
Das Ranking von Artificial Analysis basiert auf Blindabstimmungen, bei denen Nutzer das ästhetisch ansprechendere Bild wählen. Das ist ein guter Maßstab für Optik, sagt jedoch wenig darüber aus, ob ein Modell komplexe Sonderzeichen rendert, ein Objekt präzise in der Ecke platziert oder die zehnte Korrekturschleife übersteht. Daher messe ich dies separat mit denselben Skripten und Prompts wie bei den Mitbewerbern.
Testaufbau und Methodik
- Hardware & Setup: Nvidia RTX 4090 (24 GB VRAM), ComfyUI, Qwen-Image-2.1 als int8-Quantisierung (16,6 GB Dateigröße), 25 Schritte, Euler-Sampler, CFG 1,0 - basierend auf der offiziellen Vorlage.
- Vergleichsmodelle: Identische Aufgaben über die API von fal.ai, dokumentiert in den Tests zu Ideogram 4.5 und FLUX 3 vom 1. Oktober 2026.
- Testablauf: Jeweils ein einzelner Durchlauf pro Prompt mit festem Seed ohne nachträgliche Selektion.
- Testdatum: 2. Oktober 2026.
Ergebnisse im Überblick
| Test | Qwen-Image-2.1 (Lokal) | Bester Wert im Testfeld |
|---|---|---|
| Polnische Textvorgaben (13 Begriffe im Test) | 6/13 | 13/13 - GPT Image 2.5, Nano Banana Pro, Nano Banana 2, Grok |
| Objektplatzierung nach Vorgabe (16 Objekte) | 2/16, IoU 0,17 | 16/16, IoU 0,89 - FLUX 3 mit JSON-Bounding-Boxes |
| Detailwiedergabe im Großformat | 2752 × 1536, effektiv 3,1 MP | 16,8 MP - FLUX 3 in 4K |
| Lesbare Kleinschilder (8) | 2/8 | 8/8 - GPT Image 2.5, Grok, Seedream |
| 10 sequentielle Bearbeitungen (SSIM nach Schritt 10) | 0,11 | 0,95 - Ideogram 4.5 |
| Generierungszeit pro Bild (1024 × 1024) | ca. 6 s | API-Konkurrenz: 20-60 s |
| Kosten pro Bild | Reine Stromkosten | 0,024-0,22 USD (ca. 0,02-0,20 EUR, EZB-Kurs vom 12.10.2026 via ecb.europa.eu) via API |
Test 1: Textdarstellung mit komplexen Sonderzeichen
In unserem Benchmark wurden vier anspruchsvolle Aufgaben gestellt (getestet mit polnischen Textvorlagen: ein Sale-Plakat, eine Speisekarte, ein Buchtitel sowie eine Pierogi-Verpackung). Insgesamt galt es, 13 Begriffe buchstabengetreu wiederzugeben. Die automatische Texterkennung (OCR) habe ich auf jedem Bild manuell überprüft.
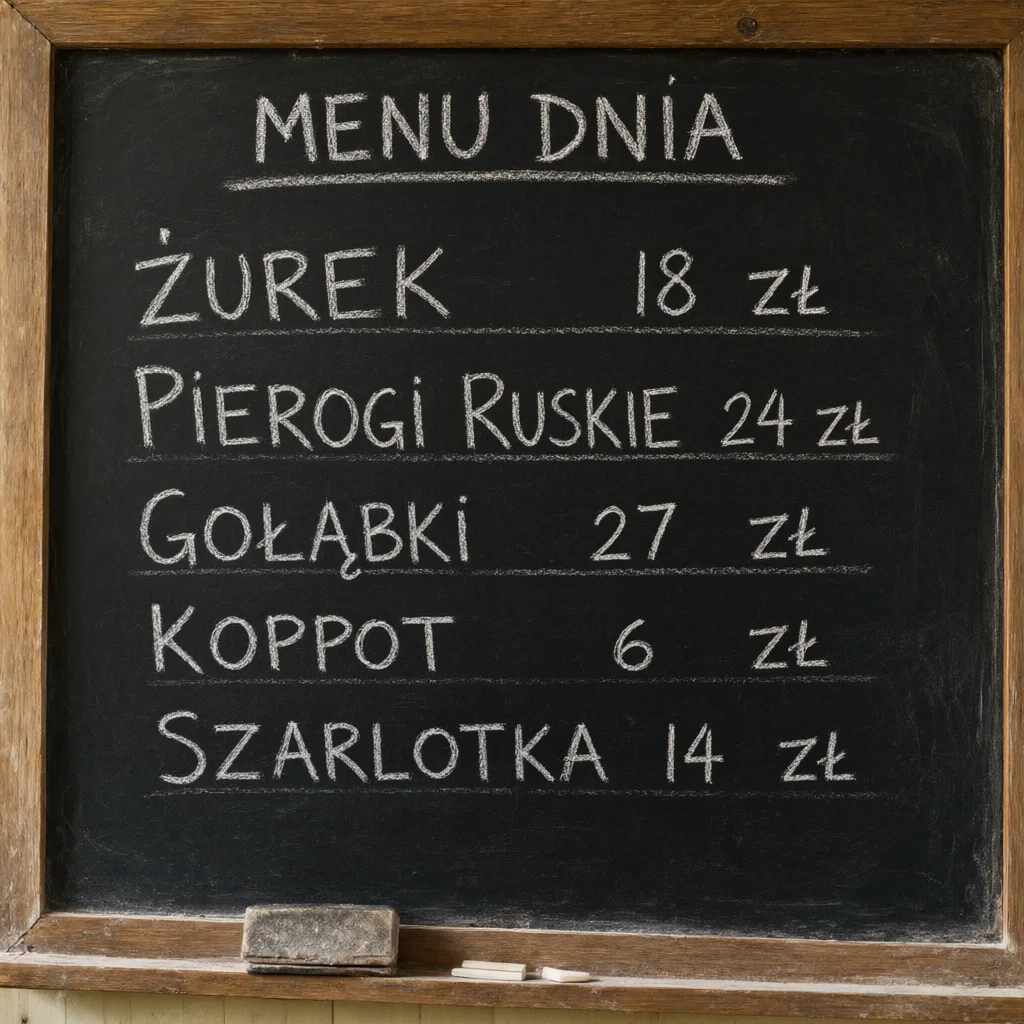
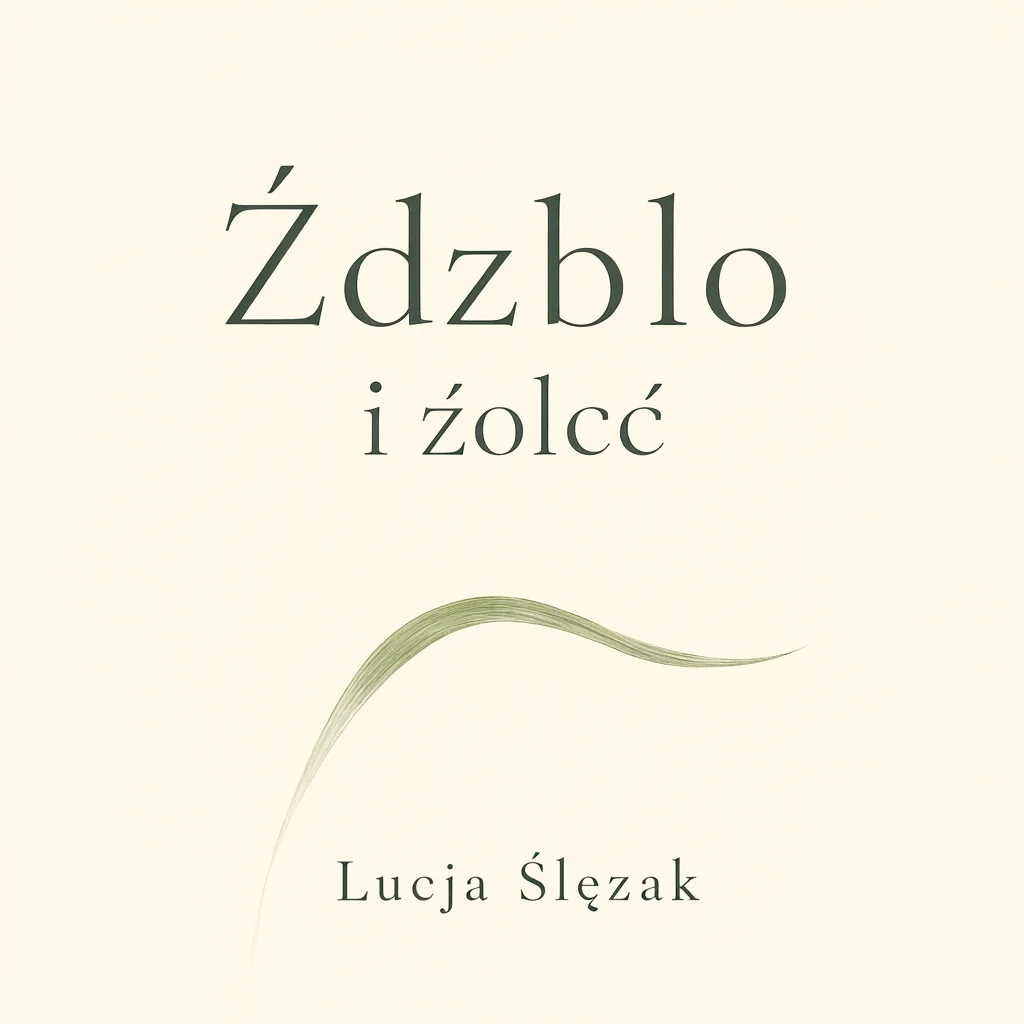
Große, isolierte Standardbegriffe gelingen dem Modell oft problemlos. Kritisch wird es bei selteneren Buchstabenkombinationen, Diakritika und kleinerem Fließtext. Auf der Lebensmittelpackung entstanden Artefakte und Fantasiewörter, auf dem Plakat verwaschene Buchstabenketten. Für komplexe typografische Layouts ist Qwen-Image-2.1 ohne nachträgliche Bearbeitung kaum verlässlich nutzbar.
Test 2: Platzierung von Objekten nach Layoutvorgaben
Geprüft wurden vier Szenen mit jeweils vier Objekten, deren Positionen exakt in relativen Koordinaten (Prozentangaben von Breite und Höhe) definiert waren. Da Qwen-Image-2.1 kein natives Bounding-Box-Format verarbeitet, erhielt es die identische textuelle Positionsbeschreibung wie Nano Banana Pro, GPT Image 2.5 und Seedream. Ein Vision-Modell ermittelte anschließend die tatsächlichen Objektkoordinaten, woraus die Überschneidung mit der Zielregion berechnet wurde (Intersection over Union, IoU).
| Modell | Durchschnittliche IoU | Objekte am richtigen Platz |
|---|---|---|
| FLUX 3 Image (JSON-Bounding-Boxes) | 0,89 | 16/16 |
| Seedream 5.0 Pro | 0,79 | 15/16 |
| GPT Image 2.5 Sunburst | 0,54 | 11/16 |
| Nano Banana Pro | 0,48 | 7/16 |
| Ideogram 4.5 | 0,37 | 7/16 |
| Qwen Image 3 (API) | 0,35 | 6/16 |
| Qwen-Image-2.1 (lokal) | 0,17 | 2/16 |
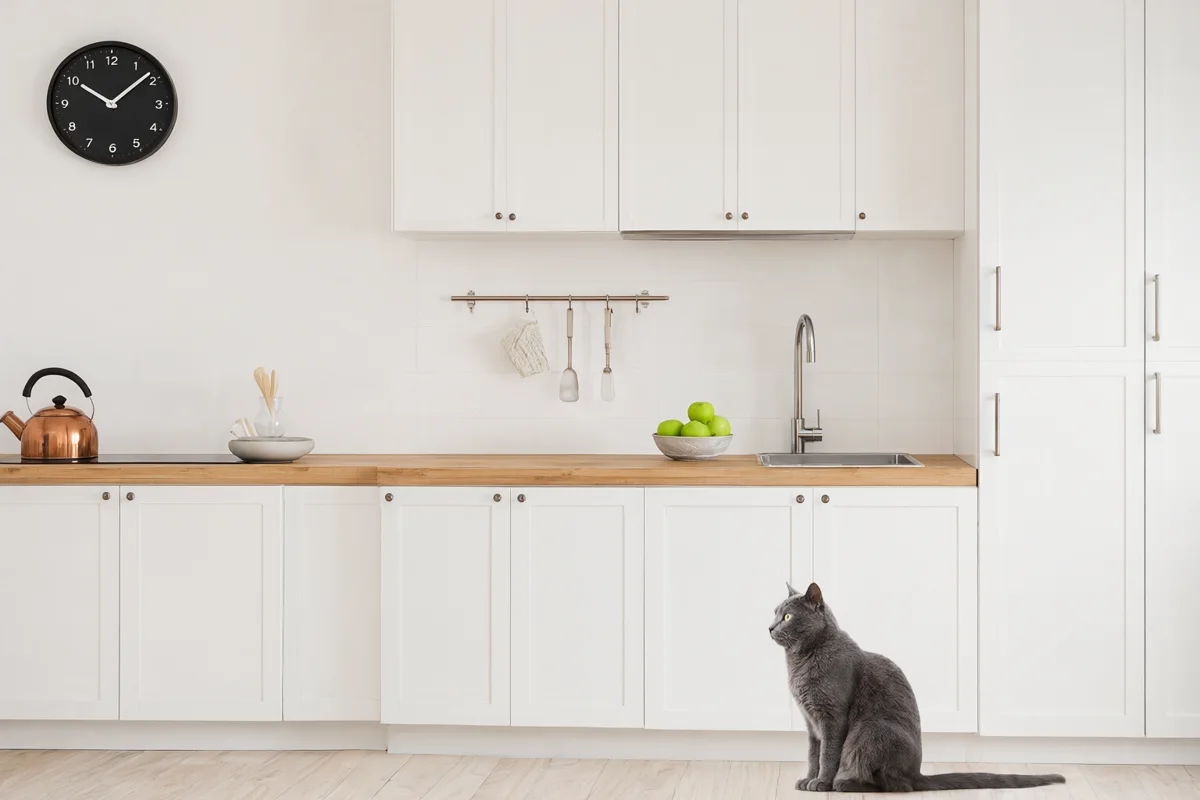
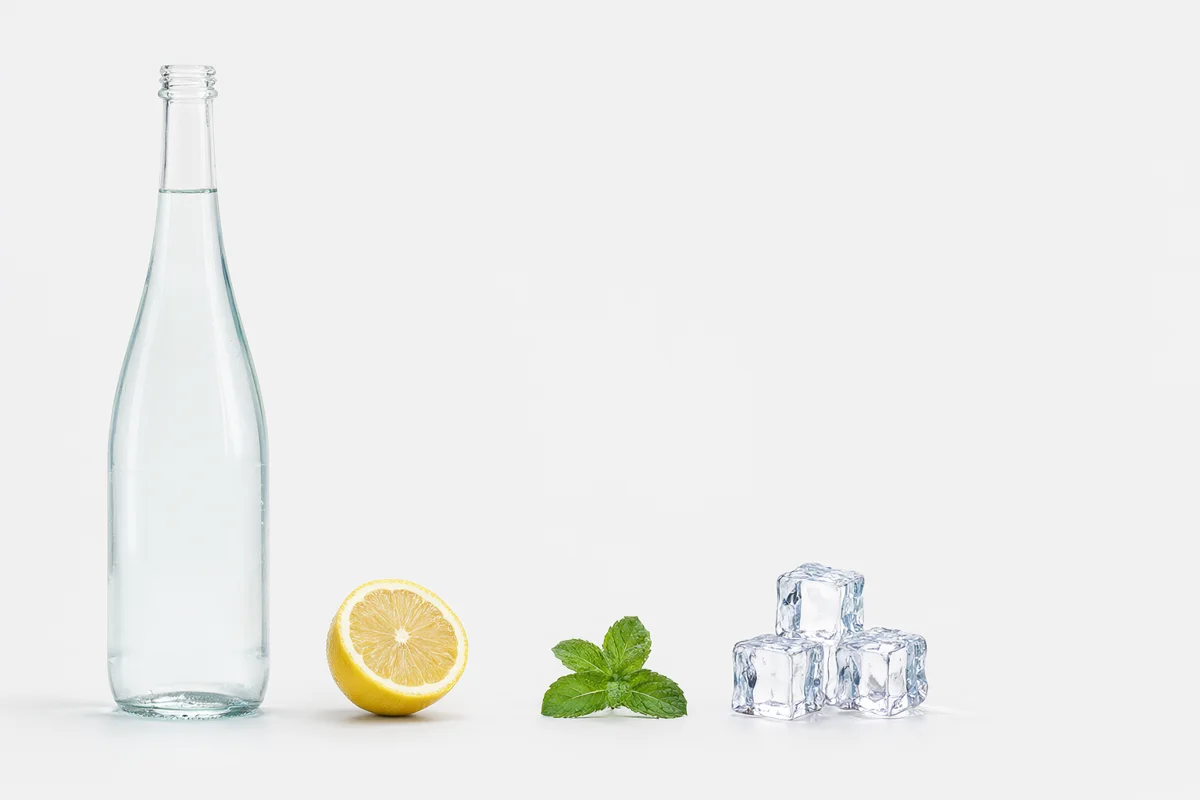
Die generierten Szenen wirken stimmig und enthalten alle geforderten Elemente. Allerdings arrangiert das Modell die Komposition nach eigenen ästhetischen Kriterien und ignoriert präzise Prozentvorgaben weitgehend. Wenn Sie Freiflächen für Logos oder Texte exakt einplanen müssen, bieten Modelle wie FLUX 3 mit Bounding-Boxes oder Seedream deutlich mehr Kontrolle.
Test 3: Detailtreue im Großformat
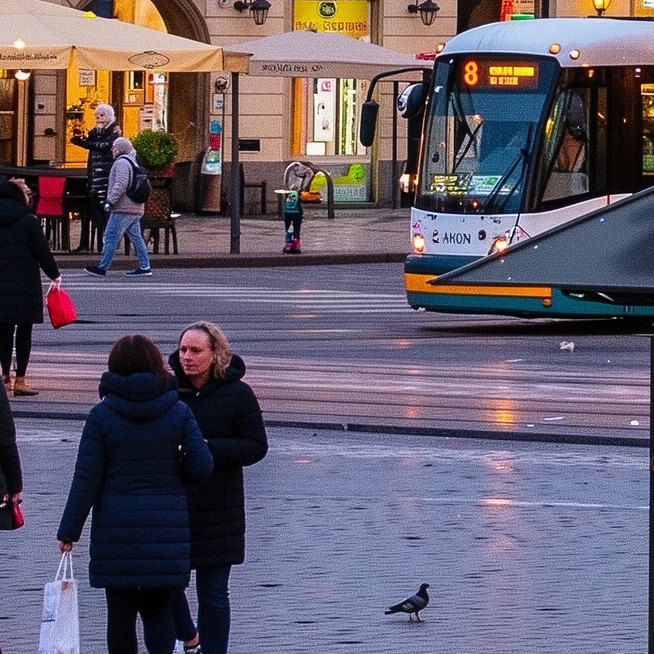
Getestet wurde eine urbane Straßenszene mit sechs Geschäftsschildern, einem Kiosk und einer Straßenbahn. Qwen-Image-2.1 erzeugte die Szene im maximalen nativen 16:9-Format von 2752 × 1536 Pixeln in 49 Sekunden. Die effektiv nutzbare Detailauflösung lag bei rund 3,1 Megapixeln, vergleichbar mit Grok Imagine 2 (3,3 MP). Von 8 kleinen Textstellen blieben lediglich 2 lesbar. Kleinere Firmenschilder im Hintergrund verschwammen zu unleserlichen Flecken.
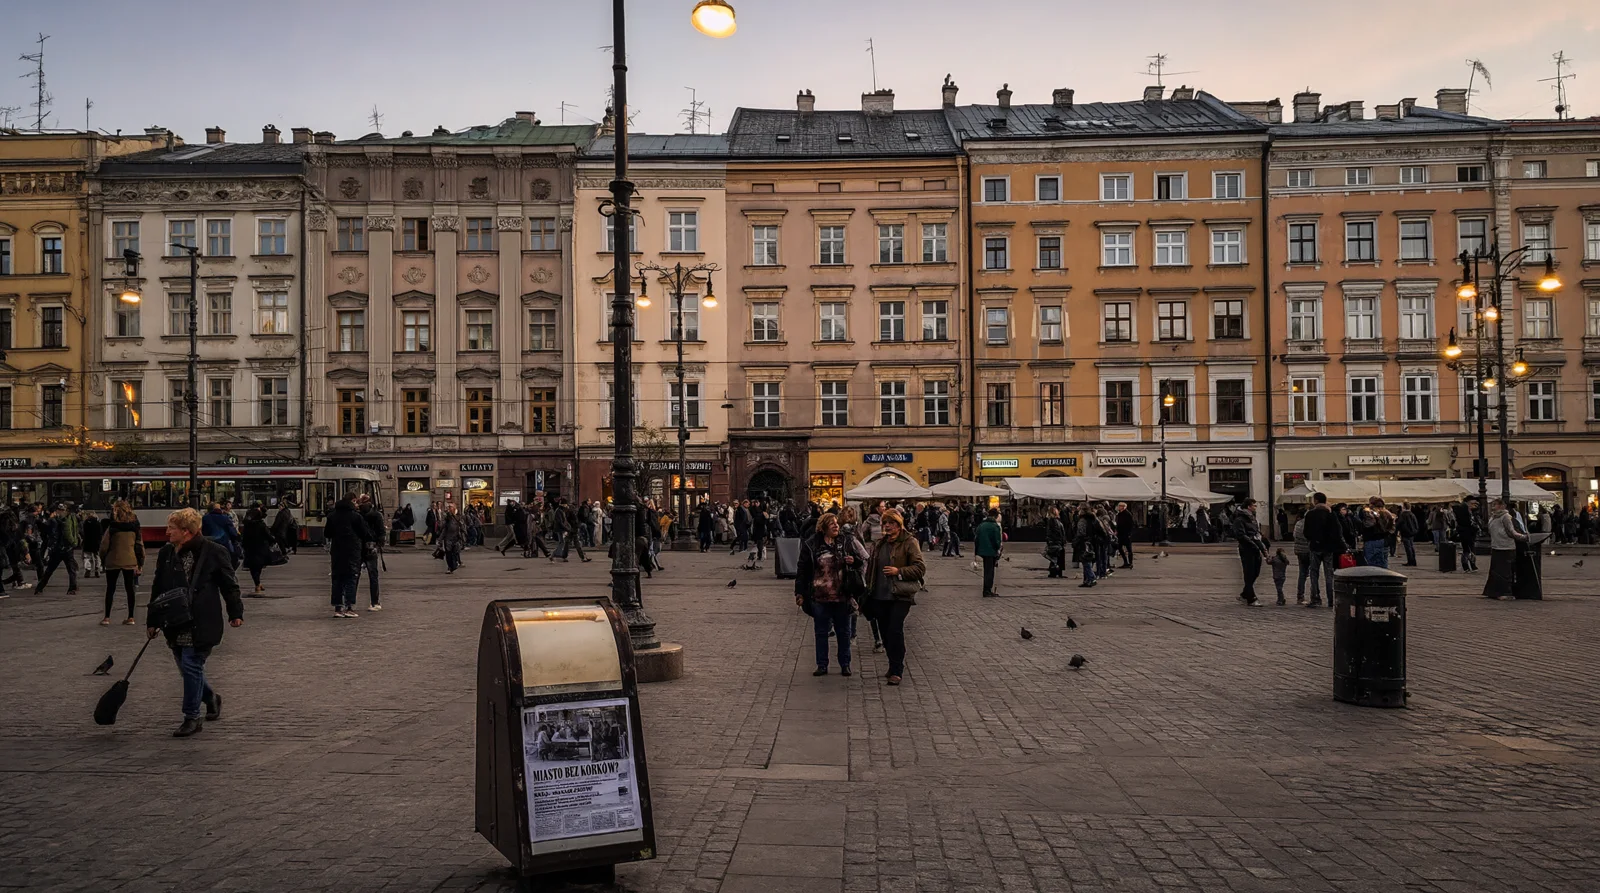
Test 4: 10 sequentielle Bildbearbeitungen
Ausgehend von der Außenansicht einer Bäckerei wurden nacheinander 10 Modifikationen vorgenommen: Türfarbe ändern, Aufkleber anbringen, Fahrrad durch Roller ersetzen, Auto entfernen, neues Schild, Lavendel ergänzen, Mantel anpassen, Katze hinzufügen, Preisschild ändern und Mülleimer entfernen. Jeder Bearbeitungsschritt baute direkt auf der Ausgabedatei des vorherigen Schritts auf. Gemessen wurde die strukturelle Bildähnlichkeit (SSIM, 1,0 = unverändert) in Bildbereichen, die laut Prompt nicht verändert werden sollten.
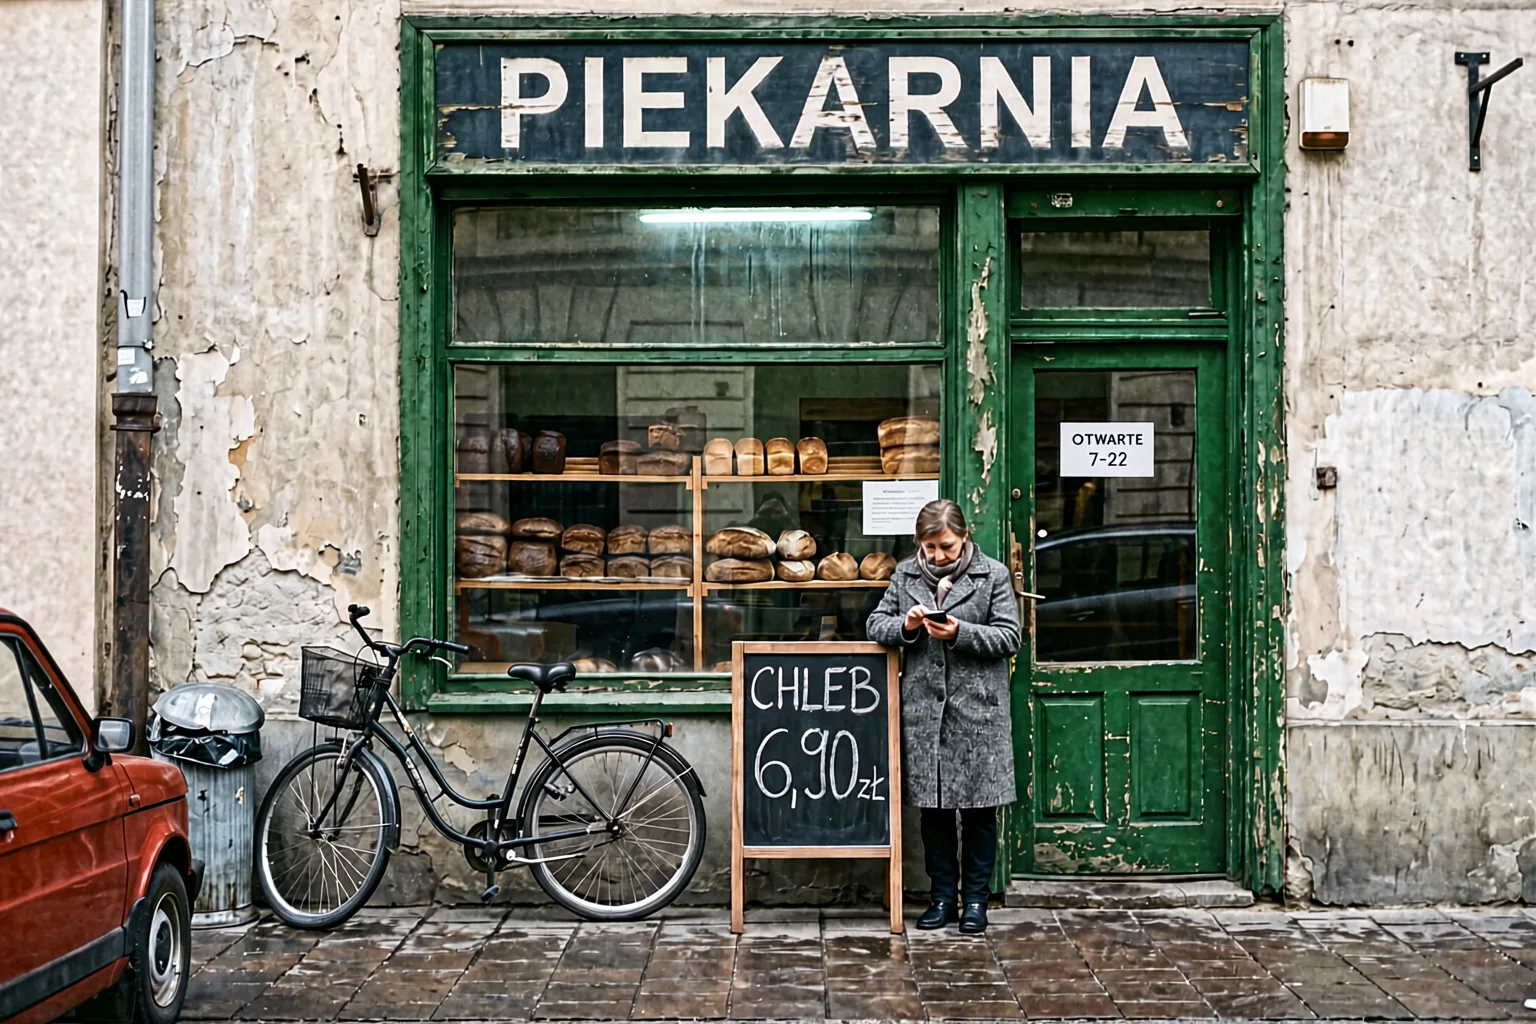
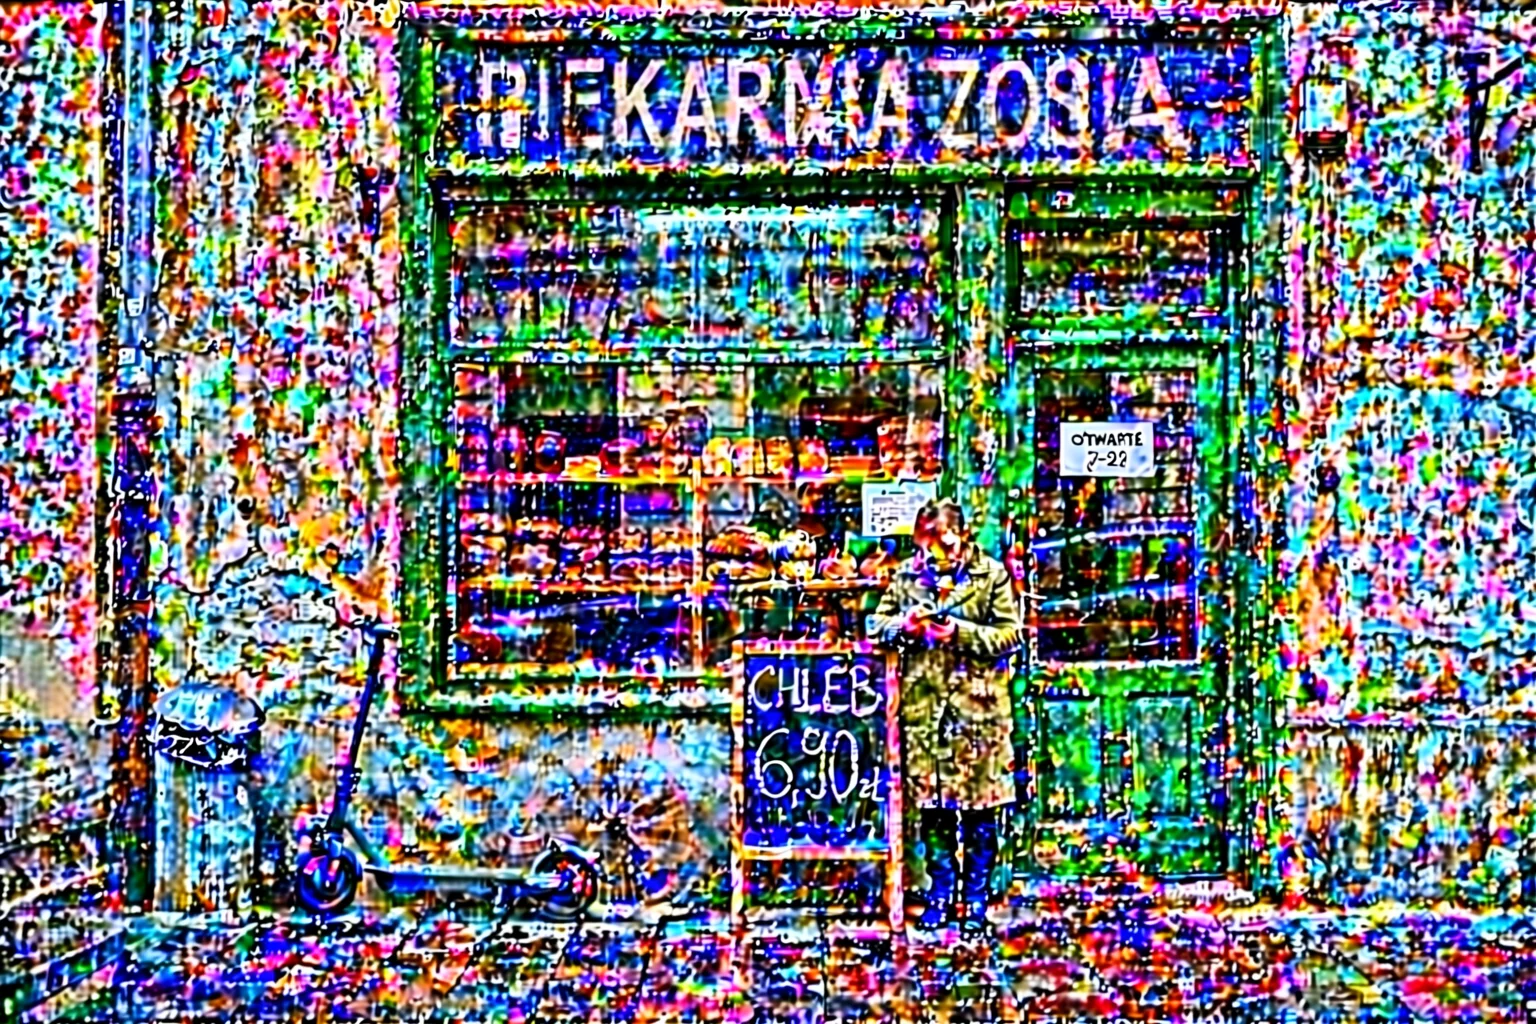
Die inhaltlichen Befehle setzt Qwen-Image-2.1 präzise um: Die Tür färbte sich grün, das Fahrrad wich einem Roller und das Auto verschwand. Jedoch führt jeder zusätzliche Kodierungsdurchlauf zu sichtbarem Rauschen und übersättigten Farben. Ab dem dritten Schritt treten deutliche Artefakte auf, nach dem sechsten ist das Bild kaum noch brauchbar. Ein einzelner Bearbeitungsschritt gelingt hingegen sauber - das erklärt auch das gute Abschneiden im Artificial-Analysis-Editing-Leaderboard, das primär Einzelschritte bewertet.
Hinweis zur Konfiguration: Getestet wurde das int8-Modell in ComfyUI. Wurde die Referenzauflösung mit 1024 Pixeln bei einer Ausgabe von 2048 Pixeln gewählt, baute sich das Rauschen noch rapider auf (SSIM 0,08). Eine Angleichung der Auflösungen reduzierte das Problem, beseitigte es jedoch nicht. Ob ein voller bf16-Durchlauf oder alternative Sampler-Parameter sauberere Ergebnisse liefern, konnte nicht verifiziert werden, da die unquantisierte Variante samt Text-Encoder die 24 GB VRAM der RTX 4090 übersteigt.
Praxistipp: Wollen Sie mehrere Änderungen vornehmen, bearbeiten Sie idealerweise stets das Originalbild mit einem einzigen kombinierten Prompt, anstatt aufeinanderfolgende Bearbeitungsketten zu generieren.
Fazit und Empfehlungen
- Für schnelle, ansprechende Motive ohne Schriftzüge: Hier überzeugt Qwen-Image-2.1 vollauf. 6 Sekunden Renderzeit pro 1K-Bild, keine laufenden API-Kosten und eine hohe ästhetische Qualität.
- Für präzise Typografie: Modelle wie GPT Image 2.5 oder Nano Banana Pro bleiben bei Texten deutlich zuverlässiger.
- Für exakte Layout-Kontrolle: FLUX 3 mit Bounding-Box-Steuerung liefert die verlässlichste Positionierung.
- Für mehrstufige Bildbearbeitungen: Ideogram 4.5 oder FLUX 3 halten unveränderte Bildinhalte stabil intakt.
- Lizenz beachten: Die Qwen-Research-Lizenz gestattet ausschließlich Forschung und Evaluierung. Für kommerzielle Nutzung ist eine gesonderte Vereinbarung mit Alibaba erforderlich - Details finden Sie im Beitrag zur Lizenz.
Eine Gesamtübersicht frei zugänglicher Modelle bietet unser Ranking der Open-Weights-Bildmodelle. Die Hintergründe zur Einstufung bei Artificial Analysis beleuchten wir in einer separaten Meldung.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Häufige Fragen (FAQ)
Ist Qwen-Image-2.1 besser als Nano Banana Pro?
Im Elo-Ranking von Artificial Analysis nicht: Nano Banana Pro führt mit 1101 Punkten gegenüber 1034 Punkten für Qwen-Image-2.1. In unseren Tests erzielte Nano Banana Pro eine signifikant höhere Trefferquote bei Textdetails (13 vs. 6) und bei der Einhaltung von Raumvorgaben. Qwen punktet dagegen bei der lokalen Offline-Nutzung ohne API-Kosten.
Wie lange dauert die Bildberechnung auf einer RTX 4090?
In meinen Messungen benötigte das Modell rund 6 Sekunden für 1024 × 1024 Pixel, 10 Sekunden für 1536 × 1024 Pixel, 44 Sekunden für 2048 × 2048 Pixel und 49 Sekunden für 2752 × 1536 Pixel. Eine Bildbearbeitung bei 1536 × 1024 Pixeln nahm etwa 20 Sekunden in Anspruch. Der erste Durchlauf nach dem Modellstart dauert bedingt durch Ladezeiten länger.
Warum leidet die Bildqualität bei sequentiellen Bearbeitungen?
Bei jedem Schritt wird das Bild erneut kodiert und dekodiert, wodurch sich Kompressions- und Sampling-Ungenauigkeiten kaskadierend verstärken. Spezialisierte Modelle wie Ideogram 4.5 oder FLUX 3 nutzen Maskierungs- und Erhaltungsmechanismen für unveränderte Pixel, die Qwen-Image-2.1 in dieser ComfyUI-Pipeline nicht bereitstellt.
Darf Qwen-Image-2.1 kommerziell im Unternehmen eingesetzt werden?
Nein, nicht ohne individuelle Zusatzvereinbarung. Die offizielle Qwen-Research-Lizenz beschränkt die Verwendung ausdrücklich auf Test- und Forschungszwecke.
- Artificial Analysis - Leaderboard Text-to-Image
- Artificial Analysis - Leaderboard Image Editing
- Hugging Face - Modellseite Qwen-Image-2.1
- Eigene Benchmarks vom 1. bis 2. Oktober 2026: Skripte, Bildanalysen und Metriken (OCR, IoU, SSIM, effektive Auflösung)
 Airbus zieht seine Daten aus der US-Cloud - und ich frage mich, warum wir Privatkunden das nicht laengst tunTechnik
 Das vergessene Rezept: Warum die Hälfte der Menschen die wirksamste Medizin gegen Demenz nicht kenntMedizin
 Das Cloud-Rechenzentrum aus 2000 alten Smartphones: ein Ausweg aus dem CO₂-Dilemma?Klima
More on this from WISSNOX