Gemma 4 31B lokal auf RTX 4090: VRAM, Tempo und Test
Google Gemma 4 31B auf der RTX 4090 im Härtetest: 42 Token/s, 19 GB VRAM, Apache-2.0-Lizenz und Praxiserfahrungen bei der Einrichtung mit Ollama.
👁 112 Aufrufe
Gemma 4 31B von Google ist das derzeit leistungsfähigste dichte Open-Weights-Modell, das vollständig auf einer einzelnen RTX 4090 Platz findet. Wir haben das Modell via Ollama auf unserem Testsystem eingerichtet: Es liefert rund 42 Token pro Sekunde und erreichte in unserem Sprachtest 9,5 von 10 Punkten. Allerdings belegt es fast die gesamten 24 GB Grafikspeicher und verzeiht keine langsamen Festplatten. Dies ist der Auftakt unserer Testreihe „Modell der Woche auf Ihrem PC“.
Stand: 8. Oktober 2026
- Modell:
gemma4:31b-it-qatin Ollama 0.40.1 (Quantization-Aware-Training-Variante, 17,65 GB Modelldatei + 1,2 GB Vision-Modul). - Lizenz: Apache 2.0 - uneingeschränkt kommerziell nutzbar.
- Geschwindigkeit: 40,7-43,4 tok/s bei der Generierung, ca. 870-1240 tok/s bei der Prompt-Verarbeitung.
- Grafikspeicher: 19,2 GB laut Ollama, GPU-Spitze 24,0 GB (nvidia-smi).
- Sprachbewertung: 9,5/10 Punkten in 5 Testaufgaben (wir haben das Modell auf Polnisch getestet).
- Download: 40 Min. 41 Sek. Ladezeit von externer Festplatte: 1 Min. 53 Sek. bis 14 Min. 33 Sek.
Warum Gemma 4 31B den Anfang macht
Wir testen regelmässig offene Modelle auf einer RTX 4090 (24 GB VRAM, Windows 11) unter identischen Bedingungen: Installation, Ladezeit, Inferenzgeschwindigkeit, VRAM-Belegung, Sprachfähigkeiten und Lizenzbedingungen. Für diesen Testdurchlauf standen mehrere aktuelle Kandidaten im Raum, von denen die meisten vorab ausschieden:
- Ling 3.1 Flash - besitzt 560 Milliarden Parameter und bietet derzeit keine offenen Gewichte (Details in unserem Beitrag zu Ling 3.1 Flash).
- Mistral Small 4 - umfasst trotz des Namens 119 Milliarden Parameter und passt selbst stark quantisiert nicht in 24 GB VRAM.
- GLM 5.3 - eine schlanke „Air“-Version existiert nicht, und das kleinste GLM-5.3 Flash arbeitet mit 320 Milliarden Parametern.
- Hy Image 3.5 - Tencent stellt lediglich eine API-Vorschau bereit, Modelldateien fehlen.
- Qwen 3.8 27B - haben wir bereits in unserem Vergleich von 7 lokalen Modellen analysiert.
Gemma 4 31B ist seit dem Frühjahr verfügbar, fehlte bisher jedoch in detaillierten Hardware-Messungen. Es ist das grösste Modell der Gemma-4-Reihe und das einzige vollwertige dichte (Dense) Modell dieser Leistungsklasse, das sich auf einer regulären Consumer-Grafikkarte betreiben lässt.
Modellkarte: Technische Daten der Gemma 4 31B
| Eigenschaft | Gemma 4 31B |
|---|---|
| Entwickler | Google DeepMind |
| Parameter | 30,7 Mrd., dichtes Modell (alle Parameter bei jedem Token aktiv) |
| Kontextfenster | bis zu 256.000 Token |
| Modalität | Eingabe: Text und Bild; Ausgabe: nur Text |
| Sprachen | über 140 im Trainingskorpus, ca. 35 sofort einsatzbereit laut Google |
| Lizenz | Apache 2.0 |
| In Ollama verfügbar | gemma4:31b-it-qat (Q4_0, 19 GB), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 GB) |
| Empfohlene Parameter | temperature 1.0, top_p 0.95, top_k 64 |
Die QAT-Version (Quantization-Aware Training) wurde gezielt für 4-Bit-Quantisierung optimiert und verliert spürbar weniger Präzision als nachträglich komprimierte 4-Bit-Versionen. Für 24 GB VRAM ist sie die einzig praktikable Wahl, da der q8-Build bereits über 30 GB beansprucht.
Benchmark-Ergebnisse auf der RTX 4090
| Messung | Ergebnis | Anmerkungen |
|---|---|---|
| Download (18,2 GB) | 40 Min. 41 Sek. | Übertragungsrate schwankte zwischen 4 und 29 MB/s |
| Erster Modellstart | Fehler nach 5 Min. | „timed out waiting for llama-server to start“ - siehe Hinweis unten |
| Laden von USB-Laufwerk | 8 Min. 32 Sek. und 14 Min. 33 Sek. | Laufwerk D: über USB, ca. 44-66 MB/s |
| Laden aus System-Cache | 1 Min. 53 Sek. | Datei lag nach vorheriger Nutzung noch im RAM |
| Generierungsrate (5 Aufgaben) | 40,7-43,4 tok/s | Kontext 8192 Token, ohne Thinking-Modus |
| Langer Text (1438 Token) | 41,3 tok/s | ca. 800 Wörter in 35 Sekunden |
| Generierung bei 32.768 Kontext | 42,2 tok/s | keinerlei Einbruch der Verarbeitungsrate |
| Prompt-Verarbeitung (Reading) | 870-1240 tok/s | erste Anfrage langsamer (24 tok/s, Aufwärmphase) |
| VRAM-Bedarf laut Ollama | 19,2 GB (8k) / 19,3 GB (32k) | 100 % vollständig auf GPU ausgelagert |
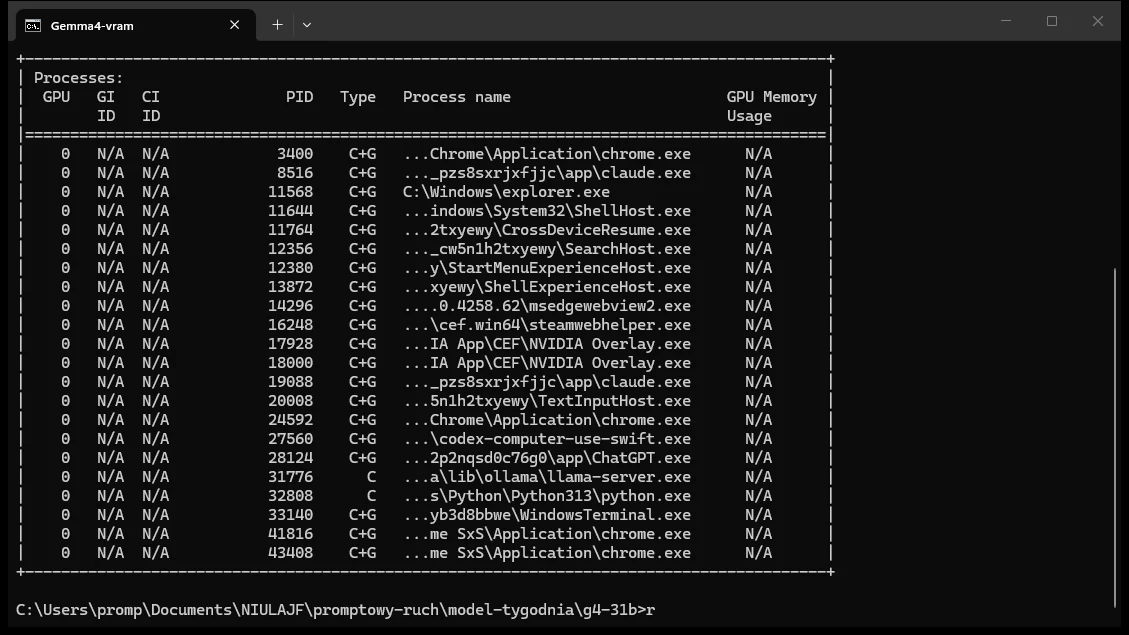
| Gesamte GPU-Auslastung (nvidia-smi) | 21,8 GB nach dem Laden, 24,0 GB Spitze | inkl. Windows-Desktop und Browser (ca. 0,8 GB Grundlast) |
Eine Generierungsrate von 41 bis 43 Token pro Sekunde übertrifft normales Lesetempo deutlich. Zum Vergleich: In unserem Test lokaler KI-Modelle erreichte das kompaktere Gemma 4 12B rund 104 tok/s bei 8 GB VRAM. Qwen 3.8 27B arbeitete etwa halb so schnell wie das 12B-Modell und belegte 17 GB. Das 31B-Modell ist damit das langsamste dieses Trios, bleibt für interaktive Dialoge aber absolut flüssig nutzbar.
Wichtige Erkenntnis: Kein Multitasking auf derselben GPU
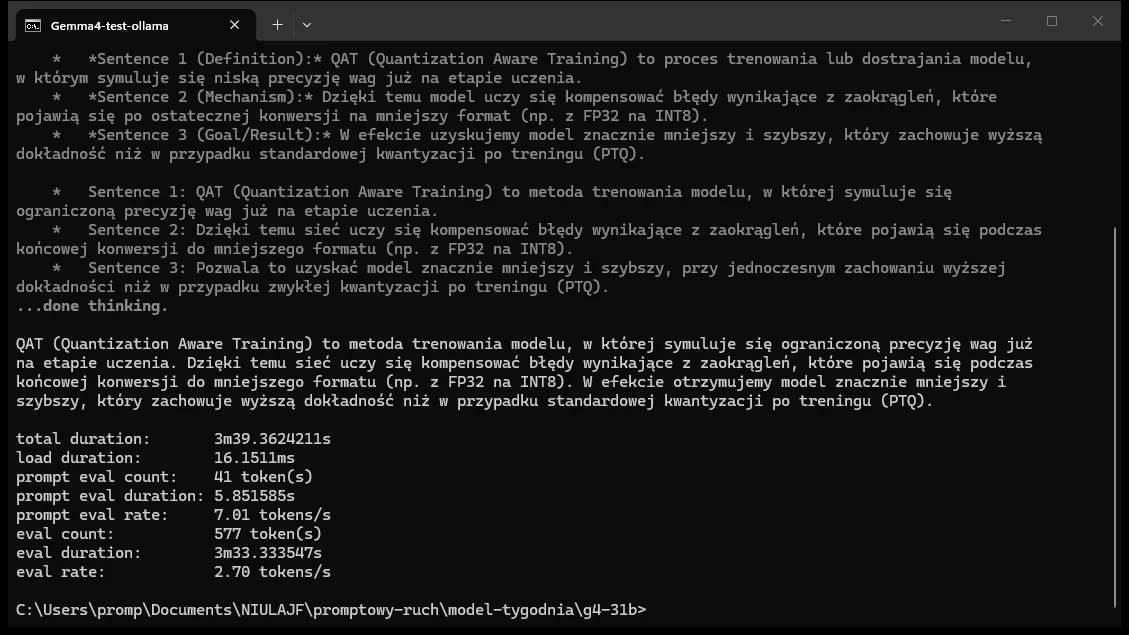
Während unserer Tests startete parallel eine Bildgenerierung in ComfyUI auf derselben Grafikkarte. Der Grafikspeicher lief voll (23,9 von 24 GB), Windows lagerte Speicherbereiche in den regulären Arbeitsspeicher aus, und die Generierungsgeschwindigkeit brach drastisch von 42 auf 2,7 tok/s ein, im darauffolgenden Versuch sogar auf 0,5 tok/s. Das 31B-Modell lässt keinerlei Puffer: Parallele Workloads wie Bildgeneratoren sind unmöglich, und selbst ein Webbrowser mit vielen geöffneten Tabs kann bereits zu viel VRAM blockieren.
Sprachqualität im Test: 5 Aufgaben auf Polnisch
Wir haben das Modell auf Polnisch getestet. Um eine exakte Vergleichbarkeit über kommende Modelltests zu gewährleisten, durchläuft jeder Kandidat dieselben fünf anspruchsvollen sprachlichen Aufgaben. Jede Disziplin wird mit 0 bis 2 Punkten bewertet.
| Aufgabe | Punkte | Beobachtungen im Test |
|---|---|---|
| Entschuldigungs-E-Mail (komplexe Namen/Orte) | 1,5/2 | Ortsbeugung fehlerfrei, 10 % Rabattcode enthalten, aber Nachname in Anrede ausgelassen |
| Textkorrektur (8+ Grammatik-/Tippfehler) | 2/2 | Alle Fehler identifiziert: Flexion, Getrenntschreibung, Sonderzeichen und 5 Kommas |
| Rechnungskalkulation: 3 Posten, 23 % und 5 % MwSt. | 2/2 | MwSt. 1314,00, brutto 7073,90 - mathematisch auf zwei Nachkommastellen exakt |
| 5 Wissensfragen zum Land | 2/2 | Verwaltungssitze, Autor, Berggipfel (2499 m), Jahreszahl 1410 und Regionenanzahl korrekt |
| 3 Redewendungen mit Kontextbeispielen | 2/2 | Bedeutungen treffend erfasst und in natürliche Beispielsätze eingebettet |
| Gesamt | 9,5/10 |
Zwei rein formale Besonderheiten fielen auf: Das Modell nutzt exzessiv Markdown-Formatierungen und gab bei der Korrektur LaTeX-Pfeile ($rightarrow$) aus, die in Standard-Terminals nicht gerendert werden. Im standardmässig aktiven Thinking-Modus formuliert das Modell seine Überlegungen intern auf Englisch, bevor es die finale Antwort ausgibt.
E-Mail-Entschuldigung - vollständige Ausgabe (185 Token, 42,5 tok/s)
Prompt (wir haben auf Polnisch getestet): Napisz krótki e-mail (do 120 słów) do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna, z przeprosinami za 5-dniowe opóźnienie dostawy krzesła biurowego. Zaproponuj rabat 10% na kolejne zamówienie. Ton uprzejmy, bez przesady. Użyj poprawnej odmiany nazwiska i nazwy miejscowości.
Deutsche Übersetzung: Verfassen Sie eine kurze E-Mail (bis 120 Wörter) an den Kunden Grzegorz Brzęczyszczykiewicz aus Szczebrzeszyn mit einer Entschuldigung für 5 Tage Lieferverzögerung eines Bürostuhls. Bieten Sie 10 % Rabatt auf die nächste Bestellung an. Höflicher Ton. Nutzen Sie die korrekte Deklination von Name und Ort.
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Textkorrektur - vollständige Ausgabe (306 Token, 40,7 tok/s)
Prompt (wir haben auf Polnisch getestet): Popraw błędy w tekście i wypisz listę poprawek (każda w osobnym punkcie: było -> jest). Tekst: „Wczoraj poszłem do sklepu żeby kupić chleb, ale okazało się że był zamknięty. W poniedziałek napewno pójde jeszcze raz, bo mam nadzieje że będzie otwarte. Moja koleżanka która tam pracuje mówiła, że wogóle nie zamykają przed 18.„
Deutsche Übersetzung: Korrigieren Sie die Fehler im Text und listen Sie die Änderungen stichpunktartig auf (Format: vorher -> nachher). Text: […]
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $rightarrow$ na pewno (pisownia rozdzielna)
* pójde $rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $rightarrow$ w ogóle (pisownia rozdzielna)
Rechnungsberechnung - vollständige Ausgabe (176 Token, 41,4 tok/s)
Prompt (wir haben auf Polnisch getestet): Policz fakturę. Pozycje netto: laptop 4200,00 (VAT 23%), książka 59,90 (VAT 5%), usługa szkolenia 1500,00 (VAT 23%). Podaj VAT dla każdej pozycji, sumę netto, sumę VAT i sumę brutto. Kwoty zaokrąglaj do grosza. Na końcu jedna linia: BRUTTO = …
Deutsche Übersetzung: Berechnen Sie eine Rechnung. Nettopositionen: Laptop 4200,00 (23 % MwSt.), Buch 59,90 (5 % MwSt.), Schulungsdienstleistung 1500,00 (23 % MwSt.). Geben Sie die MwSt. je Posten, Nettosumme, MwSt.-Summe und Bruttosumme an. Runden Sie auf zwei Nachkommastellen. Letzte Zeile: BRUTTO = …
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 $rightarrow$ VAT (23%): 966,00
*   Książka: netto 59,90 $rightarrow$ VAT (5%): 3,00
*   Usługa szkolenia: netto 1500,00 $rightarrow$ VAT (23%): 345,00

Suma netto: 5759,90
Suma VAT: 1314,00
Suma brutto: 7073,90

BRUTTO = 7073,90
5 Wissensfragen - vollständige Ausgabe (60 Token, 43,4 tok/s)
Prompt (wir haben auf Polnisch getestet): Odpowiedz krótko na 5 pytań, każde w jednej linii: 1) Jakie miasta są siedzibami władz województwa lubuskiego? 2) Kto napisał „Lalkę„? 3) Jak wysoki jest najwyższy szczyt Polski i jak się nazywa? 4) W którym roku odbyła się bitwa pod Grunwaldem? 5) Ile województw ma Polska?
Deutsche Übersetzung: Beantworten Sie 5 Fragen kurz in je einer Zeile: 1) Welche Städte sind Sitze der Woiwodschaft Lebus? 2) Wer schrieb „Lalka“? 3) Wie hoch ist der höchste Berg Polens und wie heisst er? 4) In welchem Jahr fand die Schlacht bei Tannenberg/Grunwald statt? 5) Wie viele Woiwodschaften gibt es?
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Redewendungen - vollständige Ausgabe (303 Token, 42,0 tok/s)
Prompt (wir haben auf Polnisch getestet): Wyjaśnij prostym językiem znaczenie trzech polskich frazeologizmów i do każdego podaj jedno zdanie przykładowe: „wyjść jak Zabłocki na mydle„, „rzucać grochem o ścianę„, „mieć muchy w nosie„.
Deutsche Übersetzung: Erklären Sie in einfacher Sprache die Bedeutung von drei Redewendungen und nennen Sie je einen Beispielsatz: „wyjść jak Zabłocki na mydle“ (ein schlechtes Geschäft machen), „rzucać grochem o ścianę“ (auf taube Ohren stossen), „mieć muchy w nosie“ (schlechte Laune haben).
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Apache-2.0-Lizenz: Was ist erlaubt?
Gemma 4 wird unter der Apache-2.0-Lizenz bereitgestellt. Dies markiert einen wesentlichen Unterschied zur Vorgängergeneration Gemma 3, die an restriktive Nutzungsbedingungen von Google gebunden war. Für Anwender bedeutet das:
- Kommerzielle Nutzung ist uneingeschränkt gestattet, auch als Backend in Kundenprodukten.
- Fine-Tuning sowie die Weitergabe modifizierter Modellgewichte sind erlaubt (unter Beibehaltung der Lizenzhinweise).
- Keine API-Gebühren an Google: Es fallen ausschliesslich die eigenen Strom- und Hardwarekosten an.
Schritt-für-Schritt-Anleitung für Ollama
- Ollama installieren: Laden Sie die Software von ollama.com herunter (in unserem Test Version 0.40.1). Wenn Sie Modelle auf einem separaten Datenträger speichern, passen Sie die Umgebungsvariable
OLLAMA_MODELSan (z. B.D:AIollama). Mehr dazu in unserer Ollama-Anleitung. - Modell herunterladen (ca. 18 GB):
ollama pull gemma4:31b-it-qat
- Lade-Timeout verlängern: Standardmässig bricht Ollama den Ladevorgang nach 5 Minuten ab. Von langsamen Datenträgern kann das Laden 8 bis 14 Minuten dauern, was zur Fehlermeldung „timed out waiting for llama-server to start“ führt. Beenden Sie Ollama und setzen Sie den Timeout in PowerShell hoch:
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
Empfehlung: Platzieren Sie das Modell idealerweise direkt auf einer schnellen NVMe-SSD.
- Starten und messen: Führen Sie das Modell in einem zweiten Terminalfenster aus:
ollama run gemma4:31b-it-qat --verbose "Erkläre in 3 Sätzen, was QAT-Quantisierung ist."
Der Parameter
--verbosegibt am Ende die „eval rate“ in Token pro Sekunde aus. Den Thinking-Modus können Sie bei Bedarf mit--think=falsedeaktivieren. - VRAM-Auslastung überprüfen:
ollama ps
nvidia-smi
In der Spalte PROCESSOR muss „100% GPU“ stehen. Erscheint hier ein CPU/GPU-Splitting, reduzieren Sie den Kontext oder schliessen Sie andere grafiklastige Anwendungen.
- Eigenes Kontextfenster via API ansteuern:
curl http://127.0.0.1:11434/api/chat -d "{"model":"gemma4:31b-it-qat","messages":[{"role":"user","content":"Hallo"}],"think":false,"options":{"num_ctx":32768}}" - Grafikspeicher freigeben:
ollama stop gemma4:31b-it-qat
Für wen lohnt sich Gemma 4 31B lokal?
- Empfohlen für Setups mit 24 GB VRAM (RTX 4090, RTX 3090, RTX 5090), wenn höchste Text- und Sprachqualität lokal ohne Datenübertragung an Cloud-Dienste verlangt wird.
- Empfohlen für die Analyse vertraulicher Dokumente, Textkorrekturen und Zusammenfassungen - 42 tok/s sind für Produktivarbeit vollkommen ausreichend.
- Nicht geeignet für Systeme mit 16 GB VRAM oder weniger. Greifen Sie hier zu Gemma 4 12B, das in unserem Vergleich rund 2,5-mal schneller lief.
- Nicht geeignet, wenn auf derselben GPU gleichzeitig Bild- oder Videogeneratoren betrieben werden sollen.
Einen Überblick über Text-, Bild- und Videomodelle finden Sie in unserer Übersicht zu lokaler KI; wie viel Speicher einzelne Modellgrössen beanspruchen, erläutern wir im Ratgeber zum VRAM-Bedarf lokaler Sprachmodelle.
Häufig gestellte Fragen (FAQ)
Wie viel VRAM benötigt Gemma 4 31B?
In der 4-Bit-QAT-Fassung belegt Ollama rund 19,2 GB bei 8.000 Token Kontext und 19,3 GB bei 32.000 Token. Unter Volllast lag die Gesamtauslastung der Karte bei 24,0 GB. Eine 24-GB-Grafikkarte ohne nennenswerte Hintergrundlast ist daher zwingende Voraussetzung.
Läuft Gemma 4 31B auf einer RTX 4090?
Ja, das Modell lässt sich vollständig im Grafikspeicher halten und erreicht 40 bis 43 Token pro Sekunde. Voraussetzung ist, dass keine anderen Programme VRAM beanspruchen; im Parallelbetrieb mit ComfyUI sank die Leistung auf 0,5 bis 2,7 tok/s.
Wie schlägt sich Gemma 4 31B bei anspruchsvollen Sprachtests?
Sehr stark: In unseren fünf Tests erzielte das Modell 9,5 von 10 Punkten ohne logische oder rechnerische Fehler. Lediglich in einer formellen E-Mail liess es den Nachnamen in der Begrüssung weg.
Darf Gemma 4 kommerziell genutzt werden?
Ja, die Apache-2.0-Lizenz erlaubt die kommerzielle Nutzung, Modifikation und Weiterverbreitung ohne Lizenzgebühren.
Warum schlägt das Laden in Ollama fehl?
Die häufigste Ursache ist ein langsamer Datenträger: Ollama bricht standardmässig nach 5 Minuten ab. Erhöhen Sie den Wert über OLLAMA_LOAD_TIMEOUT=30m oder verschieben Sie die Modelldateien auf eine NVMe-SSD. Zweite Fehlerquelle ist unzureichender VRAM durch andere aktive Anwendungen.
Gemma 4 31B oder 12B?
Auf einer 24-GB-GPU ist die 31B-Variante die erste Wahl für maximale Textqualität. Bei weniger VRAM oder Fokus auf maximale Geschwindigkeit empfiehlt sich die 12B-Version (104 tok/s bei 8 GB VRAM in unserem Test).
Quellen und Prüfdatum
- Modellkarte zu Gemma 4 31B auf Hugging Face (Lizenz, Parameter, empfohlene Konfiguration).
- Ollama Model Library: Gemma 4 Tags.
- Hardware-Messungen: Eigener Testaufbau (RTX 4090 24 GB, Windows 11, Ollama 0.40.1), Stand: 8. Oktober 2026.
More on this from WISSNOX

 benchmarks·YouTube-Thumbnails mit AI: Lesbarkeit auf Smartphones im TestSechs AI-Thumbnails im Test bei 320 Pixeln Breite: Welche Schriftzüge auf Smartphones lesbar bleiben und was Designs unleserlich macht.