Gemini 4 Argon Preise: API ab 2 USD und Google-AI-Abos
Gemini 4 Argon kostet im API zunächst 2/10 USD, ab Dezember 4/20 USD pro 1M Token. Analyse der Testkosten und Vergleich mit Google-AI-Plänen.
👁 119 Aufrufe
Gemini 4 Argon kostet in der API ca. 1,79 EUR (2 USD) pro Million Eingabe-Token und ca. 8,94 EUR (10 USD) pro Million Ausgabe-Token - allerdings nur bis zum 30. November 2026. Ab dem 1. Dezember verdoppeln sich die Preise auf ca. 3,58 EUR (4 USD) bzw. ca. 17,89 EUR (20 USD). Zudem ist Argon in Google-AI-Tarifen wie Google AI Pro (in Deutschland 21,99 EUR/Monat) und Ultra (ab 99,99 EUR/Monat) verfügbar. Ich habe nachgerechnet, was Aufgaben aus meinen Praxistests vom 13. Oktober 2026 real kosten und wann sich welche Option lohnt. Eine Übersicht des Modells finden Sie im Leitfaden Gemini 4. Hinweis zu Währungsumrechnungen: USD-Werte wurden zum EZB-Referenzkurs vom 12.10.2026 (1 EUR = 1,1181 USD, Quelle: EZB) als Schätzwerte umgerechnet.
API-Preise: Startangebot und Tarife ab 1. Dezember
Preise der offiziellen Gemini-API-Preisliste pro 1 Million Token, geprüft am 13.10.2026:
| Position | bis 30.11.2026 | ab 1.12.2026 |
|---|---|---|
| Eingabe (Input) | 2 USD (ca. 1,79 EUR) | ca. 3,58 EUR (4 USD) |
| Ausgabe (Output, inkl. Reasoning-Token) | 10 USD (ca. 8,94 EUR) | ca. 17,89 EUR (20 USD) |
| Zwischengespeicherte Eingabe (Cache) | 0,10 USD (ca. 0,0894 EUR) | ca. 0,1789 EUR (0,20 USD) |
| Batch und Flex: Eingabe / Ausgabe | 1 / 5 USD (ca. 0,89 / 4,47 EUR) | 2 / 10 USD (ca. 1,79 / 8,94 EUR) |
Drei Details der Preisliste, die leicht übersehen werden:
- Reasoning-Token zählen als Ausgabe zum Satz von 10 USD pro Million (ab 1.12. 20 USD).
- Caching erfolgt ausschliesslich automatisch („implicit caching only“). Sie können den Cache nicht manuell erzwingen. Den Rabatt von 95% erhalten Sie also nur, wenn Google einen wiederholten Beginn der Anfrage selbstständig erkennt.
- Es gibt kein kostenloses API-Kontingent. Im Free-Tier steht bei Argon „Not available“, und das Google AI Pro Abonnement beinhaltet keinen API-Zugriff.
Derselbe Einführungspreis gilt auch auf OpenRouter (google/gemini-4-argon), worüber ich die Tests durchgeführt habe.
Gemeinsames 1M-Limit: Die Auswirkungen auf die Rechnung
Google präzisiert mittlerweile, dass Argon über ein „1M unified input-output token limit“ verfügt, also ein gemeinsames Limit von einer Million Token für Eingabe und Ausgabe zusammen. Nach der Ankündigung vom 30. September hatte ich von einer Million Token rein auf der Ausgabeseite berichtet - das war ungenau. Beispiele:
- Sie übermitteln ein Dokument mit 900.000 Token: Für die Antwort verbleiben 1.000.000 - 900.000 = 100.000 Token.
- Maximal lange Antwort bei kurzer Frage: knapp 1 Mio. Token x 10 USD / 1 Mio. = ca. ca. 8,94 EUR (10 USD) für einen einzigen Aufruf (ab 1.12. ca. 20 USD bzw. ca. 17,89 EUR).
- Maximal langer Input: 1 Mio. x 2 USD / 1 Mio. = 2 USD (ca. 1,79 EUR; ab 1.12.: 4 USD bzw. ca. 3,58 EUR), zuzüglich der Antwortkosten.
Was meine Tests gekostet haben
Alle Tests habe ich am 13.10.2026 über OpenRouter mit niedriger Denkstufe (effort=low) durchgeführt.
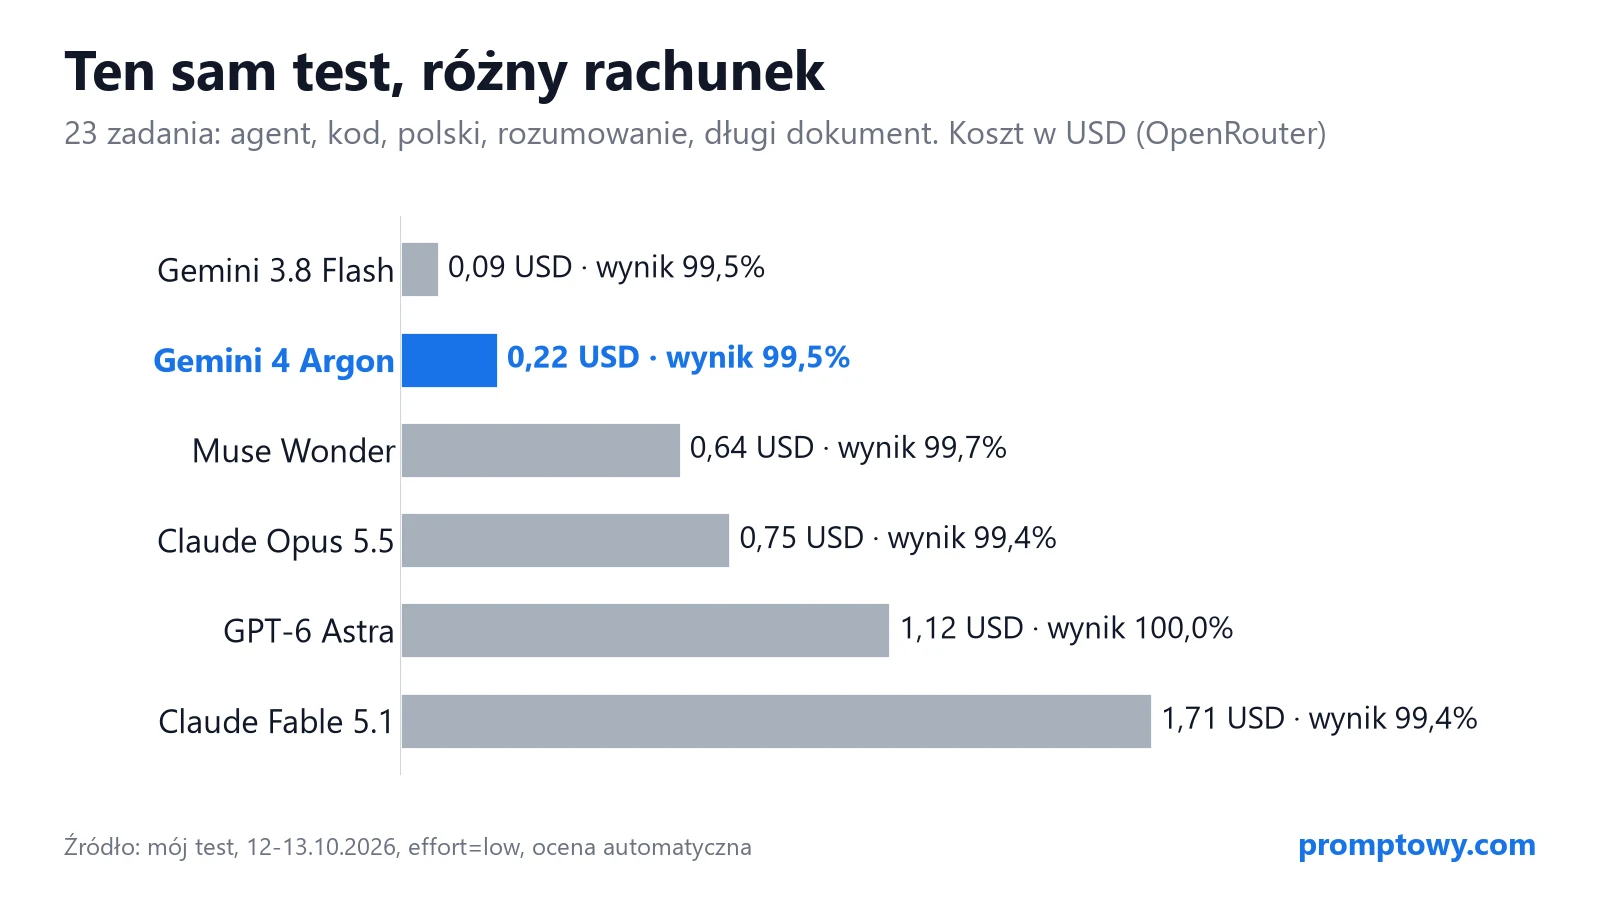
| Modell | Kosten 23 Aufgaben | Ergebnis | Gesamtdauer |
|---|---|---|---|
| Gemini 4 Argon | ca. 0,20 EUR (0,22 USD) | 99,5% | 135 s |
| Muse Wonder | ca. 0,57 EUR (0,64 USD) | 99,7% | 165 s |
| Claude Opus 5.5 | ca. 0,67 EUR (0,75 USD) | 99,4% | 222 s |
| GPT-6 Astra | ca. 1,00 EUR (1,12 USD) | 100% | 200 s |
| Claude Fable 5.1 | ca. 1,53 EUR (1,71 USD) | 99,4% | 263 s |
| Gemini 3.8 Flash | 0,09 USD (ca. 0,08 EUR) | 99,5% | 139 s |
Berechnungen für konkrete Arbeitsabläufe:
- Eine einzelne Aufgabe aus dem Duell: 0,22 USD / 23 = ca. ca. 0,0086 EUR (0,0096 USD). Ab dem 1.12. verdoppeln sich die Preise, womit das gesamte Set ca. ca. 0,39 EUR (0,44 USD) kosten wird - immer noch günstiger als Opus 5.5 mit 0,75 USD.
- Langes Dokument (158.111 Zeichen, 5 Fragen): Wir haben dies anhand eines polnischsprachigen Textes getestet. Argon erfasste ihn mit 51.482 Token. 51.482 x 2 USD / 1.000.000 = 0,103 USD, die gemessenen Gesamtkosten lagen bei ca. 0,09 EUR (0,10 USD), da fast der gesamte Anteil auf den Input entfiel. Ab dem 1.12.: 51.482 x 4 / 1.000.000 = ca. 0,19 EUR (0,21 USD). Derselbe Text belegte in Claude Opus 5.5 insgesamt 87.675 Token: 87.675 x 4 / 1.000.000 = ca. 0,31 EUR (0,35 USD), was exakt den abgerechneten Kosten entsprach.
- Folgefrage zum selben Dokument mit Cache: 51.482 x 0,10 / 1.000.000 = ca. ca. 0,0045 EUR (0,005 USD) für den Input, vorausgesetzt, Google greift auf den Cache zu.
- Textgenerierung (Labor-Benchmark, 13 Antworten auf Polnisch getestet): 0,062 USD / 13 = ca. ca. 0,0043 EUR (0,0048 USD) pro Text. Tausend solcher Texte: 1.000 x 0,0048 = ca. ca. 4,27 EUR (4,77 USD), ab 1.12. ca. ca. 8,53 EUR (9,54 USD). Claude Opus 5.5 lag im selben Test bei 0,37 USD / 13 x 1.000 = ca. ca. 25,45 EUR (28,46 USD).
- Vier standardisierte Prüfungsbögen (Abitur-Format): ca. 0,51 EUR (0,57 USD), ab 1.12. ca. ca. 1,02 EUR (1,14 USD).
Die vollständigen Testresultate finden Sie im Bericht Gemini 4 Argon - Test.
Argon im Vergleich zu anderen Modellen
API-Preise pro 1 Million Token (Eingabe / Ausgabe):
| Modell | Eingabe | Ausgabe | Bemerkungen |
|---|---|---|---|
| Gemini 4 Argon | 2 USD (ca. 1,79 EUR) | 10 USD (ca. 8,94 EUR) | bis 30.11., danach 4 / 20 USD (ca. 3,58 / 17,89 EUR) |
| GPT-6.1 Sol | 2 USD (ca. 1,79 EUR) | 10 USD (ca. 8,94 EUR) | - |
| Gemini 3.1 Pro | 2 USD (ca. 1,79 EUR) | ca. 10,73 EUR (12 USD) | über 200.000 Token: 4 / 18 USD (ca. 3,58 / 16,10 EUR) |
| Claude Opus 5.5 | ca. 3,58 EUR (4 USD) | ca. 17,89 EUR (20 USD) | - |
| Muse Wonder | ca. 3,58 EUR (4 USD) | ca. 17,89 EUR (20 USD) | - |
| GPT-6 Astra | ca. 8,94 EUR (10 USD) | ca. 44,72 EUR (50 USD) | - |
| Claude Fable 5.1 | ca. 8,94 EUR (10 USD) | ca. 44,72 EUR (50 USD) | - |
Ab dem 1. Dezember erreicht Argon das Preisniveau von Opus 5.5 und Muse Wonder. Den Unterschied macht dann die Tokenisierung: Den von uns getesteten Text tokenisierte Claude mit rund 70% mehr Token als Argon. Bei gleichem nominellen Tokenpreis fällt die Gesamtrechnung bei Argon daher spürbar geringer aus als bei Claude.
Fallstrick: Hohe Reasoning-Stufe treibt den Tokenverbrauch
Meine Tests erfolgten auf niedriger Denkstufe (effort=low), bei der OpenRouter keine Reasoning-Token auswies. Bei maximaler Einstellung ändert sich das drastisch. Laut Messungen von Artificial Analysis verbrauchte Argon für deren gesamten Index 110 Millionen Token bei einem Median von 82 Millionen Token. Das entspricht dem 1,34-fachen (110 / 82), also 34% mehr als bei einem durchschnittlichen Modell. Die Kosten für eine Index-Aufgabe belaufen sich auf:
- Gemini 4 Argon zum Startpreis: ca. 1,78 EUR (1,99 USD),
- Gemini 4 Argon ab 1.12.: ca. 3,56 EUR (3,98 USD),
- GPT-6 Astra: ca. 2,92 EUR (3,26 USD).
Bis zum 30.11. ist Argon hier um rund 39% günstiger als Astra (1 - 1,99 / 3,26). Ab Dezember liegt es mit 3,98 / 3,26 = 1,22 rund 22% über Astra. Die praktische Konsequenz: Günstige Basistarife pro Token nützen wenig, wenn Anfragen durchgehend auf maximaler Reasoning-Stufe verarbeitet werden. Für Standardaufgaben erwies sich die niedrige Stufe im Test als vollkommen ausreichend.
Verbraucher-Abonnements bei Google AI
Für Anwender, die das Modell direkt im Web-Interface und den Google-Workspace-Apps nutzen wollen, bietet Google offizielle Verbrauchertarife an (beobachtete Preise in Deutschland am 12.10.2026 laut Google AI Pläne):
- Kostenlose Version: Modell 3.5 Flash-Lite, kein Zugriff auf Argon.
- Google AI Plus (ab 4,99 EUR monatlich): Modell 3.6 Flash, doppelt so hohe Limits wie im Basistarif, ohne Argon.
- Google AI Pro (21,99 EUR monatlich): Argon, 3.1 Pro und 3.8 Flash in der Weboberfläche, 4-fach höhere Limits als im Basistarif, Antigravity mit Basiskontingenten (jedoch ohne Argon), 5 TB Speicherplatz sowie YouTube Premium Lite. Einsatzmöglichkeiten beschreibe ich unter Google AI Pro - Anwendungen.
- Google AI Ultra (99,99 EUR monatlich für 5-fache Pro-Limits bzw. 219,99 EUR monatlich für 20-fache Pro-Limits): Argon in der Weboberfläche und innerhalb von Antigravity, ab 20 TB Speicher, Project Genie und YouTube Premium.
Beachten Sie beim Start: Der Rollout von Argon in den Konsumenten-Apps erfolgt schrittweise. Auf meinem Pro-Konto war das Modell am Abend des 13.10. noch nicht freigeschaltet.
Wann sich welches Modell rechnet
- Einige Dutzend Abfragen pro Tag: 20 Anfragen täglich über 30 Tage hinweg ergeben bei geringer Komplexität (wie im Labortest gemessen) ca. 600 x 0,0048 = rund ca. 2,56 EUR (2,86 USD) monatlich zum Starttarif und rund ca. 5,12 EUR (5,72 USD) ab Dezember. Benötigen Sie ausschliesslich Argon, ist die API-Nutzung über OpenRouter deutlich preiswerter als das monatliche Pro-Abonnement.
- Tägliche Nutzung im Web sowie Integration in Gmail, Docs und Drive-Speicher: Hier ist Google AI Pro sinnvoll, da Sie für das gesamte Workspace-Paket zahlen. Die monatlichen Kosten sind fix, und die Limits im Interface aktualisieren sich alle fünf Stunden bis zum wöchentlichen Kontingent.
- Automatisierungen und Dokumentenverarbeitung: Hier führt kein Weg an der API vorbei - idealerweise über die Batch-Schnittstelle zu 1 / 5 USD (ca. 0,89 / 4,47 EUR), also der Hälfte des regulären Tarifs.
- Coding-Agenten mit Argon: Die Antigravity-Umgebung mit Argon erfordert zwingend das Ultra-Abonnement (ab 99,99 EUR). Die Alternative bildet die tokenbasierte API-Nutzung. Bei intensiver Denkstufe fallen hier jedoch Kosten an, die an die Messwerte des Artificial-Analysis-Index heranreichen (1,99 USD bzw. 3,98 USD pro anspruchsvoller Aufgabe).
Quellen
- Gemini API: Preisliste (geprüft am 13.10.2026)
- Google AI Pläne (geprüft am 12.10.2026)
- Google: Gemini 4 Argon - Built to solve your hardest problems (13.10.2026)
- OpenRouter: google/gemini-4-argon
- Artificial Analysis: Gemini 4 Argon - Google is back as one of the top three labs (30.09.2026)
- Eigene Tests vom 13.10.2026: Benchmark aus 23 Aufgaben, Dokumentenanalyse, Textgenerierung (13 Aufgaben auf Polnisch getestet), Abitur-Prüfungen - via OpenRouter, effort=low
- Europäische Zentralbank: Euro-Referenzkurse vom 12.10.2026 (1 EUR = 1,1181 USD)
 Das 20-fach kleinere Modell, das Giganten schlägt - Googles Gemma 4 und die Revolution der KI-EffizienzTechnologie
 TurboQuant: Wie ein 1-Bit-Trick Googles KI-Sprachmodelle sechsmal schlanker machtAlgorithmen
 Gemma 4: Wie Google mit schlanken KI-Modellen die Rechenzentren entlasten willTechnologie
More on this from WISSNOX

 nachrichten·Liquid AI LFM2.5-24B-A2B: Schnelles lokales AgentenmodellLiquid AI veröffentlicht LFM2.5-24B-A2B: 24 Milliarden Parameter, 2B aktiv. Ein schnelles lokales KI-Agentenmodell für Edge-Geräte und Datenschutz.