Gemma 4: Wie Google mit schlanken KI-Modellen die Rechenzentren entlasten will
Googles neue Open-Source-Modelle erreichen Spitzenleistungen mit einem Bruchteil der Parameter. Statt auf schiere Größe setzt die Gemma-4-Familie auf Effizienz - und läuft direkt auf dem Smartphone.
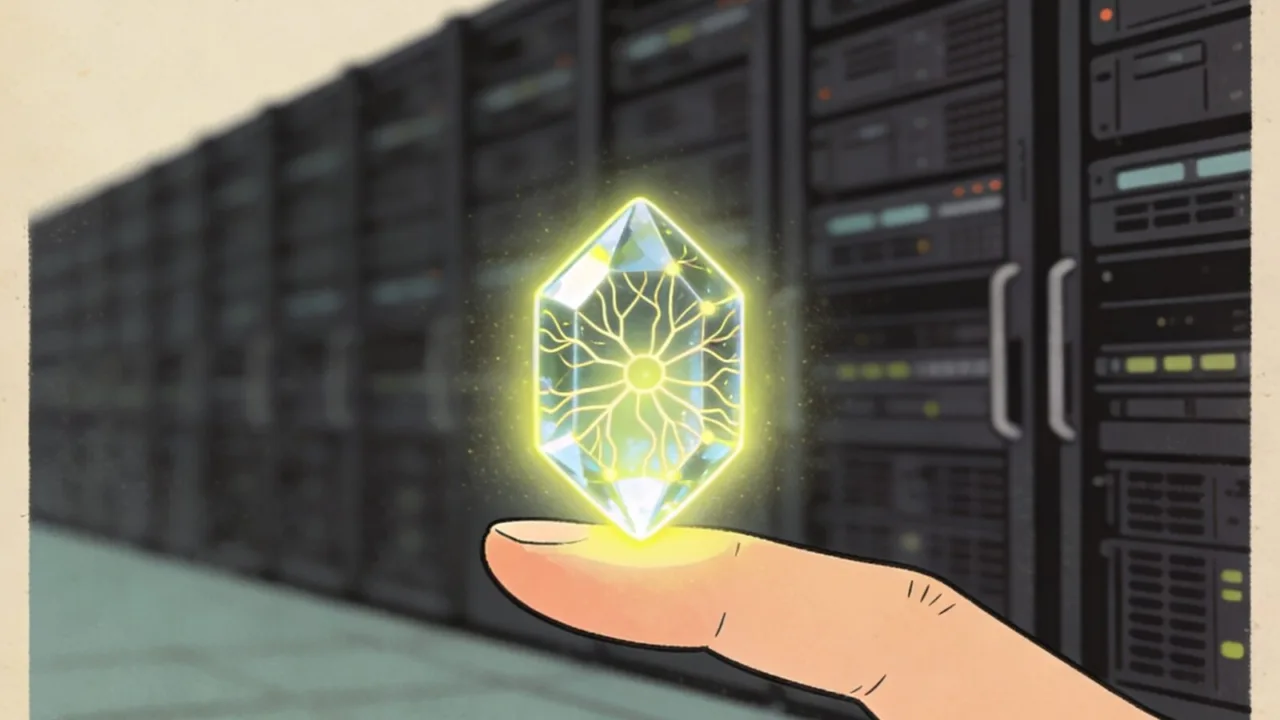
Es klingt wie ein Widerspruch in einer Zeit, in der KI-Modelle zu immer gewaltigeren Rechenmonstern anschwellen: Ein Modell, das nur 3,8 Milliarden seiner Parameter aktiviert, soll es mit Kolossen aufnehmen, die zwanzigmal so groß sind. Genau das behauptet Google DeepMind von seiner neuen Modellfamilie Gemma 4. Die Botschaft ist so einfach wie provokant: Intelligenz misst sich nicht in schierer Masse, sondern in dem, was man pro Byte herausholt.
Seit Jahren folgt die Entwicklung großer Sprachmodelle einem unausgesprochenen Gesetz: Mehr Parameter, mehr Rechenleistung, mehr Stromverbrauch. Doch dieser Kurs stößt an Grenzen - physikalische, ökonomische und ökologische. Googles Antwort darauf ist eine Familie offener Modelle, die das Versprechen der Effizienz radikal ernst nimmt. „Byte for byte, the most capable open models“ nennt das Unternehmen sie selbstbewusst. Was steckt dahinter?
Intelligenz pro Parameter: Das Ende des Größenwahns
Gemma 4 erscheint in vier Varianten, die unterschiedliche Hardware-Realitäten bedienen: zwei kompakte Modelle mit effektiv 2 und 4 Milliarden Parametern für mobile Geräte sowie zwei größere Versionen mit 26 Milliarden (als Mixture of Experts) und 31 Milliarden Parametern für Workstations und Server. Entscheidend ist nicht die absolute Größe, sondern die Leistungsdichte. Das 31-Milliarden-Modell rangiert auf dem Arena-AI-Text-Leaderboard auf Platz drei aller offenen Modelle - und schlägt dort Konkurrenten mit der zwanzigfachen Parameterzahl.
Möglich wird dies durch eine Architektur, die aus der Forschung an Googles Flaggschiff Gemini 3 stammt. „Built from the same world-class research and technology as Gemini 3“, schreiben die Entwickler. Die Kunst liegt in der Verdichtung: Statt Wissen auf möglichst viele künstliche Neuronen zu verteilen, wird jedes einzelne Gewicht im Netzwerk maximal informativ gestaltet. Das 26-Milliarden-MoE-Modell aktiviert während der Inferenz nur 3,8 Milliarden Parameter - was nicht nur Strom spart, sondern vor allem Latenzzeiten drastisch verkürzt.
Vom Rechenzentrum in die Hosentasche
Die vielleicht bemerkenswerteste Eigenschaft der Gemma-4-Familie ist ihre Hardware-Flexibilität. Die großen Modelle laufen quantisiert auf Consumer-GPUs, also auf handelsüblichen Gaming-Grafikkarten. Die kleinen E2B- und E4B-Varianten wurden in enger Zusammenarbeit mit dem Google-Pixel-Team sowie Chipherstellern wie Qualcomm und MediaTek entwickelt. Sie arbeiten komplett offline auf Smartphones, Raspberry Pis oder Nvidia Jetson Orin Nano - mit nahezu keiner Latenz.
Für Entwickler bedeutet das einen fundamentalen Wandel: Wer einen KI-Code-Assistenten oder einen Agenten bauen will, der sensible Daten verarbeitet, muss diese nicht mehr zwingend in die Cloud schicken. Ein lokales Modell, das auf dem eigenen Laptop oder gar dem Telefon des Nutzers läuft, verspricht digitale Souveränität. Die Modelle unterstützen Funktionsaufrufe, strukturierte JSON-Ausgaben und native Systemanweisungen - alles Bausteine für autonome Agenten, die mit APIs und Werkzeugen interagieren.
Mehr als Text: Multimodale Fähigkeiten und 140 Sprachen
Gemma 4 ist kein reines Textmodell. Alle Varianten verarbeiten nativ Video und Bilder, beherrschen optische Zeichenerkennung und Diagrammverständnis. Die Edge-Modelle verfügen zusätzlich über Audioeingabe für Spracherkennung. Mit Kontextfenstern von 128.000 Token bei den kleinen und 256.000 Token bei den großen Modellen lassen sich ganze Code-Repositories oder lange Dokumente in einem Durchgang verarbeiten.
Hinzu kommt eine beachtliche sprachliche Bandbreite: Die Modelle wurden auf über 140 Sprachen trainiert. Das ist kein Marketing-Gimmick, sondern eine strategische Entscheidung. Während viele KI-Systeme im Globalen Süden an sprachlichen Hürden scheitern, sollen Entwickler weltweit Anwendungen bauen können, die ihre lokalen Sprachen verstehen. Die bulgarische Forschungseinrichtung INSAIT etwa nutzte die Vorgängergeneration, um BgGPT zu entwickeln - das erste bulgarische Sprachmodell auf Spitzenniveau.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Offenheit als Strategie
Anders als viele Konkurrenten setzt Google bei Gemma auf eine kommerziell freizügige Apache-2.0-Lizenz. Entwickler dürfen die Modelle frei nutzen, verändern und in Produkte integrieren - ohne Copyleft-Verpflichtungen. „Building the future of AI requires a collaborative approach, and we believe in empowering the developer ecosystem without restrictive barriers“, begründet das Unternehmen diesen Schritt.
Die Resonanz gibt ihnen recht: Seit dem Start der ersten Gemma-Generation wurden die Modelle über 400 Millionen Mal heruntergeladen, die Community hat mehr als 100.000 Varianten und Anpassungen geschaffen. Mit Hugging Face, Ollama, vLLM und zahlreichen weiteren Tools steht ein breites Ökosystem bereit. Wer experimentieren will, kann die Modelle direkt in Google AI Studio testen oder die Gewichte von Hugging Face oder Kaggle herunterladen.
Die Sicherheitsarchitektur entspricht nach Angaben des Unternehmens denselben strengen Protokollen wie bei den proprietären Gemini-Modellen. Für Unternehmen und staatliche Organisationen, die sensible Daten nicht in fremde Clouds geben wollen, ist das ein gewichtiges Argument. Der Trend zur lokalen Inferenz könnte damit einen entscheidenden Schub erhalten.
Natürlich bleibt die Frage, wie weit die Effizienz-Revolution tatsächlich trägt. Benchmarks messen immer nur Ausschnitte von Intelligenz. Ob ein Modell mit 3,8 Milliarden aktiven Parametern in komplexen, mehrschrittigen Denkaufgaben wirklich mit einem 70-Milliarden-Modell mithalten kann, wird sich in der Praxis erweisen müssen. Doch die Richtung ist klar: Die Zukunft der KI liegt nicht nur in immer größeren Rechenzentren, sondern zunehmend auch in den Geräten, die wir täglich in der Hand halten.
Quellen:
- Gemini 3 Flash: frontier intelligence built for speed (DeepMind Blog)
- 3 things you need to know about quantum computers, from an expert (New Scientist)
- How NVIDIA engineers and researchers build with Codex (OpenAI Blog)
- Gemini Robotics-ER 1.6: Powering real-world robotics tasks through enhanced embodied reasoning (DeepMind Blog)
- Gemma 4: Byte for byte, the most capable open models (DeepMind Blog)
- Wolves Are Thriving at Michigan’s Isle Royale National Park, Reaching Their Highest Numbers in Almost 50 Years, New Data Suggests (Smithsonian - Smart News)
More on this from WISSNOX

 archäologie·Als die Kartoffel das Erbgut der Andenbewohner umschriebDie Domestizierung der Kartoffel vor Tausenden von Jahren war mehr als ein landwirtschaftlicher Meilenstein.