Open WebUI und Ollama unter Windows: ChatGPT lokal ohne Docker
Mit Open WebUI und Ollama lässt sich eine vollwertige ChatGPT-Alternative komplett lokal auf dem eigenen Rechner betreiben. Ich habe Version 0.12 ohne Docker unter Windows eingerichtet und Leistungswerte für Text und Dokumente ermittelt.
👁 117 Aufrufe
Open WebUI bietet eine Weboberfläche im Stil bekannter Cloud-Dienste, verarbeitet Anfragen über Open WebUI Ollama jedoch vollständig auf dem eigenen Rechner als echtes ChatGPT lokal. Wer eine datenschutzfreundliche Alternative für ChatGPT offline sucht, erhält damit Chat-Verläufe, Modellwechsel und Dokumentenverarbeitung direkt im Browser. Weitere Grundlagen zur Ausführung finden Sie in meiner Übersicht zu lokalen KI-Modellen für Text, Bilder und Video.
Stand: 17. Oktober 2026
- Neueste Version: Open WebUI 0.12.3 vom 16. Oktober 2026 (Zweig 0.12 erschien am 10. Oktober 2026).
- Erfordert Python 3.11 oder 3.12; Python 3.13 wird nicht unterstützt. Die Einrichtung erfolgt über
uv. - Lizenz: Open WebUI License (BSD-3-Klauseln ergänzt um Markenschutz bezüglich Name und Logo). Kostenlose Nutzung auch in Unternehmen erlaubt.
- Speicherbedarf: 1,8 GB auf dem Datenträger (ohne Sprachmodelle), der Server belegte bei mir etwa 800 MB RAM.
Was Open WebUI bietet
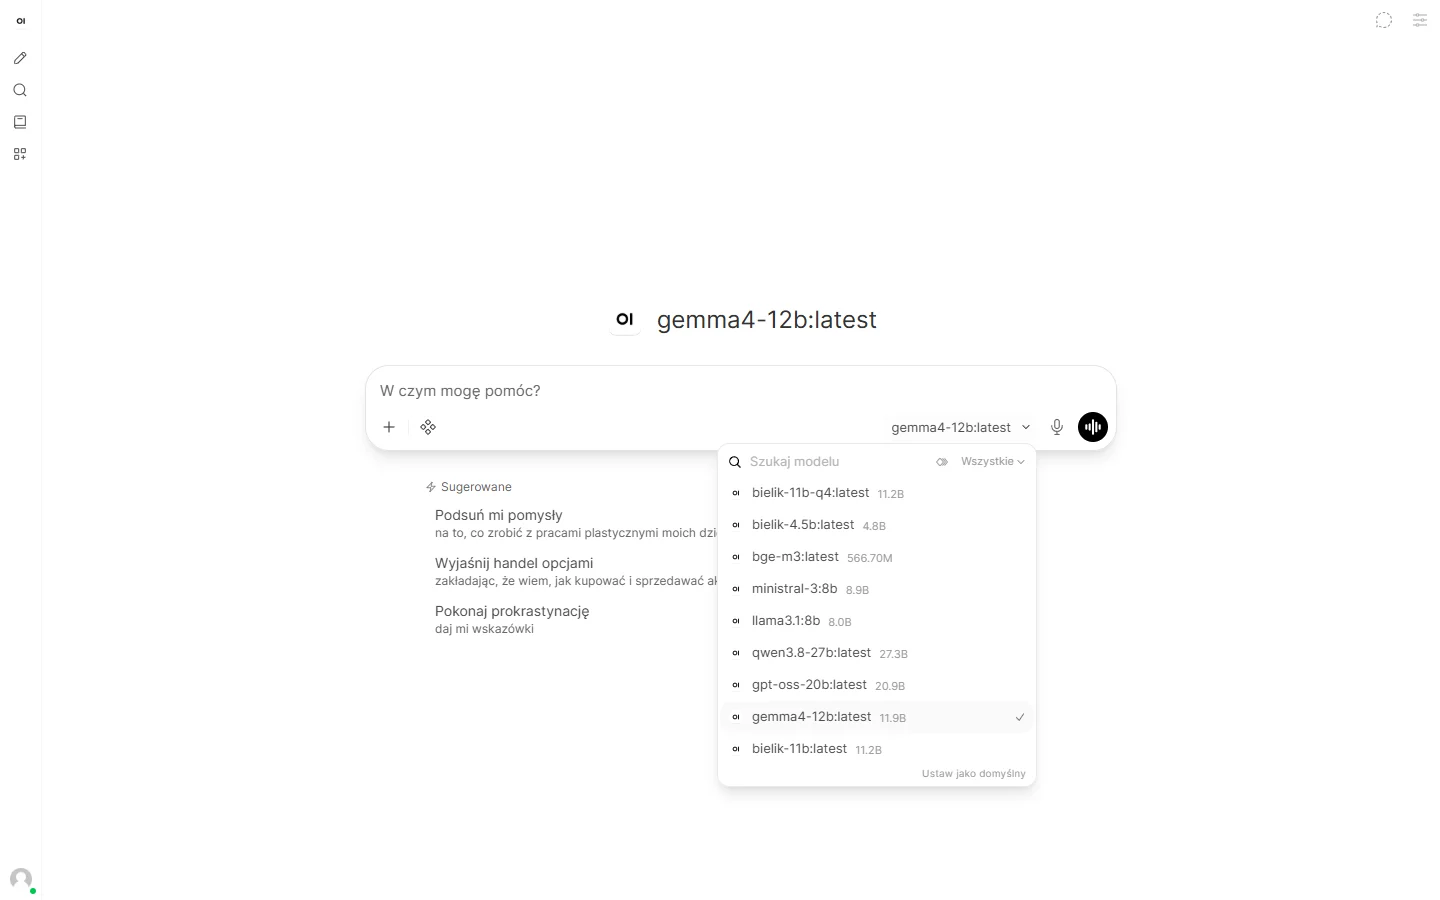
Open WebUI fungiert als lokaler Webserver. Sie starten das Programm auf Ihrem System und greifen im Browser über http://localhost:8080 darauf zu. Die Inferenz erfolgt nicht im Webinterface selbst: Anfragen werden an Ollama oder an jede kompatible OpenAI-Schnittstelle weitergeleitet. Gegenüber dem reinen Terminalbetrieb von Ollama stehen Ihnen erweiterte Funktionen zur Verfügung:
- Verlauf aller Unterhaltungen, Ordnerstrukturen, Volltextsuche und Exportfunktionen.
- Auswahl installierter Modelle und direkter Vergleich zweier Modelle mit demselben Prompt.
- Upload von Dateien für Retrieval-Augmented Generation (RAG) und Wissensdatenbanken.
- Benutzerverwaltung mit differenzierten Zugriffsrechten für Arbeitsgruppen im Netzwerk.
- Automatische Lokalisierung der Benutzeroberfläche anhand der Browsersprache.
Installation unter Windows ohne Docker
- Ollama einrichten und Modell laden: Für meinen Benchmark nutze ich Gemma 4 12B (Q4_0 QAT, 7,0 GB Dateigröße). Leistungsdaten größerer Varianten finden Sie im Test zu Gemma 4 31B lokal auf der RTX 4090.
- uv installieren: Der Paketmanager von Astral übernimmt das Bereitstellen der passenden Python-Laufzeitumgebung:
winget install astral-sh.uv - Open WebUI isoliert installieren: Die Installation erfolgt mit Python 3.11 über folgendes Kommando:
uv tool install --python 3.11 open-webuiDie Erstinstallation am 3. Oktober dauerte auf meinem System 59 Sekunden. Das Update von Version 0.11.4 auf Version 0.12.3 beanspruchte 1 Minute und 55 Sekunden.
- Server für Einzelnutzer starten: Um Anmeldeschranken im lokalen Betrieb zu umgehen, nutzen Sie diese PowerShell-Befehle:
$env:WEBUI_AUTH = "False" $env:DATA_DIR = "$HOME\open-webui-dane" open-webui serve --host 127.0.0.1 --port 8080 - Befehlspfad aktualisieren: Falls PowerShell die Anwendung nicht erkennt, führen Sie einmalig
uv tool update-shellaus und starten Sie das Konsolenfenster neu. - Initialer Startvorgang: Bei einem leeren Datenverzeichnis dauerte der erste Start bei mir 81 Sekunden, jeder weitere Kaltstart benötigte 31 Sekunden.
- Oberfläche aufrufen: Öffnen Sie
http://localhost:8080. Bei laufendem Ollama-Dienst stehen alle geladenen Modelle direkt im Menü bereit.
Soll das System mehreren Anwendern dienen, entfällt der Parameter WEBUI_AUTH=False, woraufhin beim ersten Aufruf ein lokales Administratorkonto erstellt wird. Über den Parameter --host 0.0.0.0 wird die Weboberfläche im lokalen Firmen- oder Heimnetzwerk erreichbar.
Praxistest: Unterhaltung und Latenzen mit Gemma 4 12B
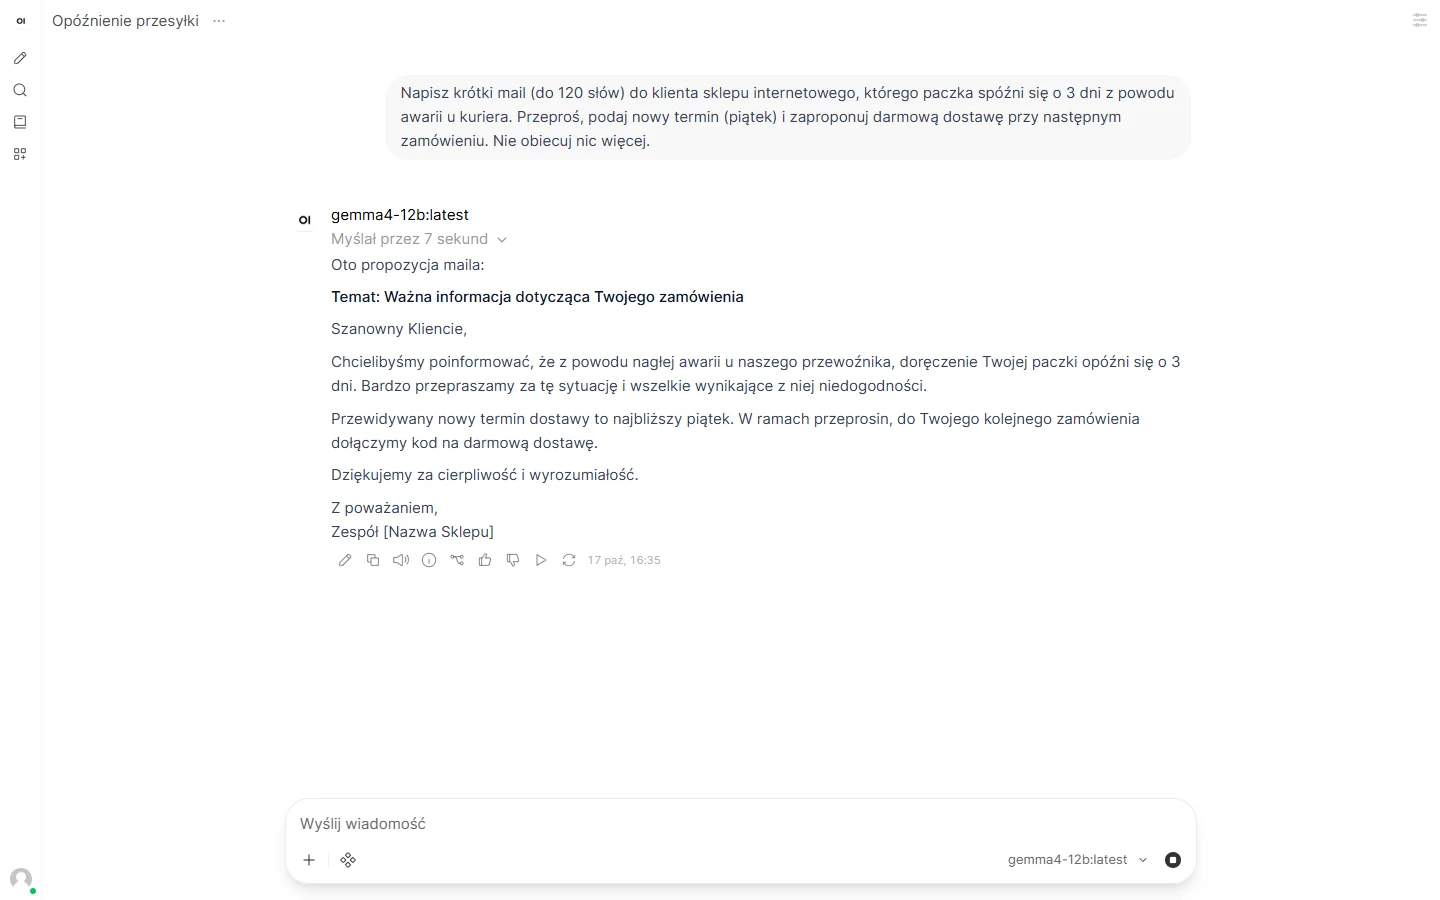
Ich habe das Gespann auf meinem System (RTX 4090 24 GB, i9-14900KF, 64 GB RAM, Windows 11) mit Ollama 0.40.5 gemessen. Als Testaufgabe diente eine geschäftliche E-Mail bezüglich einer Lieferverzögerung inklusive Entschuldigung, Liefertermin am Freitag und Gutschein für kostenfreien Versand. Gemma 4 benötigte 7 Sekunden Bedenkzeit und lieferte alle geforderten Punkte präzise ab.
| Messwert (17.10.2026) | Open WebUI | Reines Ollama |
|---|---|---|
| Zeit bis zur ersten Antwort (Kaltstart) | 36,8 s | - |
| davon Modell-Ladezeit von USB-Laufwerk | 19,9 s | - |
| Zeit für Folgeantworten | 17,4 s | 12,4 s |
| Ausgabegeschwindigkeit | 80-85 tok/s | 91,3 tok/s |
| Prompt-Token | 5694 | 95 |
| VRAM-Spitzenbelegung | 9,7 GB | - |
Vor Testbeginn waren 1,4 GB VRAM durch das Betriebssystem belegt, womit das Modell samt Dialogkontext rund 8,4 GB Speicher beanspruchte. Die Diskrepanz bei den Prompt-Token ist gravierend: Im reinen Konsolenbetrieb wies mein Prompt 95 Token auf, in Open WebUI 0.12 stieg dieser Wert auf 5694 Token an. Version 0.12 injiziert Systemprompts für integrierte Werkzeuge wie Speicher, Notizen und Suchfunktionen. Auf einer Karte mit 24 GB VRAM führt dies lediglich zu einer leichten Verzögerung und etwa 10 % geringerer Generierungsrate. Bei Grafikkarten mit 8 GB VRAM kann ein derart vergrößerter Kontext jedoch zur Überlastung des Grafikspeichers führen. Bei Bedarf lassen sich diese Werkzeuge in den Modelleinstellungen abschalten.
Dokumentenanalyse: RAG-Test mit PDF-Dateien
Open WebUI teilt hochgeladene Dateien in Abschnitte, generiert Vektoreinbettungen und fügt relevante Textstellen der Benutzeranfrage hinzu. Standardmäßig verwendet das System das Modell all-MiniLM-L6-v2. Für Dokumente außerhalb des rein englischsprachigen Raums empfiehlt sich der Wechsel auf ein mehrsprachiges Modell wie bge-m3:
- Modell in Ollama herunterladen:
ollama pull bge-m3(Dateigröße 1,2 GB). - Profilmenü unten links aufrufen, Bereich Administrator wählen, zu Dokumente navigieren. Bei der Embedding-Engine Ollama einstellen und als Modellnamen
bge-m3:latestspeichern. - Bereits importierte Dokumente neu indizieren lassen, damit die Vektoren mit dem neuen Modell berechnet werden.
Für den Test habe ich ein Dokument zum Verbraucherrecht (PDF mit 607 KB) hochgeladen. Der Indizierungsvorgang dauerte 6,6 Sekunden. Anschließend habe ich zehn spezifische Fachfragen gestellt, die ich bereits am 3. Oktober in einem separaten RAG-Skript analysiert hatte:
- Open WebUI 0.12.3 (Standard-RAG mit bge-m3 und Gemma 4 12B): 8 von 10 korrekten Antworten. Nicht gefunden wurden die Frist zur Warenrücksendung sowie eine Bagatellgrenze von 50 Euro. Das System wies in beiden Fällen korrekt darauf hin, dass diese Angaben im Textauszug nicht auffindbar waren.
- RAG-Testskript vom 3. Oktober (strukturiertes Chunking nach Gesetzesartikeln, identisches Modell): 9 von 10 Punkten.
- Gemma 4 ohne Dokumentenbezug (Messung vom 3. Oktober): 5 von 10 Punkten.
- Laufzeiten und Speicher: Die Antwortzeiten lagen zwischen 12 und 39 Sekunden (Erstaufruf 76 Sekunden inklusive Modellstart). Spitzenbelegung VRAM: 10,8 GB mit Gemma 4 und bge-m3 parallel im Speicher.
Startskript für Windows PowerShell
Das folgende Skript prüft das Vorhandensein von Ollama, richtet uv sowie Open WebUI bei Bedarf ein und startet den Server mit vorkonfiguriertem RAG-Modell:
# open-webui-start.ps1 - Startet Open WebUI mit Ollama unter Windows
param(
    [string]$Folder = "$HOME\open-webui-dane",
    [int]$Port = 8080,
    [switch]$BezPrzegladarki
)
$ErrorActionPreference = 'Stop'

function Test-Url($u) {
    try { Invoke-RestMethod -Uri $u -TimeoutSec 3 | Out-Null; return $true } catch { return $false }
}

if (-not (Get-Command ollama -ErrorAction SilentlyContinue)) {
    Write-Host 'Ollama nicht gefunden. Installation via: winget install Ollama.Ollama' -ForegroundColor Red
    exit 1
}
if (-not (Test-Url 'http://127.0.0.1:11434/api/version')) {
    Write-Host 'Ollama laeuft nicht. Bitte den Dienst starten.' -ForegroundColor Red
    exit 1
}

if (-not (Get-Command uv -ErrorAction SilentlyContinue)) {
    Write-Host 'Installiere uv...'
    winget install --id astral-sh.uv -e
    $env:Path = [Environment]::GetEnvironmentVariable('Path', 'User') + ';' + [Environment]::GetEnvironmentVariable('Path', 'Machine')
}

$exe = Join-Path $HOME '.local\bin\open-webui.exe'
if (-not (Test-Path $exe)) {
    Write-Host 'Installiere Open WebUI via uv tool...'
    uv tool install --python 3.11 open-webui
}

$modele = @((Invoke-RestMethod -Uri 'http://127.0.0.1:11434/api/tags').models | ForEach-Object { $_.name })
if ($modele -notcontains 'bge-m3:latest') {
    Write-Host 'Lade bge-m3 fuer Dokumenten-Embeddings...'
    ollama pull bge-m3
}

New-Item -ItemType Directory -Force -Path $Folder | Out-Null
$env:DATA_DIR = $Folder
$env:WEBUI_AUTH = 'False'
$env:OLLAMA_BASE_URL = 'http://127.0.0.1:11434'
$env:ENABLE_OPENAI_API = 'False'
$env:RAG_EMBEDDING_ENGINE = 'ollama'
$env:RAG_EMBEDDING_MODEL = 'bge-m3:latest'
$env:ANONYMIZED_TELEMETRY = 'false'
$env:DO_NOT_TRACK = 'true'
$env:SCARF_NO_ANALYTICS = 'true'
$env:PYTHONIOENCODING = 'utf-8'

Write-Host "Starte Open WebUI auf Port $Port..."
$p = Start-Process -FilePath $exe -ArgumentList @('serve', '--host', '127.0.0.1', '--port', "$Port") -NoNewWindow -PassThru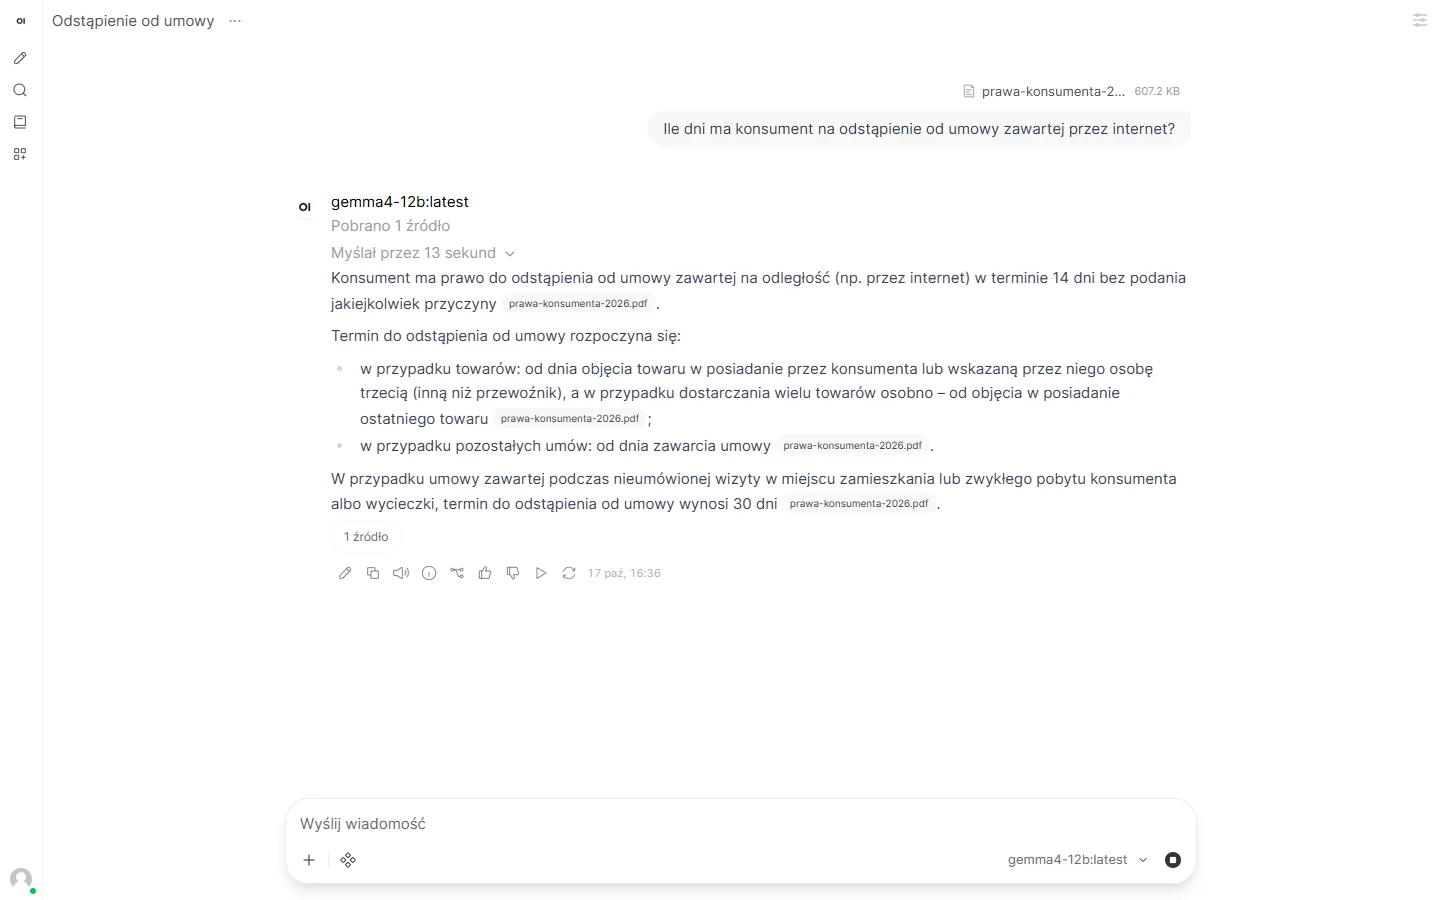
Open WebUI im Vergleich: LM Studio und Jan
| Eigenschaft | Open WebUI | LM Studio | Jan |
|---|---|---|---|
| Form | Webbrowser-Interface | Desktop-Anwendung | Desktop-Anwendung |
| Backend-Engine | Ollama oder API | Eigene Engine | llama.cpp |
| Multi-User & Netzwerk | Ja | Nein | Nein |
| Lizenz | Open WebUI License | Freeware, Closed Source | Apache 2.0 |
Open WebUI eignet sich hervorragend, wenn Sie Dokumente tief integrieren, im Browser arbeiten oder die Rechenleistung Ihrer Grafikkarte im Heimnetzwerk freigeben wollen. Wer eine grafische Oberfläche mit integriertem Modelldownloader bevorzugt, greift zu LM Studio. Eine vollständig quelloffene Desktop-Lösung ohne Terminaleinsatz liefert Jan. Einen wirtschaftlichen Vergleich zu Cloud-Diensten finden Sie im Beitrag lokales KI-Modell oder API-Kosten.
Typische Fehler und Problemlösungen
- Fehlermeldung „Python 3.13 is not supported“: Open WebUI startet nicht unter Python 3.13. Führen Sie die Installation gezielt mit
uv tool install --python 3.11 open-webuiaus. - Keine Modelle in der Auswahlliste: Stellen Sie sicher, dass Ollama im Hintergrund läuft und unter
http://127.0.0.1:11434erreichbar ist. Kontrollieren Sie den Befehlollama list. - Port 8080 belegt: Starten Sie den Dienst auf einem alternativen Port mit dem Zusatzparameter
--port 8081. - Langsamere Generierung als im Terminal: Dies wird durch Hintergrundroutinen wie automatische Titelgenerierung und Tagging verursacht. Diese Funktionen können in den Administrationseinstellungen deaktiviert werden.
Häufige Fragen (FAQ)
Ist Open WebUI für den geschäftlichen Einsatz kostenlos?
Ja, Open WebUI kann auch in Unternehmen gebührenfrei genutzt werden. Eine Lizenzgebühr fällt lediglich an, wenn Sie das offizielle Logo und den Namen bei mehr als 50 aktiven Benutzern entfernen oder durch eigenes Branding ersetzen möchten.
Lässt sich Open WebUI komplett ohne Internetverbindung betreiben?
Ja, das System arbeitet nach der Installation vollständig autark auf dem Rechner. Sämtliche Prompts und Antworten verbleiben lokal. Über den Umgebungsparameter OFFLINE_MODE=True lassen sich zudem Versionsprüfungen und Modellabrufe vollständig unterbinden.
Wie wird Open WebUI mit Ollama verbunden?
Läuft Ollama auf demselben Computer, erkennt Open WebUI die Standardschnittstelle unter http://127.0.0.1:11434 automatisch. Bei getrennten Systemen hinterlegen Sie die Netzwerkadresse in der Variable OLLAMA_BASE_URL oder direkt in den Verbindungseinstellungen.
Wird zwingend Docker für die Installation benötigt?
Nein, Docker ist unter Windows nicht zwingend erforderlich. Über den Python-Paketmanager uv lässt sich die Serveranwendung als isoliertes Werkzeug in wenigen Minuten direkt im Betriebssystem installieren.
Können externe Schnittstellen wie ChatGPT angebunden werden?
Ja, in den Einstellungen können externe API-Endpunkte zusammen mit dem entsprechenden API-Schlüssel hinterlegt werden. In diesem Szenario verlassen die Anfragen das lokale System und werden nach den Preisen des jeweiligen Cloud-Anbieters abgerechnet.
Wie gelingt die Aktualisierung auf neuere Versionen?
Das Update erfolgt über den Terminalbefehl uv tool upgrade open-webui. Alle Gesprächsdaten, Einstellungen und Benutzerkonten bleiben im festgelegten Verzeichnis DATA_DIR unverändert erhalten.
Quellen
- Open WebUI GitHub Releases (Versionen 0.12.0 und 0.12.3)
- Open WebUI License und Nutzungsbedingungen
- Offizielle Open WebUI Dokumentation: Quick Start
- open-webui Paketübersicht auf PyPI
- Eigene Benchmark-Messungen auf RTX 4090 unter Windows 11 mit Ollama 0.40.5 vom 17. Oktober 2026.
Überprüft am 17. Oktober 2026.
More on this from WISSNOX