Wald oder Baum: Wie viele menschliche Prüfer braucht ein reproduzierbarer KI-Benchmark?
KI-Benchmarks mit nur drei bis fünf Bewertern sind oft nicht reproduzierbar. Eine Google-Studie zeigt, wie viele Prüfer wirklich nötig sind - und warum die Antwort überrascht.
Stellen Sie sich vor, Sie wollen zwei KI-Modelle vergleichen, die hasserfüllte Kommentare erkennen sollen. Sie lassen 1000 Social-Media-Beiträge von jeweils drei Personen bewerten und küren das Modell zum Sieger, das am häufigsten mit der Mehrheitsmeinung übereinstimmt. Ein zweites Forschungsteam wiederholt Ihr Experiment mit derselben Methode, aber anderen Bewertern - und kommt zum gegenteiligen Schluss. Was ist schiefgelaufen? Die Antwort liegt in einer fundamentalen, aber lange unterschätzten Frage: Wie viele menschliche Prüfer braucht ein KI-Benchmark wirklich, um reproduzierbar zu sein?
Das Problem: Menschliche Uneinigkeit und die Illusion der einen Wahrheit
In der maschinellen Lernforschung gilt Reproduzierbarkeit als zentrales Qualitätsmerkmal: Gleicher Code, gleiche Daten, gleiche Einstellungen sollen zu gleichen Ergebnissen führen. Doch sobald Menschen ins Spiel kommen, wird dieses Ideal brüchig. Anders als Maschinen nähern sich Menschen jedem Problem aus unterschiedlichen Perspektiven und sind sich oft uneins. Trotzdem ignorieren die meisten KI-Benchmarks diese natürliche Streuung und tun so, als gäbe es für jedes Beispiel ein einziges „richtiges“ Label - die sogenannte Ground Truth. Flip Korn und Chris Welty, Research Scientists bei Google Research, bezeichnen dieses Vorgehen als „Single-Truth“-Paradigma und zeigen in ihrer Arbeit, wie sehr es die Verlässlichkeit von Evaluierungen untergräbt.
Das Problem ist nicht neu, aber erstaunlich wenig erforscht. Ein Grund: Budgets für menschliche Annotationen sind begrenzt, und jede zusätzliche Bewertung pro Item treibt die Kosten in die Höhe. Also begnügt man sich in der Praxis fast immer mit ein bis fünf Bewertern - in der Hoffnung, dass deren Mehrheitsvotum die Wahrheit ausreichend abbildet. Doch genau diese Sparsamkeit könnte der Grund sein, warum viele aufwendige Modellvergleiche bei Wiederholung scheitern.
Wald oder Baum - die (N,K)-Abwägung
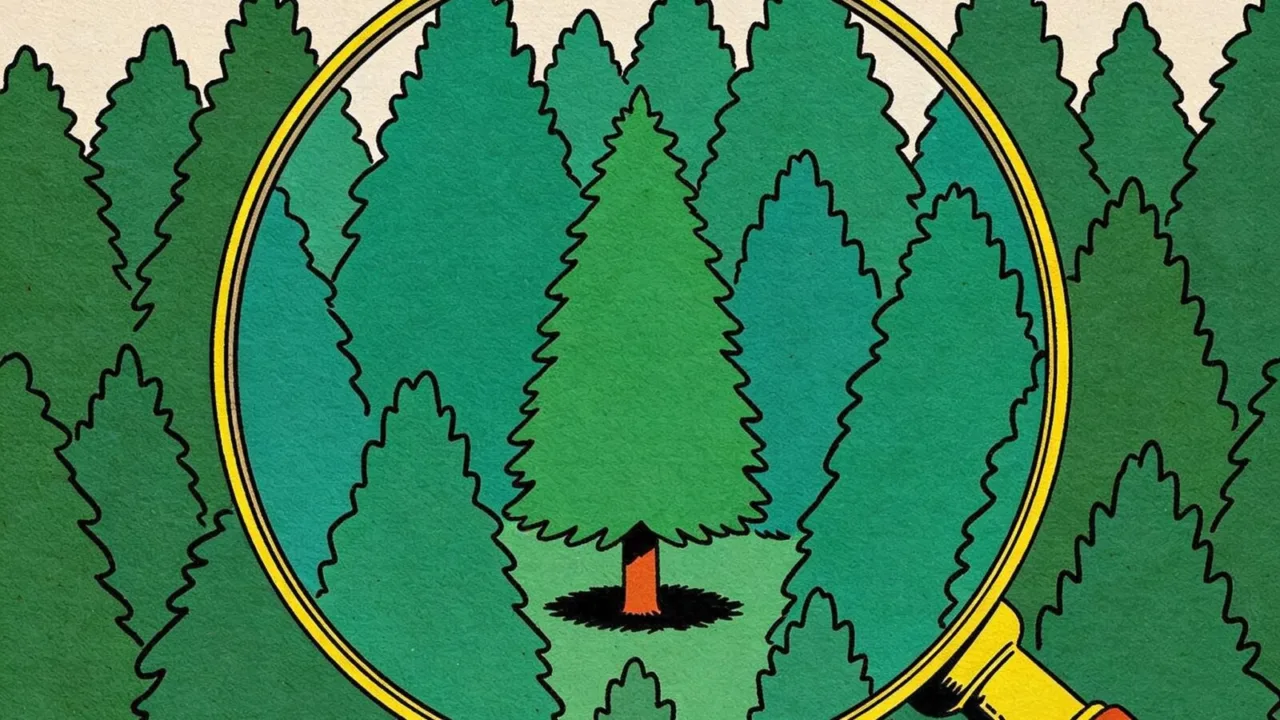
Um dem Phänomen auf den Grund zu gehen, haben Korn, Welty und ihre Koautoren Deepak Pandita und Christopher Homan (RIT) eine grundsätzliche Frage gestellt: Ist es besser, viele Items von wenigen Personen bewerten zu lassen oder wenige Items von vielen? Sie nennen das die (N,K)-Abwägung, wobei N für die Anzahl der bewerteten Items und K für die Anzahl der Bewerter pro Item steht. Die beiden Extreme veranschaulichen sie mit einer eingängigen Metapher: den Wald und den Baum. Der Wald-Ansatz (viele Items, wenige Bewerter) gleicht dem Versuch, die Qualität eines Restaurants zu beurteilen, indem 1000 verschiedene Gäste jeweils ein einziges Gericht probieren. Der Baum-Ansatz (wenige Items, viele Bewerter) hingegen lässt 20 Personen dieselben 50 Gerichte kosten und erfasst so die Nuancen der einzelnen Speisen.
Historisch hat die KI-Evaluierung fast immer auf den Wald gesetzt. Die neue Studie, veröffentlicht unter dem Titel „Forest vs Tree: The (N,K) Trade-off in Reproducible ML Evaluation“ auf dem Google Research Blog, stellt diese Gewohnheit auf den Prüfstand - mit einem eigens entwickelten Simulator, der Tausende von (N,K)-Kombinationen einem massiven Stresstest unterzieht.
Der Simulator und die getesteten Datensätze
Das Team fütterte seinen Simulator mit vier realen Datensätzen, die allesamt subjektive Aufgaben wie Toxizitäts- oder Hassrede-Erkennung abbilden. Der Toxicity-Datensatz umfasst 107.620 Social-Media-Kommentare, bewertet von 17.280 Personen. DICES (Diversity in Conversational AI Evaluation for Safety) enthält 350 Chatbot-Gespräche, die von 123 Bewertern entlang 16 verschiedener Sicherheitsdimensionen eingestuft wurden. D3code ist ein großer interkultureller Datensatz mit 4.554 Items, die von 4.309 Personen aus 21 Ländern auf Anstößigkeit beurteilt wurden - ausbalanciert nach Geschlecht und Alter. Der Jobs-Datensatz schließlich besteht aus 2.000 Tweets mit je fünf Bewertern, die drei Fragen zu berufsbezogenen Informationen beantworteten.
Mit diesen Daten simulierte das Team, wie sich verschiedene Verteilungen des Annotationsbudgets auf die statistische Verlässlichkeit auswirken. Dabei variierten sie N von 100 bis 50.000 und K von 1 bis 500. Als Maß für Reproduzierbarkeit diente die Fähigkeit, mit einer Signifikanz von p < 0,05 zuverlässig zwischen zwei KI-Modellen A und B unterscheiden zu können. Zusätzlich testeten sie, wie sich stark unausgewogene Daten (etwa 99 % Spam, 1 % wichtige Mails) und eine größere Zahl von Antwortkategorien auf das optimale Verhältnis auswirken. Der gesamte Simulator steht als Open Source auf GitHub zur Verfügung.
Drei überraschende Erkenntnisse
1. Der „Standard“ von 3 - 5 Bewertern genügt nicht
Die vielleicht wichtigste Botschaft der Studie: Die branchenübliche Praxis, ein bis fünf Bewerter pro Item einzusetzen, ist in den meisten Fällen unzureichend. Dieser „Low-Rater“-Ansatz liefert weder genug Breite für das große Ganze noch genug Tiefe für die Nuancen menschlicher Meinungen. Um wirklich verlässliche Ergebnisse zu erzielen, die die menschliche Vielfalt abbilden, brauchen Praktiker oft mehr als zehn Bewerter pro Item. Erst dann nähert sich der p-Wert der Null, und die Nullhypothese - dass beide Modelle gleich gut sind - kann sicher verworfen werden.
2. Die Metrik diktiert die Strategie
Ein universell optimales (N,K)-Verhältnis gibt es nicht. Stattdessen hängt die ideale Balance entscheidend davon ab, was gemessen werden soll. Geht es um reine Genauigkeit, also um die Übereinstimmung mit dem Mehrheitsvotum, ist der Wald-Ansatz überlegen: Mehr Items bringen mehr als mehr Bewerter. Soll hingegen das gesamte Meinungsspektrum erfasst werden - inklusive der feinen Unterschiede zwischen „vielleicht“ und „ja“ - , führt nur der Baum-Ansatz zum Ziel. Die Zahl der Bewerter zu erhöhen, ist der einzige Weg, die „totale Variation“ menschlichen Denkens einzufangen.
3. Effizienz ist in Reichweite
Die erfreulichste Nachricht für Forschungsteams mit knappen Budgets: Man braucht keine unendlichen Mittel. Die Simulationen zeigen, dass sich bereits mit rund 1.000 Gesamtannotationen hoch reproduzierbare Ergebnisse erzielen lassen - vorausgesetzt, das Verhältnis von Items zu Bewertern wird bewusst auf die gewählte Metrik abgestimmt. Wer dagegen die falsche Balance wählt, riskiert selbst bei deutlich höherem Budget unzuverlässige Schlussfolgerungen.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Warum das für die Zukunft der KI zählt
Die Arbeit von Korn, Welty und ihrem Team ist mehr als eine methodische Fingerübung. Sie rüttelt an einem jahrzehntealten Paradigma. Solange KI vor allem objektive Aufgaben löste - Bilder klassifizieren, Sprache erkennen - , mochte die Vorstellung einer einzigen richtigen Antwort ausreichen. Doch mit dem Vormarsch der Modelle in ethisch aufgeladene, subjektive Domänen - von der Erkennung schädlicher Absichten bis zur Bewertung sozialer Interaktionen - bricht dieses Paradigma zusammen. Wer verstehen will, warum Menschen uneins sind, muss dieser Uneinigkeit Raum geben, statt sie wegzumitteln.
Die Studie liefert dafür das mathematische Rüstzeug. Sie zeigt, dass ein bewusster Wechsel vom Wald zum Baum nicht nur die Reproduzierbarkeit erhöht, sondern auch das Vertrauen in KI-Systeme stärkt, die zunehmend über sensible gesellschaftliche Fragen mitentscheiden. Der Open-Source-Simulator und die detaillierten Analysen bieten eine praktische Roadmap, um diesen Wandel ohne Kostenexplosion zu vollziehen. Am Ende geht es um eine einfache, aber folgenreiche Einsicht: Die menschliche Perspektive ist kein Störfaktor, den man eliminieren muss, sondern der eigentliche Maßstab, an dem sich KI messen lassen sollte.
Quellen:
- Building better AI benchmarks: How many raters are enough? (Google Research Blog)
- How frontier firms are pulling ahead (OpenAI Blog)
- Our response to the TanStack npm supply chain attack (OpenAI Blog)
- OpenAI Campus Network: Student club interest form (OpenAI Blog)
- How ChatGPT adoption broadened in early 2026 (OpenAI Blog)
- Singular Bank helps bankers move fast with ChatGPT and Codex (OpenAI Blog)
More on this from WISSNOX

 klima·Kipppunkt im Atlantik: Warum die Angst vor dem Kollaps der Meeresströmung wächstDie atlantische Umwälzzirkulation AMOC gilt als zentrale Wärmepumpe Europas.