Decision Index: Artificial Analysis testet Decision-Modelle
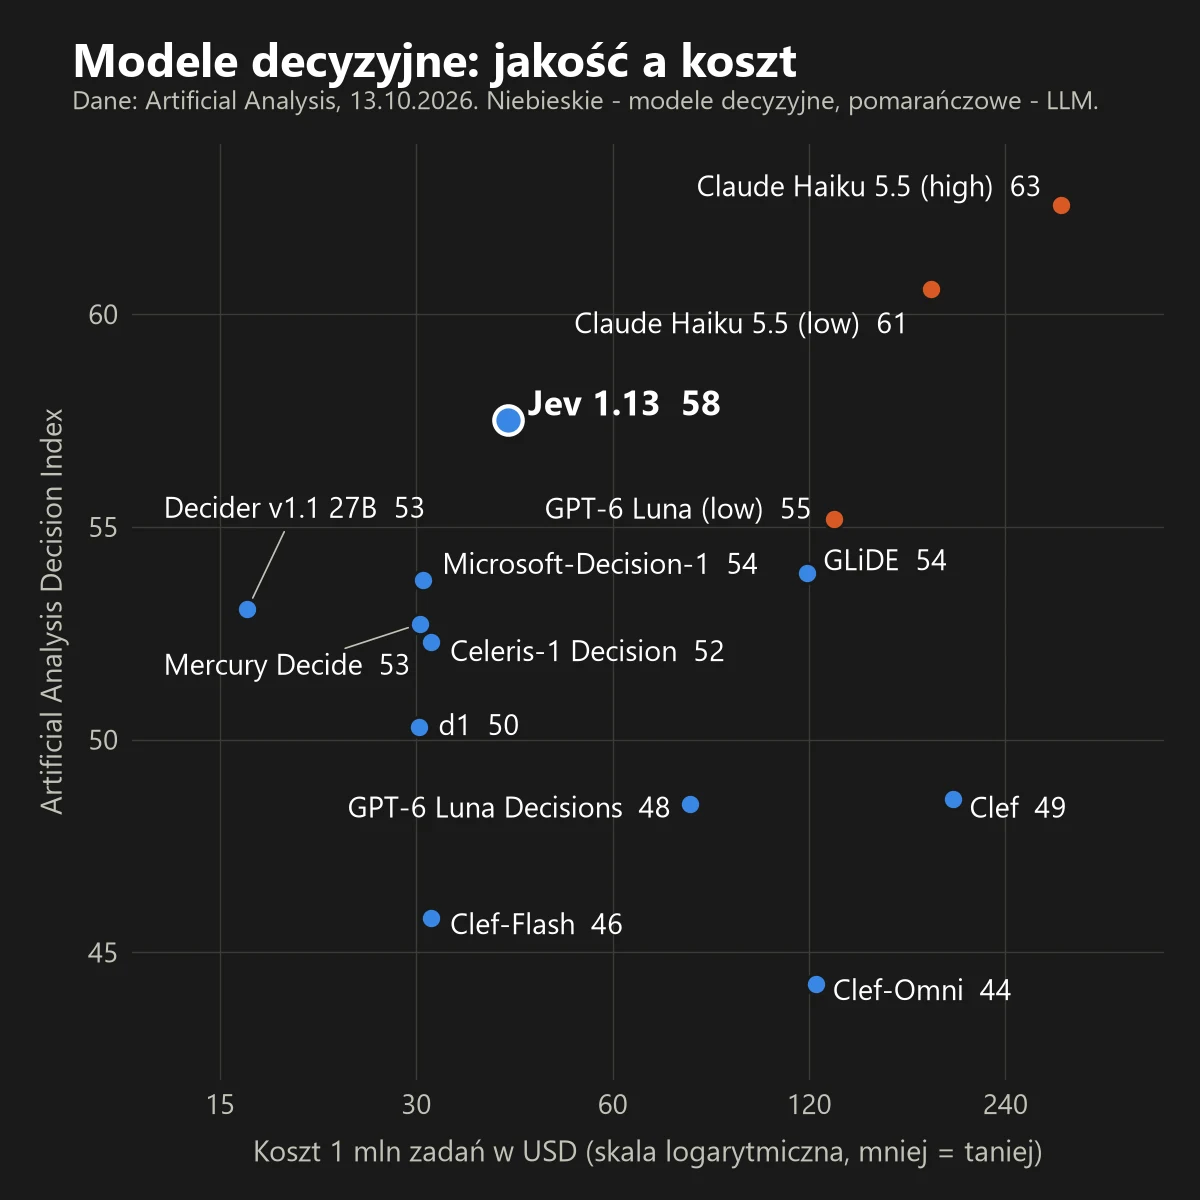
Der Decision Index v1.0 von Artificial Analysis vergleicht Entscheidungs-KI: Jev 1.13 führt mit 58 Punkten vor GLiDE und Microsoft-Decision-1. Preise ab ca. 15 EUR.
👁 120 Aufrufe
Am 13. Oktober 2026 hat Artificial Analysis den Decision Index v1.0 veröffentlicht: das erste unabhängige Ranking für Decision-Modelle. Dabei handelt es sich um KI-Modelle, die keinen Freitext generieren, sondern eine Option aus einer vorgegebenen Liste auswählen und Wahrscheinlichkeiten für jede Option liefern. An der Spitze liegt Jev 1.13 von TypeSafe mit 58 Punkten, vor GLiDE (Fastino) und Microsoft-Decision-1 (jeweils 54 Punkte). Am günstigsten schneidet Decider v1.1 27B von Perplexity ab: ca. 15,19 EUR (17 USD) pro Million Aufgaben (EZB-Referenzkurs vom 13.10.2026: 1 EUR = 1,1188 USD; Quelle: EZB; gerundete Richtwerte, keine lokalen Endpreise). Das reguläre Sprachmodell Claude Haiku 5.5 erzielt zwar einen höheren Wert (61), ist laut Messungen von Artificial Analysis jedoch 11-mal langsamer und 4,4-mal teurer als der Spitzenreiter.
Wichtigste Kennzahlen (Artificial Analysis, 13.10.2026)
- 11 Entscheidungsmodelle im Ranking, im Einführungsartikel werden 9 davon detailliert aufgeführt.
- Spitzenreiter: Jev 1.13 (TypeSafe) - 58 Punkte, ca. 37,54 EUR (42 USD) pro Million Aufgaben, 0,13 s pro Aufgabe.
- Kosten pro Million Aufgaben: von ca. 15,19 EUR (17 USD; Decider v1.1 27B) bis ca. 177,87 EUR (199 USD; Cloudflare Clef).
- Latenz pro Aufgabe: von 0,06 s (Celeris-1 Decision) bis 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low): 61 Punkte, ca. 164,46 EUR (184 USD) pro Million Aufgaben, 1,4 s pro Aufgabe.
Transparenzhinweis: Das Modell Jev kenne ich aus früheren Tests - im September habe ich dafür einen einfachen API-Client für eigene redaktionelle Werkzeuge geschrieben. TypeSafe hat diesen Beitrag weder beauftragt noch bezahlt. Die Platzierung von Jev basiert ausschließlich auf den unabhängigen Messdaten von Artificial Analysis.
Was ist ein Entscheidungsmodell?
Ein Entscheidungsmodell erhält zwei Eingaben: einen Zustand (zum Beispiel den Text einer Kundennachricht) und eine Liste von Fragen mit geschlossenen Antwortoptionen. Anstatt Sätze zu formulieren, gibt das System für jede zulässige Option eine Wahrscheinlichkeit aus. Artificial Analysis veranschaulicht dies an folgendem Supportfall: „Auszahlungen funktionieren seit 3 Tagen nicht mehr, und morgen ist meine Miete fällig“ (Übersetzung des Testbeispiels). Das Modell beantwortet drei Fragen gleichzeitig:
- Zuständige Abteilung - Zahlungen, Technik oder Konto (Auswahl aus einer Liste),
- Dringlichkeit - ja oder nein,
- Frustrationsgrad des Kunden - ruhig, frustriert, wütend (Skala).
Ein Entscheidungsmodell verarbeitet alle drei Punkte in einem einzigen Durchlauf und gibt eine Wahrscheinlichkeitsverteilung zurück. Ein herkömmliches LLM müsste hierfür ein JSON-Objekt generieren, das anschließend geparst werden muss, ohne verlässliche numerische Konfidenzwerte zu liefern. Eine ausführlichere Einordnung finden Sie in der Übersicht zu Entscheidungsmodellen in der KI.
Artificial Analysis Decision Index v1.0 im Ranking
| Modell (Hersteller) | Index | Kosten pro 1 Mio. Aufgaben | Latenz pro Aufgabe |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | ca. 37,54 EUR (42 USD) | 0,13 s |
| GLiDE (Fastino Labs) | 54 | ca. 106,36 EUR (119 USD) | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | ca. 27,71 EUR (31 USD) | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | ca. 15,19 EUR (17 USD) | 0,17 s |
| Mercury Decide (Inception) | 53 | ca. 26,81 EUR (30 USD) | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | ca. 28,60 EUR (32 USD) | 0,06 s |
| d1 (Liquid AI) | 50 | ca. 26,81 EUR (30 USD) | 0,30 s |
| Clef (Cloudflare) | 49 | ca. 177,87 EUR (199 USD) | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | ca. 70,61 EUR (79 USD) | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | ca. 28,60 EUR (32 USD) | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | ca. 109,94 EUR (123 USD) | 0,17 s |
Zum Vergleich Sprachmodelle unter denselben Bedingungen: Claude Haiku 5.5 (low) erreicht 61 Punkte bei ca. 164,46 EUR (184 USD) und 1,4 s; GPT-6 Luna (low) kommt auf 55 Punkte bei ca. 117,09 EUR (131 USD) und 1,5 s. Die Zeitangabe entspricht dem Median pro Aufgabe. Die Kosten basieren auf dem durchschnittlichen Aufwand nach Tokenpreisen, hochgerechnet auf eine Million Aufgaben. Entscheidungsmodelle berechnen ausschließlich Input-Token, während Sprachmodelle sowohl für Input- als auch für Output-Token abrechnen.
So wird der Index berechnet
Der Decision Index setzt sich als gewichteter Durchschnitt aus vier Teilbereichen zusammen, die jeweils mit 25 Prozent gewichtet werden:
- AA-Omniscience-Decision (Faktenwissen und Halluzinationen) - 500 nicht-öffentliche Fragen mit fünf Optionen: vier Antworten und „Ich weiß es nicht“. Die Wertung teilt sich je zur Hälfte auf Korrektheit und auf die Quote auf, in der das Modell Nichtwissen deklariert statt zu raten.
- HLE-MultiChoice (Logisches Denken) - 513 Multiple-Choice-Fragen aus Humanity’s Last Exam, einem besonders anspruchsvollen Benchmark für KI-Systeme.
- When2Call (Tool-Auswahl) - Test von NVIDIA: Das Modell analysiert einen Dialogverlauf samt Tool-Liste und entscheidet, ob es direkt antwortet, ein Werkzeug aufruft, Rückfragen stellt oder meldet, dass die Aufgabe nicht lösbar ist.
- WildGuardTest (Klassifikation und Moderation) - Testset von Ai2: Erkennung schädlicher Benutzeranfragen, Überprüfung von Modellantworten auf Ablehnungen und Sicherheitsrisiken.
Wichtigste Erkenntnisse der Benchmark-Ergebnisse
- Jev überzeugt beim logischen Schließen. In HLE-MultiChoice erreicht das Modell 21 Punkte; kein anderes Entscheidungsmodell kommt über 15 Punkte hinaus. Bei Wissensfragen liegt die Genauigkeit jedoch nur bei 35 Prozent (Spitzenwert: d1 von Liquid AI mit 41 Prozent).
- Microsoft-Decision-1 erkennt Wissenslücken am besten. Das Modell wählt zu 40 Prozent die Option „Ich weiß es nicht“ (Jev: 35 Prozent, Mercury Decide: 32 Prozent, alle übrigen unter 17 Prozent). d1 erzielt zwar die höchste Wissenspräzision, gibt aber fast nie Unwissenheit zu (Wert: 2).
- Bei der Werkzeugauswahl sind Entscheidungsmodelle schneller und präziser als LLMs. Im When2Call-Test erreichen Celeris-1 Decision und GLiDE jeweils 84 Punkte, während Claude Haiku 5.5 (low) auf 73 und GPT-6 Luna (low) auf 77 Punkte kommt.
- Starke Leistung bei der Klassifikation. Im WildGuardTest erreicht GLiDE 95 Punkte, Jev und Decider folgen mit je 94 Punkten. Claude Haiku 5.5 (low) erzielt 93, GPT-6 Luna (low) 89 Punkte.
- Übersteigertes Vertrauen über alle Systeme hinweg. Der Abgleich zwischen ausgewiesener Wahrscheinlichkeit und tatsächlicher Trefferquote zeigt: Bei Wissen und logischem Schließen ist die Fehlerquote höher als die angenommene Sicherheit. Bei Klassifikations- und Routing-Aufgaben attestiert Artificial Analysis eine vergleichsweise solide Kalibrierung.
Warum Entscheidungsmodelle günstiger als LLMs arbeiten
Entscheidungsmodelle generieren keine Text-Token. Sie analysieren die Eingabe in einem einzigen Durchlauf, ermitteln die Wahrscheinlichkeitsverteilung für alle Optionen parallel und schließen den Aufruf ab. Daraus ergeben sich drei operative Vorteile:
- Abrechnung ausschließlich nach Input-Token. Es fallen keine Kosten für Output-Token oder zwischenzeitliche Reasoning-Schritte an.
- Mehrere Abfragen pro Aufruf anstelle schrittweise erzeugter JSON-Strukturen im Textfluss.
- Latenzen im Millisekundenbereich. Typische Bearbeitungszeiten liegen zwischen 0,06 und 0,5 Sekunden pro Aufgabe, verglichen mit 1,4 bis 1,5 Sekunden bei kleineren LLMs im Sparmodus.
Dieser Unterschied wirkt sich bei hohem Durchsatz deutlich aus. Für reine Klassifikationsaufgaben (WildGuardTest) ermittelte Artificial Analysis Kosten von ca. 10,82 EUR (12,1 USD) für Decider und ca. 20,38 EUR (22,8 USD) für Jev pro Million Durchläufe - verglichen mit ca. 81,78 EUR (91,5 USD) bei Claude Haiku 5.5 (low).
Typische Einsatzbereiche in der Praxis
Der Einsatz lohnt sich insbesondere bei hohen Volumina und geschlossenen Entscheidungsräumen:
- Klassifizierung und Routing von Support-Tickets, E-Mails und Dokumenten,
- Kommentarmoderation und Erkennung problematischer Anfragen,
- Tool-Auswahl in Agenten-Architekturen zur Entscheidung zwischen Werkzeugaufruf und Nachfrage,
- Qualitätsfilter zur Einstufung: freigeben, überarbeiten oder an Mitarbeitende eskalieren.
Weniger geeignet sind Entscheidungsmodelle, wenn detailliertes Weltwissen abgefragt oder Fließtext erzeugt werden soll. Bei Wissensfragen liegt Claude Haiku 5.5 (low) bei 52 Prozent Genauigkeit und GPT-6 Luna (low) bei 66 Prozent, während Entscheidungsmodelle zwischen 28 und 41 Prozent rangieren. Für ausformulierte Antworten an Kundinnen und Kunden bleibt ein reguläres Sprachmodell unverzichtbar.
Ausblick
Artificial Analysis aktualisiert das Ranking fortlaufend und bindet weitere Modelle ein. Eine detaillierte Übersicht aller Einzeltests sowie Einblicke in frühere Testläufe finden Sie im Leitfaden zu Entscheidungsmodellen in der KI. Vertiefende Berichte zu einzelnen Systemen bieten zudem die Artikel zu Jev von TypeSafe, Cloudflare Clef und Strands Decider 2B von AWS.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Quellen
- Artificial Analysis: Artificial Analysis Decision Index v1.0 (13.10.2026)
- Artificial Analysis: Decision Index - Live-Ranking (Datenstand vom 13.10.2026)
- Artificial Analysis: Methodik des Decision Index
- Artificial Analysis auf X (Beitrag vom 13.10.2026)
More on this from WISSNOX

 magazin·Thélyson Orélien und der KI-Detektor: Ich habe den preisgekrönten Roman getestet - 100 %, 85 % und 0 % KIDer Fall Orélien kurz erklärt und mein Test der Romanauszüge mit Pangram, AUTHORRA und ZeroGPT - mit Zola und einem KI-Text als Kontrolle.