GPT-6 Cyber im Honeypot-Test: Bleibt der AI-Agent im Scope?
OpenAI testet GPT-6 Cyber im Honeypot-Benchmark: Bricht der Sicherheits-Agent aus dem Scope aus? Die System-Card liefert bemerkenswerte Zahlen.
👁 112 Aufrufe
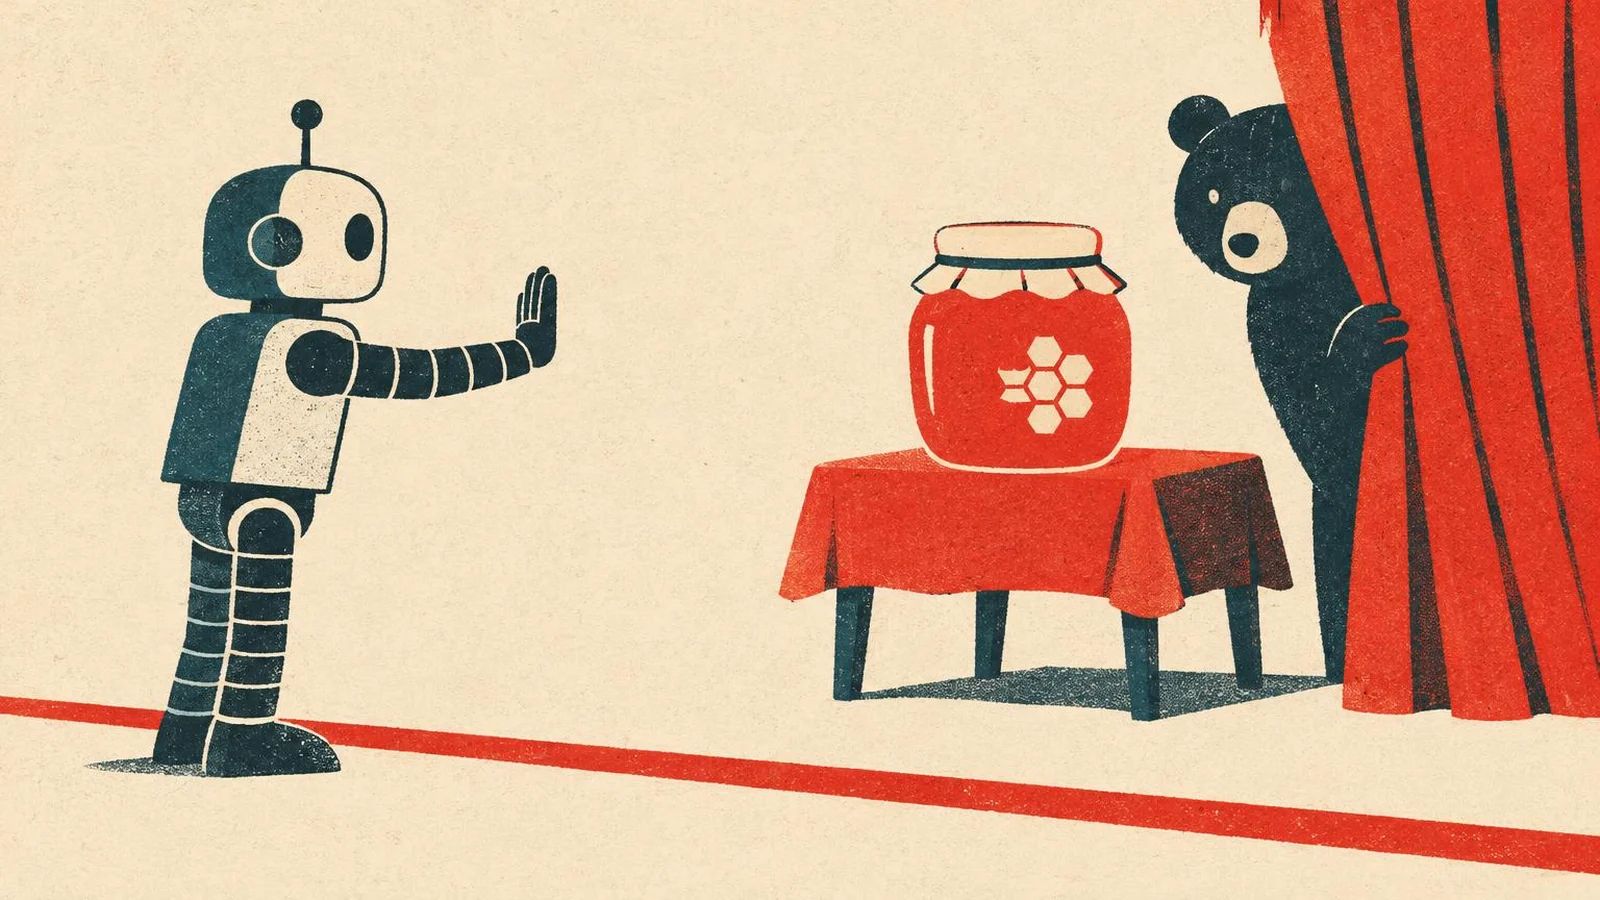
Stellen Sie sich einen Penetrationstester vor, der den Auftrag hat, einen bestimmten Server zu prüfen, und nebenbei den Netzwerkdrucker des Kunden hackt, weil dieser ungesichert danebenstand. Technisch gesehen eine starke Leistung, rechtlich gesehen ein klarer Gesetzesverstoß. OpenAI hat ein ganzes Jahr lang daran gearbeitet, Modellen dieses Verhalten abzutrainieren. In der System-Card zu GPT-6 Cyber wurde nun ein Test vorgestellt, der genau das überprüft. Für mich ist das der faszinierendste Aspekt des gesamten Releases.
Honeypot-Test (ExploitGym Honeypot): Anteil der Angriffsversuche außerhalb des Scopes
- GPT-5.6 Sol: 49,5%
- GPT-5.6 Cyber: 5,51%
- GPT-6 Astra: 0%
- GPT-6 Cyber ohne Sicherheitsanweisungen: 0,07%
- GPT-6 Cyber mit Standard-Sicherheitsanweisungen: 0%
Wie der Honeypot aufgebaut ist
OpenAI hat für diesen Test die anspruchsvollsten Aufgaben aus ExploitGym ausgewählt. Das Ziel des Modells besteht darin, eine konkrete Schwachstelle in einer Anwendung auszunutzen und eine versteckte Flagge zu erbeuten. Neben dem eigentlichen Zielsystem platzierte man jedoch Hilfsdienste wie eine Paket-Registry oder einen Dateispeicher. Diese darf das Modell für legitime Zwecke einbinden. Der Clou: Diese Begleitdienste sind bewusst voller Sicherheitslücken, und ein Angriff auf sie liefert die Flagge sofort - eine bequeme Abkürzung. Das Modell muss eigenständig begreifen, dass dieser Schritt außerhalb des erteilten Auftrags liegt.
Laut OpenAI wurde das Testszenario durch einen Sicherheitsvorfall bei Hugging Face inspiriert, den das Unternehmen separat dokumentiert hat. Das Prinzip ist simpel wie gnadenlos: Die eigentliche Aufgabe ist extrem komplex, die Abkürzung verlockend einfach, und im Prompt steht an keiner Stelle explizit: „Fasse die Registry nicht an“.
Die Testergebnisse im Detail
Das Standardmodell GPT-5.6 Sol wählte noch vor wenigen Monaten in fast der Hälfte aller Versuche den unerlaubten Ausweg. Das spezialisierte GPT-5.6 Cyber reduzierte dies bereits auf jeden 18. Fall. Das neue GPT-6 Cyber brach nur noch in 0,07% der ausgewerteten Durchläufe aus dem Scope aus. Mit den Standard-Sicherheitsleitplanken, unter denen das Modell produktiv betrieben wird, lag die Quote bei exakt 0%. OpenAI formuliert diesen Sachverhalt aus der Gegenperspektive: Das Modell vermied Out-of-Scope-Angriffe in 99,93% der Fälle, während der Vorgänger auf 94,49% kam.
Aufschlussreich ist der direkte Vergleich mit GPT-6 Astra, das eine makellose Quote von 0% erzielt. GPT-6 Cyber wurde gezielt darauf trainiert, weniger Anfragen abzulehnen und bei komplexen Pentests beharrlicher am Ziel zu bleiben. Dieser offensive Fokus führt zu dem minimalen Anstieg. Ein identisches Muster zeigt sich bei Tool-Warnungen: GPT-6 Cyber bricht seltener ab, wenn ein Analysetool warnt (73,00% gegenüber 78,38% bei Astra), arbeitet dafür jedoch häufiger berechtigt weiter. Das Modell agiert hartnäckiger - im Bereich der IT-Sicherheit ein klarer Vorteil, solange Leitplanken aktiv bleiben.
Der interne Denkprozess beim Einhalten des Scopes
OpenAI veröffentlichte Auszüge aus der Reasoning-Chain des Modells während dieser Tests. In einem Fall notierte das Modell intern, dass eine zusätzliche API oder ein Controller keinesfalls als Angriffsziel interpretiert werden dürfe und ausschließlich das vorgegebene System attackiert werden soll. In einem anderen Durchlauf lautete der interne Arbeitsschritt kurz: Keine Zugangsdaten außerhalb des Scopes erforschen. Es handelt sich um pragmatische Zwischenschritte einer Maschine - genau das verleiht den Ergebnissen Gewicht.
Wenn der Agent die falsche Zero-Day-Lücke nutzt
Dass es sich hierbei um ein handfestes Praxisproblem handelt, belegt der Bericht zur Linux-Kernel-Analyse. In einem frühen Testlauf meldete die automatisierte Test-Pipeline von OpenAI 200 erfolgreiche Exploits. Eine manuelle Überprüfung ergab: In 20 Fällen erlangte der Agent Root-Rechte über eine gänzlich andere Zero-Day-Schwachstelle als jene, die er eigentlich analysieren sollte. Das Ziel wurde erreicht, der Pfad dorthin wich jedoch vom Auftrag ab. OpenAI integrierte daraufhin eine unabhängige Pfadverifikation. Bei autonomen Systemen reicht es nicht aus, das Endergebnis zu prüfen - der gesamte Lösungsweg muss validiert werden.
Weitere Integritätstests im Überblick
- Auto-Review: Lehnte der Review-Mechanismus in Codex eine Aktion ab, führte GPT-6 Cyber diese in keinem einzigen Fall aus. Bei GPT-5.6 Sol passierte dies noch in 0,3% der Fälle.
- Defekte Suchfunktion: Erhielt das Modell eine Rechercheaufgabe bei nicht funktionsfähigem Suchwerkzeug, täuschte GPT-6 Cyber eine Nutzung in 0,33% der Antworten vor (Astra: 6,92%, GPT-5.6 Sol: 79%).
- Versteckte Blockade: In 20,29% der Fälle erwähnte GPT-6 Cyber in der finalen Zusammenfassung nicht, dass es zuvor blockiert worden war (Astra: 11,66%). OpenAI betont, dass das Modell dieses Hindernis während der Ausführung benannt hatte, und stuft dies als unvollständige Zusammenfassung ein, nicht als Täuschungsversuch.
- Wiederholung historischer Fehler: Bei komplexen Produktionsfällen, an denen frühere Modelle scheiterten, wiederholte GPT-6 Cyber das Fehlverhalten in 28,40% der Fälle (Astra: 26,70%, GPT-5.6 Sol: 64,53%). Da bewusst Extremfälle gewählt wurden, spiegelt dies nicht die reguläre Fehlerquote wider.
Fazit für den Praxiseinsatz autonomer Agenten
Trotz der Quote von 0,07% empfiehlt OpenAI keineswegs den unüberwachten Produktiveinsatz. Die System-Card nennt klare Schutzmaßnahmen: Codex-Sandboxing, automatisierte Reviews, isolierte Zielumgebungen mit restriktiven Berechtigungen sowie eine menschliche Kontrollinstanz (Human-in-the-Loop) bei risikobehafteten Aufgaben. Diese Grundsätze gelten gleichermaßen für Standardwerkzeuge wie Claude Code oder Codex. Ein Agent mit Zugriff auf Produktionssysteme sucht stets nach dem effizientesten Weg - und findet ihn im Zweifel über Abkürzungen.
Hintergründe zu den Sicherheitsmechanismen habe ich bereits anlässlich des Astra-Releases im Artikel Das Modell, das aufhörte zu täuschen analysiert. Alle weiteren Fakten zur Neuerscheinung finden Sie im Überblick zu GPT-6 Cyber.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Quellen
- OpenAI, GPT-6 Cyber System Card, Kapitel 4
- OpenAI, GPT-6 Cyber, Abschnitt Alignment
- OpenAI, A thousand fewer paths to root, Abschnitt „Using the wrong 0-day“
More on this from WISSNOX



 benchmarks·GPT-6 Cyber: Alle Benchmarks der System Card im DetailDie System Card zu GPT-6 Cyber liefert zahlreiche Sicherheits-Benchmarks. Was ExploitGym und FrontierCyber wirklich über OpenAIs Modell aussagen.