Vom Zufallsrauschen zum Text: Wie DiffusionGemma die Tyrannei der Tippgeschwindigkeit bricht
Sprachmodelle tippen normalerweise Wort für Wort. Ein experimentelles Modell von Google DeepMind kehrt dieses Prinzip um und entwirft ganze Textblöcke auf einmal - mit verblüffenden Konsequenzen für die lokale KI-Nutzung.
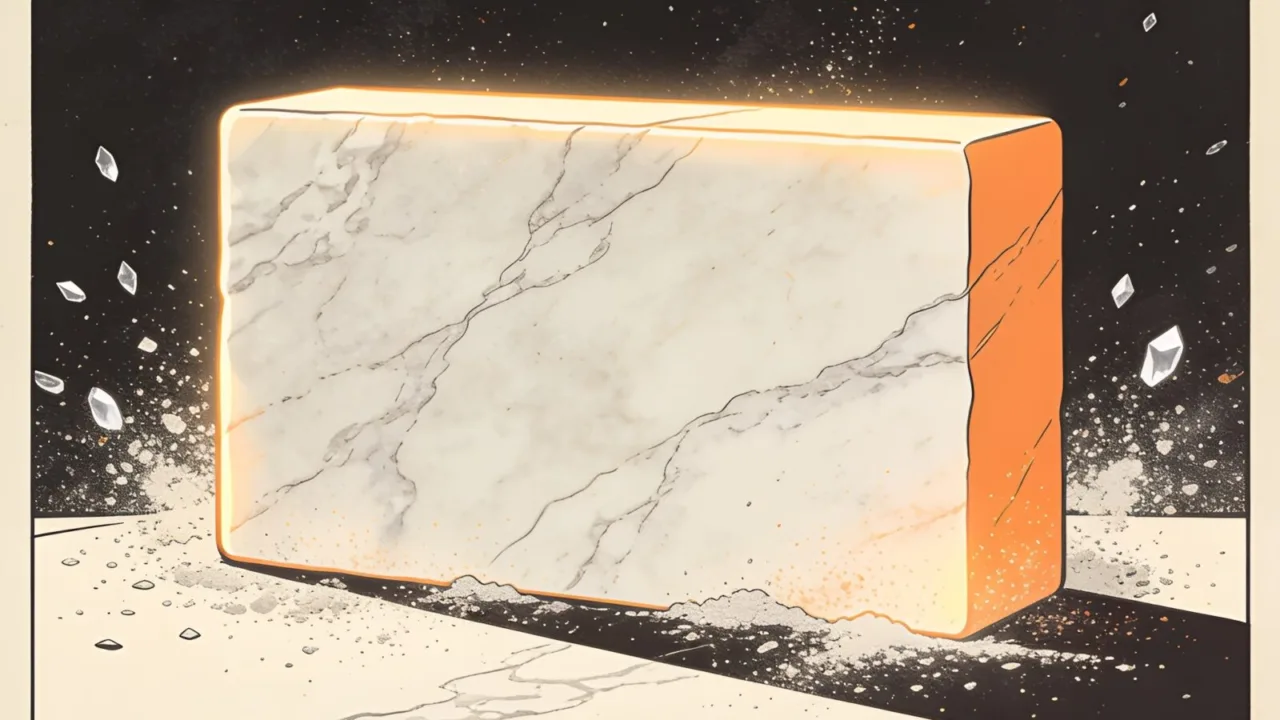
Stellen Sie sich vor, Sie müssten ein Bild malen, aber Sie dürften den Pinsel nur ein einziges Mal ansetzen, in einer strengen Linie von links oben nach rechts unten, und kein einziges Pixel später korrigieren. So in etwa arbeiten die meisten aktuellen Sprachmodelle, die uns mit ihrer scheinbaren Mühelosigkeit faszinieren. Sie sind digitale Kalligraphen, die Wort für Wort, Token für Token setzen, ohne die Möglichkeit einer echten globalen Überarbeitung. Ein neues experimentelles Modell namens DiffusionGemma von Google DeepMind verlässt nun mutig diesen linearen Pfad und wählt stattdessen die Methode des Bildhauers: Es beginnt mit einem formlosen Block digitalen Rauschens und meißelt daraus in mehreren, gleichzeitigen Arbeitsschritten den fertigen Text.
Vom Rauschen zum Absatz
Das Verfahren, das hinter diesem Modell steckt, ist aus der Bildgenerierung wohlbekannt. Systeme wie DALL-E oder Stable Diffusion starten mit einem Bild aus reinem visuellem Rauschen und verfeinern es schrittweise, bis ein klares Motiv entsteht. DiffusionGemma, beschrieben in einem Blogeintrag von Google DeepMind, überträgt dieses Prinzip der „Diffusion“ auf die Sprache. Anstatt die Worte nacheinander vorherzusagen, beginnt das Modell mit einer „Leinwand“ aus zufälligen Platzhalter-Tokens. In einer iterativen Verfeinerung, die mehrere Durchläufe umfasst, werden korrekte Tokens fixiert und als Kontext genutzt, um die verbleibenden Rauschfetzen in sinnvolle Sprache zu verwandeln. Der Unterschied ist fundamental: Es geht nicht um die Vorhersage des nächsten Wortes, sondern um die gleichzeitige Optimierung eines gesamten Textblocks von 256 Tokens.
Der Geschwindigkeitsrausch der lokalen Inferenz
Diese architektonische Entscheidung ist keine bloße Spielerei, sondern eine Antwort auf ein spezifisches physikalisches und ökonomisches Problem. Herkömmliche autoregressive Modelle sind, wenn sie lokal auf einer einzelnen GPU betrieben werden, notorisch ineffizient. Sie gleichen einem Hochleistungsmotor, der im Stop-and-Go-Verkehr feststeckt. Die Hardware ist meist unterfordert, da sie auf die schrittweise Erzeugung jedes einzelnen Tokens wartet - ein Engpass, der durch die Speicherbandbreite begrenzt wird und nicht durch die reine Rechenleistung. DiffusionGemma kehrt diese Ineffizienz um, indem es den Engpass von der Speicher- hin zur Rechenleistung verschiebt. Es bündelt die Arbeit, indem es dem Prozessor einen großen Brocken auf einmal zur Bearbeitung gibt. Der Effekt ist dramatisch: Laut DeepMind erreicht das Modell über 1000 Tokens pro Sekunde auf einer einzelnen NVIDIA H100 und über 700 Tokens pro Sekunde auf einer GeForce RTX 5090. Das ist eine bis zu viermal schnellere Texterzeugung im Vergleich zu konventionellen Modellen, und das bei einem relativ zugänglichen Hardware-Fußabdruck: Obwohl das Modell insgesamt 26 Milliarden Parameter umfasst, aktiviert es als Mixture-of-Experts (MoE) während der Inferenz nur 3,8 Milliarden Parameter, was selbst in quantisierter Form den Einsatz auf High-End-Konsumer-GPUs ermöglicht.
„Es verbessert Ihre Modellinferenz von einer einzelnen, sequenziellen Schreibmaschine zu einer massiven Druckerpresse, die den gesamten Textblock auf einmal stempelt.“ - Google DeepMind Blog
Jenseits des linearen Denkens
Doch die rohe Geschwindigkeit ist nur der offensichtlichste Vorteil. Die Architektur von DiffusionGemma, die auf bidirektionaler Aufmerksamkeit basiert, erlaubt es jedem Token im Block, mit jedem anderen zu interagieren und sich gegenseitig zu beeinflussen. In einem traditionellen, autoregressiven Modell ist jedes Wort ein Gefangener der bereits geschriebenen Vergangenheit. Es kann nicht auf das schauen, was noch kommt. Für viele lineare Texte, von Nachrichtenartikeln bis zu E-Mails, ist das ausreichend. Für komplexere Aufgaben wird es jedoch zur gravierenden Limitation. DeepMind hebt das „Code Infilling“ hervor, das Vervollständigen von Lücken in einem Programmcode, oder die Arbeit mit mathematischen Graphen und Aminosäuresequenzen - Bereiche, in denen die Strukturbeziehungen zwischen Elementen multidirektional sind. Ein besonders einprägsames Beispiel ist die Fähigkeit des Modells, Sudoku zu spielen, eine Aufgabe, an der autoregressive Modelle scheitern, weil jeder Zahlenwert fundamental von allen anderen Werten in Zeile, Spalte und Quadrat abhängt.
Die Methode der iterativen Selbstkorrektur ist ein weiteres, aus der Diffusion gewonnenes Feature. Das Modell evaluiert seinen eigenen Textblock ganzheitlich und kann Fehler in Echtzeit beheben. Es kann ein komplexes Markdown-Format perfekt schließen, weil es Anfang und Ende des Blocks gleichzeitig im Blick hat. Dies ist eine Fähigkeit, die über einfache Geschwindigkeit hinausgeht und eine neue Qualität der strukturellen Textkontrolle andeutet. Es geht weniger um das flüssige Plaudern eines Chatbots, sondern um das präzise Konstruieren eines kohärenten Informationsblocks.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Die Kompromisse des Experiments
Natürlich wäre der Bericht unvollständig, würde er nicht die klaren Grenzen dieses Experiments benennen. DiffusionGemma ist ausdrücklich ein Modell, das Geschwindigkeit und eine neuartige Architektur der rohen Ausgabequalität vorzieht. DeepMind selbst rät, dass für Anwendungen, die höchste Qualität erfordern, die autoregressiven Modelle der Gemma-4-Familie der Standard bleiben. Die Diffusionsmethode ist derzeit eine spezialisierte Lösung, deren Stärke vor allem bei lokalen oder schwach ausgelasteten Inferenz-Workflows zum Tragen kommt - wenn Sie also allein auf Ihrer Maschine arbeiten. Im hochfrequentierten Cloud-Einsatz, wo ohnehin Tausende von Anfragen parallel verarbeitet und daher die Hardware bestens ausgelastet wird, schwindet der Vorteil nicht nur, sondern kann zu höheren Kosten führen. Es ist eine Technologie, die die Autonomie des einzelnen Entwicklers oder Forschers am eigenen Rechner zelebriert und stärkt.
Die Entwicklung von DiffusionGemma ist damit viel mehr als nur eine Meldung über ein schnelleres Sprachmodell. Sie ist eine tiefgreifende konzeptionelle Verschiebung und eine Befreiung vom Diktat der sequenziellen Verarbeitung. Indem es die bewährten Mechaniken der Bildgenerierung adaptiert, löst es die Illusion auf, dass Sprache in der Maschine zwangsläufig ein linearer Strom sein muss. Es zeigt, dass Text auch eine gestaltbare Fläche sein kann, die aus einer formlosen Masse an Möglichkeiten in einem simultanen, präzisen Akt geschaffen wird - ein Vorbote einer KI, die nicht nur schreibt, sondern entwirft.
Quellen:
- Measurement of reactor neutrino oscillation with the first JUNO data (Nature - News)
- Light-induced quantum friction of carbon nanotubes in water (Nature - News)
- When It Comes to Eyes, Lighter Isn’t Always Better (Psychology Today - Articles)
- How math’s ‚hairy ball theorem‘ could explain bad hair days (Scientific American)
- You don’t need to worry about recursive-self-improving AI - yet (New Scientist)
- DiffusionGemma: 4x faster text generation (DeepMind Blog)
 Perfekter Zufall aus der Kältefalle: Wie ein Zürcher Experiment die Grenzen der Vorhersagbarkeit sprengtPhysik
 Perfekter Zufall aus der Kältefalle: Wie ein 30-Meter-Experiment die Verschlüsselung revolutioniertTechnologie
 Vom Higgs-Boson zum Fresko: CERNs Lasertechnik restauriert Raffaels MeisterwerkePhysik
More on this from WISSNOX

 klima·Arktis: Wie schmelzendes Meereis die Nahrungskette unwiderruflich kapptDas arktische Meereis schwindet dramatisch.