Wie prüft man, ob eine KI wirklich vergisst? Die Mathematik hinter dem digitalen Gedächtnislöschen
Das „Recht auf Vergessenwerden“ gilt auch für KI-Modelle. Doch wie weist man nach, dass ein Algorithmus sensible Daten tatsächlich gelöscht hat? Ein neues mathematisches Prüfverfahren zeigt die Tücken und Grenzen des maschinellen Verlernens.
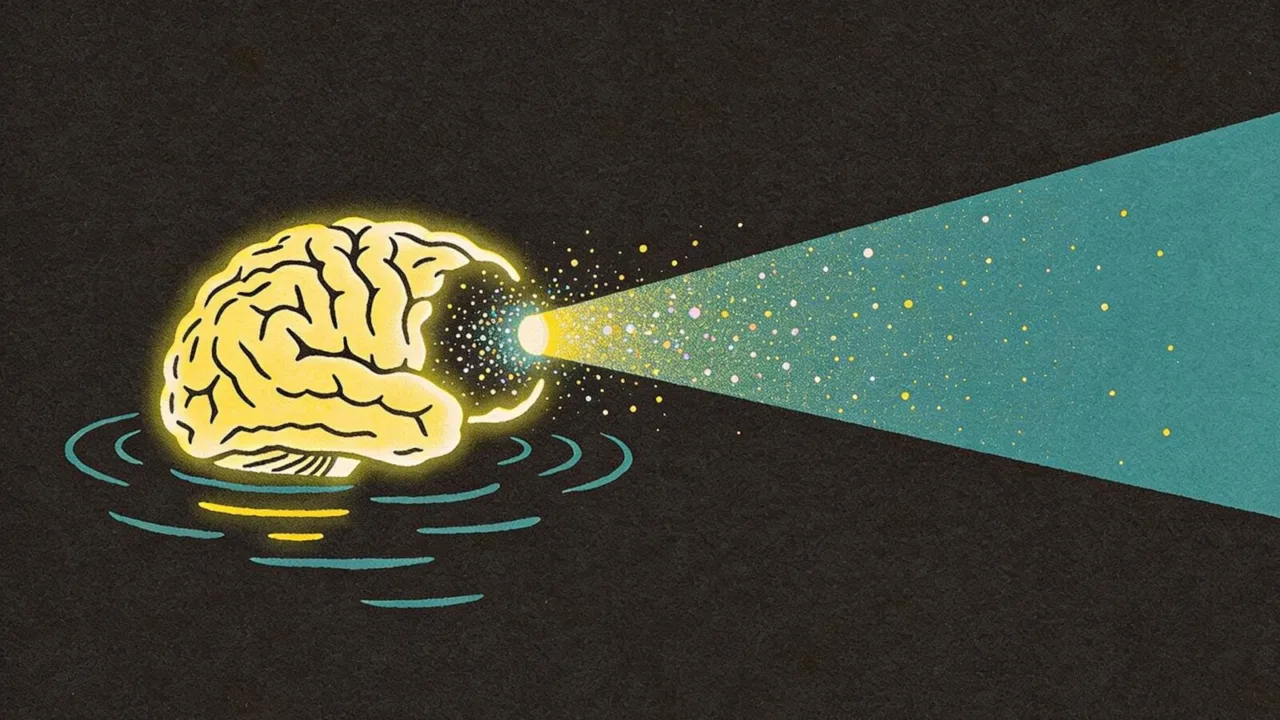
Es ist ein Albtraum für jeden Datenschützer: Ein KI-Modell, trainiert auf Millionen persönlicher Datensätze, soll auf Knopfdruck eine einzelne, spezifische Information löschen. So verlangt es die Datenschutz-Grundverordnung (DSGVO) mit ihrem „Recht auf Vergessenwerden“. Doch während ein Mensch eine peinliche Erinnerung vielleicht verdrängen kann, ist das Vergessen für eine künstliche Intelligenz ein tückisches mathematisches Problem. Die simple Frage lautet: Woher weiß ich, ob das Modell die Daten wirklich vergessen hat - oder ob es nur so tut?
Diese Frage ist längst keine theoretische Spielerei mehr. Da KI-Modelle zunehmend mit hochsensiblen Informationen hantieren, wird die Überprüfung des maschinellen Verlernens (Machine Unlearning) von einer akademischen Übung zu einer strengen regulatorischen Notwendigkeit. Ein Forscherteam von Google Research hat nun ein neues statistisches Framework vorgestellt, das genau diese Prüfung revolutionieren soll. Ihr auf der AISTATS 2026 präsentierter Ansatz der „Regularized f-Divergence Kernel Tests“ verspricht, die Achillesferse bisheriger Prüfmethoden zu beheben - und enthüllt zugleich eine fundamentale Grenze des digitalen Vergessens.
Das Problem mit dem direkten Vergleich
Der naheliegendste Weg, das Vergessen zu überprüfen, klingt simpel: Man vergleicht die Ausgaben des „gelöschten“ Modells mit den Ausgaben eines Modells, das die fraglichen Daten nie gesehen hat. In der Statistik nennt man das einen Zwei-Stichproben-Test. Sind die Ergebnisse statistisch ununterscheidbar, so die Logik, war das Löschen erfolgreich. „Um maschinelles Verlernen zu verifizieren, könnten Prüfer die Ausgaben eines Modells, das einen bestimmten Datensatz nie gesehen hat, mit denen eines Modells vergleichen, das ihn angeblich ‚vergessen‘ hat“, erklärt Mónica Ribero, Research Scientist bei Google Research, in einem Blogbeitrag. „Sind die Ausgaben innerhalb einer definierten Schwelle statistisch verschieden, ist das Verlernen fehlgeschlagen.“
Doch diese Methode hat einen entscheidenden Haken, der sie in der Praxis nahezu unbrauchbar macht. Er wird deutlich, wenn man sich vor Augen führt, wie maschinelles Lernen tatsächlich funktioniert. Trainiert man zwei Modelle mit exakt denselben Daten, aber mit minimal unterschiedlichen Parametern - etwa einer anderen Stapelgröße (Batch Size) - , werden sie leicht unterschiedliche innere Strukturen entwickeln. Ihre Ausgaben werden daher nie perfekt identisch sein. Ein simpler Zwei-Stichproben-Test würde in diesem Fall fälschlicherweise Alarm schlagen und eine Datenschutzverletzung melden, obwohl beide Modelle auf derselben sauberen Datenbasis beruhen. Das ist der klassische „falsch-positive“ Fehler.
Noch gravierender ist ein zweites Problem. Die gängigen Standardwerkzeuge wie die „Maximum Mean Discrepancy“ (MMD) sind hervorragend darin, breite, globale Verschiebungen in den Daten zu erkennen - etwa wenn ein Bildgenerator plötzlich systematisch hellere Bilder produziert. Sie versagen aber oft kläglich, wenn es um hochspezifische, lokale Anomalien geht. „Wenn die Hinzufügung der Daten einer bestimmten Person dazu führt, dass ein Modell nur bei einer sehr spezifischen Eingabe eine hochspezifische Ausreißer-Ausgabe erzeugt, während die Verteilung bei allen anderen Eingaben gleich bleibt, könnten traditionelle MMD-Tests diese lokale Verschiebung komplett übersehen“, so Ribero. Das ist, als würde man mit einem Weitwinkelobjektiv nach einem einzelnen fehlerhaften Pixel suchen.
Die fundamentale Unmöglichkeit des perfekten Vergessens
Das Google-Team stieß bei seiner Arbeit auf eine noch tiefgreifendere Erkenntnis, die das gesamte Konzept des maschinellen Verlernens in Frage stellt. Jüngste Forschungsergebnisse zeigen, dass ein KI-Modell Daten niemals perfekt „vergessen“ kann, indem man nur an seinen aktuellen Einstellungen herumschraubt. Solange es nicht jeden einzelnen Schritt seines ursprünglichen Trainingsprozesses exakt rückwärts durchläuft, wird es immer einen permanenten Fußabdruck der Informationen hinterlassen, die es löschen sollte. „Dementsprechend ist das Erreichen einer perfekten ‚Neu-Trainings-Äquivalenz‘ für standardmäßige, lokale Verlern-Algorithmen grundsätzlich unmöglich, und ein traditioneller Zwei-Stichproben-Test kann immer eine Abhängigkeit vom ‚Vergessens-Set‘ finden“, stellt Ribero fest.
Diese Einsicht ist ein Paukenschlag. Sie bedeutet, dass die naive Vorstellung eines sauberen, punktuellen Löschens eine Fiktion ist. Das Modell trägt die Geister der gelöschten Daten immer ein Stück weit mit sich herum. Die entscheidende Frage verschiebt sich damit von „Ist die Information perfekt verschwunden?“ zu „Ist das Modell dem idealen, nie kontaminierten Modell ähnlich genug, um als sicher zu gelten?“. Genau hier setzt das neue Framework an.
Der relative Test: Näher am Guten als am Schlechten
Statt eines direkten Vergleichs schlagen die Forscher einen relativen Distanztest vor. Dieser misst, ob ein „verlerntes“ Modell in seiner statistischen Verteilung näher an einem sicher neu trainierten Modell liegt oder näher am ursprünglichen, kompromittierten Modell. Es geht nicht mehr um absolute Gleichheit, sondern um relative Nähe. Dieser Dreier-Vergleich ist nicht nur robuster gegenüber den natürlichen Schwankungen im Trainingsprozess, sondern entspricht auch viel eher dem, was in der Praxis von Interesse ist: Wurde der schädliche Einfluss der zu löschenden Daten effektiv genug beseitigt?
Das Herzstück des Frameworks ist die flexible Nutzung sogenannter f-Divergenzen, die es Prüfern erlaubt, sehr spezifische Arten von Datenverschiebungen ins Visier zu nehmen. Zwei davon sind besonders spannend. Die Chi-Quadrat- und Kullback-Leibler-Divergenzen eignen sich hervorragend, um glatte, lokale Unterschiede zu identifizieren - etwa die sprichwörtliche Nadel im Datenheuhaufen. Die Hockey-Stick-Divergenz hingegen ist maßgeschneidert für Datenschutz-Definitionen. Sie arbeitet mit einem einstellbaren Parameter, der ein gewisses Maß an statistischer Ununterscheidbarkeit als „Sicherheitsbudget“ akzeptiert. „Sie etabliert effektiv eine akzeptable Schwelle, ignoriert geringfügige Unterschiede unterhalb dieses Sicherheitsbudgets und schlägt nur Alarm, wenn eine bedeutsame Datenschutzverletzung auftritt“, erklärt Ribero. Das ist die mathematische Umsetzung des Prinzips „So genau wie nötig, nicht so genau wie möglich“.
Von der Teilchenphysik lernen
Um die Leistungsfähigkeit ihres Ansatzes zu demonstrieren, griffen die Forscher zu einem ungewöhnlichen Testfeld: der Hochenergiephysik. Sie verwendeten Daten aus der Suche nach neuen physikalischen Phänomenen jenseits des Standardmodells der Teilchenphysik, insbesondere die Expo1D-Aufgabe zur Erkennung von Ausreißern. Die Logik dahinter ist so elegant wie einleuchtend: Wenn das Framework in der Lage ist, ein seltenes Teilchen zu entdecken, das den Gesetzen der Physik widerspricht, dann kann es auch ein winziges Datenleck in einem KI-Modell aufspüren. Die Physik liefert hier die weltweit präzisesten „Unterschieds-Detektoren“, und das neue mathematische Werkzeug musste sich an diesem Goldstandard messen lassen.
Die Tests blieben nicht auf synthetische Daten beschränkt. Das Team evaluierte sein Framework an realen Algorithmen für maschinelles Verlernen, darunter „Selective Synaptic Dampening“, Pruning und zufällige Label-Techniken. In all diesen Fällen zeigte der relative Test, ob das Verlernen erfolgreich war oder nicht - und das mit einer Treffsicherheit, die bisherige Methoden nicht erreichten. Ein entscheidender Vorteil: Der adaptive Test wählt automatisch die beste Divergenz und die optimalen Hyperparameter aus, ohne dass der Prüfer manuell eingreifen oder Daten aufteilen muss. Das eliminiert eine große Fehlerquelle und macht das Verfahren alltagstauglich.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Was bleibt, ist die Verantwortung
Das neue Framework ist ein großer Schritt, um maschinelles Verlernen aus der rechtlichen Grauzone in die Welt der harten, überprüfbaren Fakten zu holen. Es liefert Entwicklern und Prüfern ein mathematisch fundiertes Werkzeug, um zu beurteilen, ob ein Modell „genug“ vergessen hat. Doch die Arbeit der Google-Forscher macht auch unmissverständlich klar, dass „genug“ niemals „perfekt“ bedeuten kann. Die Idee eines sauberen, chirurgischen Eingriffs ins digitale Gedächtnis bleibt eine Illusion. Stattdessen geht es um Risikomanagement: Wie viel Restinformation ist akzeptabel, und wie weisen wir nach, dass diese Grenze nicht überschritten wurde?
Diese Erkenntnis hat weitreichende Konsequenzen für den Umgang mit KI und Datenschutz. Sie zwingt uns, die Erwartungen an das „Recht auf Vergessenwerden“ im Kontext großer Sprachmodelle zu kalibrieren. Ein absolutes Löschen ist mathematisch unmöglich, ein relatives, nachweisbares und sicheres Verlernen jedoch erreichbar. Die Verantwortung, das richtige Maß zu definieren und die Einhaltung mit den besten verfügbaren Methoden zu kontrollieren, bleibt eine zutiefst menschliche Aufgabe - und eine der drängendsten an der Schnittstelle von Technologie, Recht und Ethik.
Quellen:
- From data to decisions: how LSEG is scaling trusted AI (OpenAI Blog)
- New framework for auditing machine unlearning (Google Research Blog)
- Annual global migration has nearly tripled since 2000, reshaping where and how people move (Phys.org)
- Will Artificial Intelligence Replace Therapy for Addiction? (Psychology Today - Articles)
- Access OpenAI models and Codex through your Oracle cloud commitment (OpenAI Blog)
- Gen Z scepticism towards AI is a wake-up call - universities must take it seriously (Nature - News)
 25 Fields-Medaillen-Träger warnen vor KI-Bedrohung für mathematische ForschungskulturNachrichten
 AI-Wochenrückblick: Sicherheit, Mathematik und politische Blindheit - Woche vom 14-20 JuliStand der KI
 AI-Wochenrückblick: Vertrauen, Preisachterbahnen und die Frage, ob KI wirklich weiß, was sie tutStand der KI
More on this from WISSNOX

 technologie·Dual-Core-Quantencomputer aus China: Wie zwei Atom-Arrays Fehler eindämmen sollenChinesische Forscher haben den ersten Quantencomputer mit zwei unabhängigen Rechenkernen vorgestellt.