Sequential Attention: Wie KI-Modelle lernen, Überflüssiges zu ignorieren - und warum das so schwer ist
Die Auswahl der richtigen Daten ist für KI-Modelle ein fast unmögliches Problem. Forscher von Google zeigen nun, wie ein gieriger Algorithmus neuronale Netze schlanker und schneller macht, ohne dass sie an Genauigkeit verlieren.
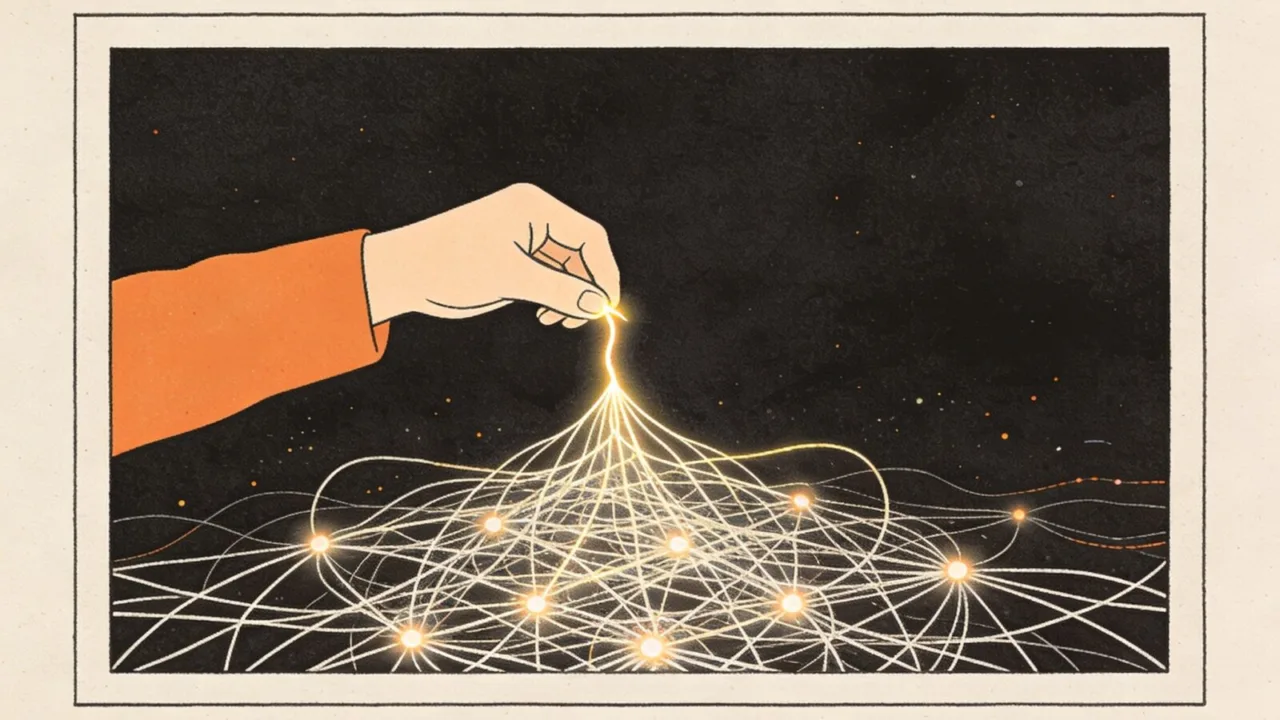
Es ist eines der großen Paradoxa der Künstlichen Intelligenz: Damit ein Modell besser wird, muss es nicht nur lernen, was wichtig ist, sondern vor allem, was es getrost vergessen kann. In einer Welt exponentiell wachsender Datenmengen ist die Fähigkeit, das Rauschen vom Signal zu trennen, längst zu einer überlebenswichtigen Eigenschaft moderner KI-Systeme geworden. Doch diese scheinbar simple Aufgabe, bekannt als Merkmalsauswahl, ist mathematisch gesehen eine der vertracktesten Herausforderungen überhaupt.
„Die Merkmalsauswahl ist NP-schwer, also ein Problem, das mathematisch gesehen ‚unmöglich‘ perfekt und schnell für große Datengruppen zu lösen ist“, erklärt ein Forschungsteam von Google. Was genau es damit auf sich hat und wie eine neue Methode namens Sequential Attention dieses Problem elegant umschifft, hat das Team nun in einem vielbeachteten Paper dargelegt.
Der Fluch der nichtlinearen Wechselwirkungen
Die Schwierigkeit beginnt bei der schieren Komplexität der Interaktionen. In tiefen neuronalen Netzen ist es keineswegs so, dass ein Merkmal, das isoliert betrachtet unbedeutend erscheint, auch wirklich überflüssig ist. Es kann im Zusammenspiel mit anderen Variablen in den nichtlinearen Schichten des Netzes plötzlich entscheidend werden. Umgekehrt kann eine Variable, die alleinstehend hochsignifikant wirkt, durch das Vorhandensein anderer Merkmale vollständig redundant werden.
Standardmethoden, die jedes Merkmal einzeln bewerten - sogenannte Filtermethoden - , scheitern an dieser Hürde systematisch. Sie sind schlicht blind für Kombinationseffekte. Die Alternative, ein gieriger Algorithmus, der schrittweise das jeweils nächste beste Element auswählt, ist theoretisch überlegen, aber praktisch unerschwinglich. Er würde verlangen, das Modell für jedes potenzielle Merkmal in jedem einzelnen Schritt neu zu trainieren oder zu evaluieren - eine Rechenzeit, die bei großen Modellen und Datensätzen schnell astronomische Dimensionen annimmt.
Attention als gieriger Selekteur
Genau hier setzt Sequential Attention an. Der Clou der Methode besteht darin, den teuren externen Bewertungsprozess durch einen extrem günstigen Proxy zu ersetzen: die internen Aufmerksamkeitsgewichte des neuronalen Netzes selbst. Anstatt das Modell für jeden Kandidaten neu zu trainieren, berechnet der Algorithmus in jedem Schritt die Attention-Scores für alle noch nicht ausgewählten Merkmale. Das Merkmal mit dem höchsten Score - also jenes, dem das Modell die meiste „Aufmerksamkeit“ schenkt - wird permanent in die Untermenge aufgenommen.
Danach wird der Vorwärtsdurchlauf wiederholt und die Attention-Gewichte werden für die verbleibenden Kandidaten neu berechnet. Diese Neuberechnung ist entscheidend: Sie bildet auf natürliche Weise den marginalen Gewinn eines Merkmals ab - also den zusätzlichen Nutzen, den es bringt, gegeben all die bereits ausgewählten Merkmale. So erkennt der Algorithmus effektiv Redundanzen und vermeidet es, sie in die Selektion aufzunehmen.
Von der Merkmalsauswahl zur Block-Sparsifikation
Die Anwendung von Sequential Attention geht weit über die reine Merkmalsselektion hinaus. Das Forschungsteam betrachtet das Verfahren als universellen Lösungsansatz für eine ganze Klasse von Optimierungsaufgaben, die sich als Teilmengenauswahlprobleme formulieren lassen. Die Anpassung der Einbettungsdimensionen eines Modells lässt sich beispielsweise als Auswahl einer Teilmenge von Einbettungsblöcken verstehen, das Pruning von Gewichten als Selektion einer Teilmenge von Einträgen aus der Gewichtsmatrix.
Besonders spannend ist die Arbeit zur Block-Sparsifikation. Während unstrukturiertes Pruning einzelne Gewichte entfernt und so unregelmäßige, hardware-unfreundliche Matrizen erzeugt, zielt die strukturierte Block-Sparsifikation darauf ab, ganze Blöcke oder Kanäle von Gewichten zu entfernen. Dies führt zu Modellen, die auf moderner Hardware, von GPUs bis zu spezialisierten KI-Chips, dramatisch schneller ausgeführt werden können. Sequential Attention verspricht hier, die Stärken zweier bisher getrennter Forschungsstränge - differenzierbares Pruning und kombinatorische Optimierung - in einem kohärenten Framework zu vereinen.
Wenn Attention interpretierbar wird
Neben der reinen Effizienz bietet Sequential Attention einen weiteren gewichtigen Vorteil: eine neuartige Form der Interpretierbarkeit. Die Attention-Scores, die der Algorithmus während der Selektion produziert, sind ein mächtiges Diagnosewerkzeug. Sie erlauben Forschern, im Nachhinein zu inspizieren, welche Teile der Eingabe ein Modell priorisiert hat, um eine bestimmte Entscheidung zu treffen oder ein bestimmtes Token zu generieren. Ein Modell, das seine eigene Relevanzhierarchie während des Trainings offenlegt, ist ein großer Schritt weg von der undurchsichtigen Black Box, als die tiefe Netze oft kritisiert werden.
Diese gläserne Eigenschaft hat praktische Konsequenzen: In sensiblen Anwendungsfeldern, von der medizinischen Diagnostik bis zur Kreditvergabe, könnte die Inspektion der Sequentiellen Aufmerksamkeit helfen, nachzuvollziehen, ob ein Modell seine Entscheidung aufgrund klinisch relevanter Merkmale getroffen hat oder aufgrund von Artefakten und Scheinkorrelationen in den Daten. Es ist eine Entwicklung, die das Vertrauen in komplexe KI-Systeme schrittweise erhöhen könnte.
Bewiesene Äquivalenz zu OMP
Dass dieser Ansatz mehr als nur eine ingenieurstechnische Heuristik ist, untermauert eine mathematische Einsicht der Forscher. Sie konnten zeigen, dass Sequential Attention, angewendet auf ein einfaches lineares Regressionsmodell, mathematisch äquivalent zum etablierten Orthogonal Matching Pursuit-Algorithmus ist. Diese Äquivalenz ist kein akademischer Selbstzweck; OMP ist ein Verfahren, für das bewiesene Garantien der Zuverlässigkeit und der Performanz existieren. Die Verbindung zu diesem soliden theoretischen Fundament verleiht den empirischen Erfolgen des neuen Verfahrens auf komplexen Architekturen ein stabiles konzeptionelles Gerüst.
Die Benchmark-Ergebnisse sprechen für sich. Über verschiedene neuronale Netz-Benchmarks hinweg, von Proteomik-Daten über Bilderkennung bis hin zur Aktivitätserkennung, erreichte Sequential Attention wettbewerbsfähige oder führende Ergebnisse. Wichtiger noch: Es tat dies, ohne die Rechenlast in die Höhe schnellen zu lassen. Die Integration der Selektion direkt in einen einzelnen Modelltrainingslauf macht das Verfahren hochgradig skalierbar und für die Anwendung auf modernste, große Modelle mit minimalem Mehraufwand geeignet.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Schlankere Modelle, klarere Gedanken
Die Arbeit an Sequential Attention reiht sich ein in eine breitere Bewegung innerhalb der KI-Forschung, die sich von der schieren Größe der Modelle ab- und ihrer inneren Effizienz zuwendet. Während in den vergangenen Jahren jedes neue, leistungsfähigere Modell vor allem mit seiner ungeheuren Parameterzahl Schlagzeilen machte, rückt nun die Frage in den Vordergrund, wie viel von dieser Masse eigentlich Substanz ist - und wie viel Ballast. Die Antwort, so scheint es, verbirgt sich in der gierigen, schrittweisen und unbestechlich selektiven Struktur der Aufmerksamkeit selbst. Diese algorithmische Eleganz könnte den Weg zu einer Generation von KI-Modellen ebnen, die nicht nur ressourcenschonender und schneller sind, sondern deren innere Mechanismen wir endlich zu verstehen beginnen.
Quellen:
- Improved Gemini audio models for powerful voice experiences (DeepMind Blog)
- A new way to express yourself: Gemini can now create music (DeepMind Blog)
- Running Codex safely at OpenAI (OpenAI Blog)
- The next phase of OpenAI’s Education for Countries (OpenAI Blog)
- Sequential Attention: Making AI models leaner and faster without sacrificing accuracy (Google Research Blog)
- Vibe Coding XR: Accelerating AI + XR prototyping with XR Blocks and Gemini (Google Research Blog)
More on this from WISSNOX

 klima·El Niño als Klima-Kippschalter: Wie pazifische Wärme dauerhafte Regimewechsel auslöstEl Niño ist ein vorübergehendes Phänomen, doch seine Folgen könnten das Klima dauerhaft verändern.