ACE-Step 1.5 im Test: Lokale KI-Musik mit Gesang auf RTX 4090
Mit ACE-Step 1.5 steht ein schnelles Diffusionsmodell unter MIT-Lizenz bereit, das komplette Songs samt Gesang auf der eigenen GPU berechnet. Im Test auf der RTX 4090 überzeugt es durch hohe Texttreue und rasante Renderzeiten.
👁 122 Aufrufe
ACE-Step 1.5 ermöglicht es, vollwertige KI Musik lokal auf der eigenen Grafikkarte samt Gesang und Songtexten zu erzeugen. Das Modell steht unter der freizügigen MIT-Lizenz und unterstützt laut Entwicklern mehr als 50 Sprachen. Wie sich der Musikgenerator in der Praxis schlägt und wie er sich in die Übersicht für lokale KI-Modelle einordnet, habe ich auf meinem Testsystem mit Nvidia RTX 4090 detailliert nachgemessen.
Stand: 17. Oktober 2026
- ACE-Step 1.5: Diffusionsmodell (2B) von ACE Studio und StepFun (Gewichte seit Januar 2026, MIT-Lizenz), Versionen: turbo, base, SFT; seit 2. April 2026 auch als XL (4B).
- Planer-Sprachmodell auf Qwen3-Basis in drei Größen verfügbar: 0,6B, 1,7B und 4B.
- Offizielle Integration in ComfyUI über Vorlagen im Menü „Templates“ mit Dateien von Comfy-Org.
- Mein Testsystem: RTX 4090 24 GB, ComfyUI 0.41, ACE-Step 1.5 turbo mit 1,7B-Planer, gemessen am 17. Oktober 2026; Auswertung der Gesangsverständlichkeit via Whisper large-v3.
Was ist ACE-Step 1.5?
ACE-Step wandelt eine Stilbeschreibung und Songtexte direkt in eine fertige Stereo-Audiodatei mit Gesang um. Die Architektur der Version 1.5 setzt sich aus zwei Kernkomponenten zusammen: einem kompakten Sprachmodell als Planer, der das Stück in Klang-Codes zerlegt, und einem 2B-Diffusionsmodell, das daraus das finale Audiosignal synthetisiert. Laut den Entwicklern lassen sich Audioformate von kurzen Loops bis hin zu zehnminütigen Werken in über 50 Sprachen erstellen. Neben der Neugenerierung beherrscht die Architektur auch Cover-Versionen, Repainting bestimmter Passagen sowie das Hinzufügen von Instrumentalbegleitung zu einer bestehenden Gesangsspur.
Ein entscheidender Vorteil ist die MIT-Lizenz: Sie erlaubt die uneingeschränkte kommerzielle Nutzung der Ergebnisse. Bei offenen Musikmodellen ist das eine Seltenheit. YuE2 ist strikt auf eine nicht-kommerzielle Nutzung beschränkt, während Modelle wie MiniMax Music 3 spezifische Bedingungen an Unternehmen knüpfen. Für rein instrumentale Tracks ohne Vocals kommt alternativ Stable Audio 3 infrage.
ACE-Step in ComfyUI einrichten: Schritt für Schritt
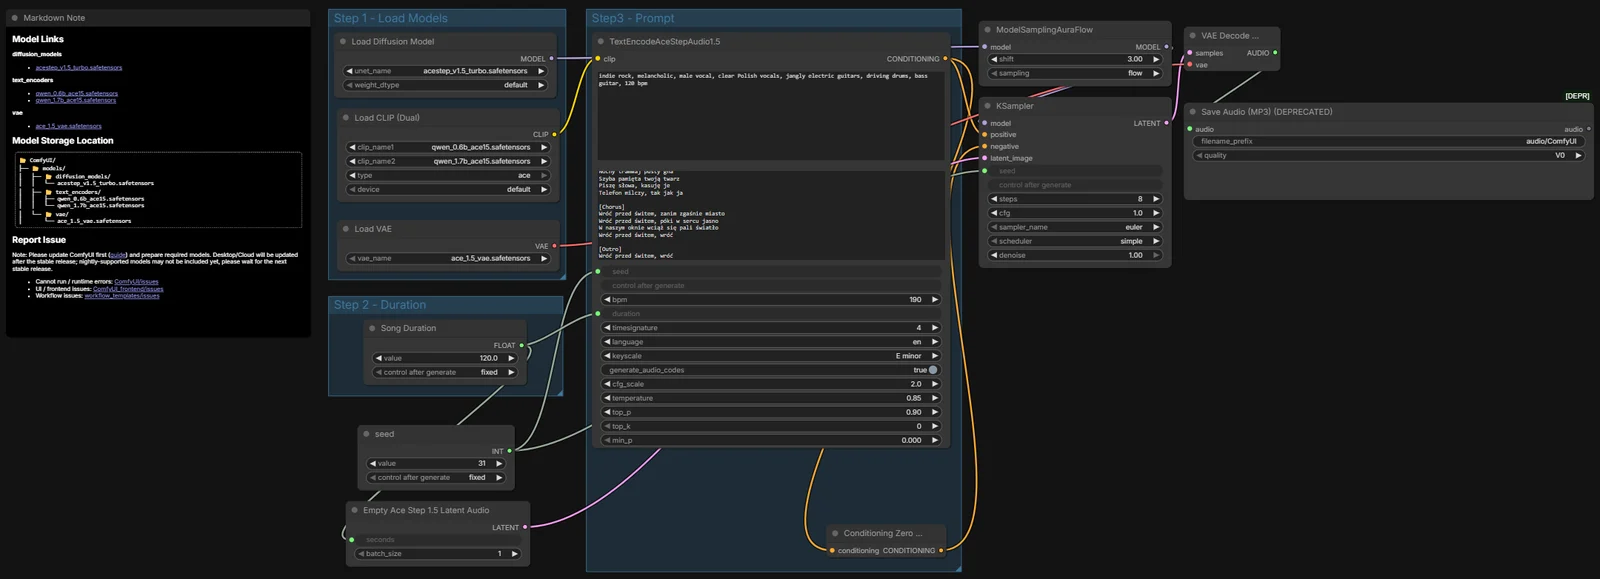
Die manuelle Installation in ComfyUI lässt sich mit wenigen Handgriffen über die offizielle Vorlage umsetzen:
- ComfyUI auf Version 0.41 oder neuer aktualisieren.
- Im Menü Templates nach „ACE-Step 1.5“ suchen und die Vorlage mit getrennten Dateien (split) auswählen.
- Vier Dateien aus dem Hugging-Face-Repository
Comfy-Org/ace_step_1.5_ComfyUI_filesherunterladen:acestep_v1.5_turbo.safetensors(4,8 GB) in den Ordnermodels/diffusion_models, die Dateienqwen_0.6b_ace15.safetensors(1,2 GB) undqwen_1.7b_ace15.safetensors(3,7 GB) inmodels/text_encoderssowieace_1.5_vae.safetensors(0,3 GB) inmodels/vae. Der Download umfasst insgesamt 10 GB. - Im Knoten TextEncodeAceStepAudio1.5 den Stil (Tags), die Songstruktur mit Abschnitten wie
[verse]und[chorus], das Tempo, die Tonart und die gewünschte Sprache einstellen (standardmäßig steht dieser Wert auf „en“). - Die Titellänge im Textblock (duration) und im Knoten EmptyAceStep1.5LatentAudio (seconds) festlegen; im Standard-Template werden beide Felder über einen zentralen Knoten gesteuert.
- Die Warteschlange starten (Run). Die erzeugte Audiodatei wird im Verzeichnis
ComfyUI/output/audioabgelegt.
Die 4B-Variante XL bietet laut Entwicklerangaben eine höhere Klangqualität, benötigt jedoch als Turbo-XL-Datei in bf16 bereits 10 GB und verlangt für den 4B-Planer weitere 8,4 GB. Auf einer 24-GB-Grafikkarte bleibt das machbar, auf kleineren Karten mit 12 GB ist dieser Modus ohne Offloading nicht lauffähig.
Benchmark auf der RTX 4090: KI Musik lokal getestet
Ich habe das Modell ACE-Step 1.5 turbo (8 Inferenzschritte, Planer 1.7B) auf meinem Rechner mit einer RTX 4090 durchgemessen. Zunächst kam ein englischsprachiger Synthpop-Song zum Einsatz, gefolgt von einem mehrsprachigen Härtetest. Die Textgenauigkeit wurde über die automatische Transkription mit Whisper large-v3 ermittelt, indem der Anteil der korrekt gesungenen Wörter im Verhältnis zum Ausgangstext ausgewertet wurde. Die gemessene Zeitspanne umfasst den gesamten Vorgang ab Aufgabenübergabe inklusive Modell-Ladezeiten.
| Testdurchlauf | Wortgenauigkeit | Gesamtzeit | VRAM-Spitze |
|---|---|---|---|
| Englisch (Synthpop) | 96,1% (73/76) | 8,0 s | 15,2 GB |
| Polnischer Test, Seed 11 | 94,0% (78/83) | 35,2 s | 20,0 GB |
| Polnischer Test, Seed 22 | 94,0% (78/83) | 91,4 s | 14,0 GB |
| Polnischer Test, Seed 33 | 98,8% (82/83) | 34,1 s | 10,7 GB |
Die Messwerte verdeutlichen die Stärken der Turbo-Version:
- Enorme Geschwindigkeit im Warm-Zustand: Lag das Modell bereits vollständig im Grafikspeicher, dauerte die Erstellung eines zweiminütigen englischen Songs lediglich 8,0 Sekunden. Die längere Dauer von 91,4 Sekunden bei Seed 22 entstand primär durch das Neuladen von Modellen in ComfyUI.
- Exakte Zeiteinhaltung: Im Gegensatz zu anderen Open-Source-Modellen hält ACE-Step die vorgegebene Titellänge präzise ein und lieferte exakt 120 Sekunden Audio ab.
- Multilinguale Stabilität: Im dreiteiligen Test mit einer nicht-englischen Sprache hielt das System mit 94,0 bis 98,8% verständlichen Wörtern (Durchschnitt: 95,6%) eine sehr konstante Gesangsleistung ohne Auslassungen ganzer Strophen. Lediglich bei komplexen Eigennamen traten phonetische Unschärfen auf.
Vergleich: Vier lokale KI-Musikmodelle im Test
Am 17. Oktober 2026 habe ich vier aktuelle Open-Source-Musikmodelle unter identischen Bedingungen verglichen. Ausgewertet wurden sowohl ein englischer Synthpop-Track als auch ein dreiteiliger Sprachtest mit komplexen Lyrics (83 Wörter), um die Gesangspräzision zu überprüfen.
| Modell | Englisch | Mehrsprachig (Ø) | Lizenz |
|---|---|---|---|
| ACE-Step 1.5 turbo | 96,1% | 95,6% | MIT (kommerziell) |
| YuE2 (3B, bf16) | 100% | 91,2% | CC BY-NC 4.0 |
| MiniMax Music 3 | 92,1% | 89,2% | Community (Auflagen) |
| DiffRhythm 2 | 100% | 4,8% | Apache 2.0 |
Hinsichtlich des Ressourcenbedarfs und der Generierungszeiten zeigen sich deutliche Unterschiede zwischen den Architekturen:
| Modell | Laufzeit Song | VRAM-Spitze |
|---|---|---|
| ACE-Step 1.5 turbo | 34-91 s (warm: 8 s) | 10,7-20,0 GB |
| YuE2 (bf16) | 61-108 s | 13,3-16,3 GB |
| MiniMax Music 3 | 113-178 s (EN: 305 s) | 18,4-24,1 GB |
| DiffRhythm 2 | ca. 60 s | nicht gemessen |
YuE2 erreichte im englischen Durchlauf eine perfekte Worttreue von 100% in 32 Sekunden (Songlänge: 1:57 Min.), zeigte im multilingualen Bereich jedoch eine breitere Streuung (zwischen 84,3% und 98,8%). DiffRhythm 2 beherrscht rein englische und chinesische Phonetik; bei anderen Texten bricht die Erkennung auf 4,8% ein. MiniMax Music 3 belegte bis zu 24,1 GB VRAM, neigt bei voller Speicherlast zu spürbaren Verzögerungen und schnitt Tracks im Test vorzeitig nach 73 bis 111 Sekunden ab. Ein detaillierter Blick auf Betriebskosten im Vergleich zu Cloud-Diensten findet sich im Beitrag über lokale KI-Modelle oder API-Kosten.
Welches Modell eignet sich für welchen Zweck?
- Kommerzielle Audioprojekte: ACE-Step 1.5 ist dank MIT-Lizenz uneingeschränkt nutzbar, liefert reproduzierbare Resultate und lässt sich auch für Social-Media-Inhalte oder Jingles ohne Lizenzrisiken einsetzen.
- Höchste englische Texttreue: YuE2 liefert bei englischen Texten fehlerfreie Transkriptionen (100% im Test), verbietet über die CC BY-NC 4.0 jedoch jegliche kommerzielle Verwertung.
- Geringes Zeitbudget: Mit nur 8 Sekunden reiner Rechenzeit für 2 Minuten Audio deklassiert ACE-Step 1.5 Turbo die Konkurrenz bei schnellen Iterationen.
Häufig gestellte Fragen (FAQ)
Kann ACE-Step 1.5 kommerziell genutzt werden?
Ja, das Modell steht unter der permissiven MIT-Lizenz. Damit dürfen sowohl der Code als auch die generierten Audiodateien in kommerziellen Projekten eingesetzt werden. Beachten Sie jedoch stets die individuellen Bestimmungen externer Streaming-Plattformen bezüglich KI-generierter Inhalte.
Wie viel VRAM benötigt ACE-Step 1.5 auf der Grafikkarte?
Im Test auf der RTX 4090 lag der gemessene Speicherbedarf zwischen 10,7 und 20,0 GB VRAM, beeinflusst durch parallel gecachte Modelle in ComfyUI. Die Entwickler geben an, dass das 2B-Turbomodell mit Quantisierung (int8) und CPU-Offloading bereits ab 6 GB VRAM lauffähig ist. Für das XL-Modell ohne Offloading werden 20 bis 24 GB VRAM vorausgesetzt.
Was unterscheidet die Versionen Turbo, Base und SFT?
Die Turbo-Variante ist auf maximale Generierungsgeschwindigkeit ausgelegt und arbeitet mit lediglich 8 Inferenzschritten, wodurch ein zweiminütiger Track in wenigen Sekunden fertiggestellt wird. Die Versionen Base und SFT nutzen standardmäßig 50 Schritte für eine potenziell feinere Audioauflösung bei entsprechend längerer Rechenzeit. SFT wurde zusätzlich gezielt auf Audioqualität hin feinabgestimmt.
Funktioniert ACE-Step 1.5 auch ohne Nvidia-Grafikkarte?
Laut dem offiziellen Repository unterstützt das Paket neben Nvidia CUDA auch Apple Silicon (MPS), AMD (ROCm) sowie Intel (XPU). Zudem existiert ein Offloading-Modus für den System-Arbeitsspeicher bei schwächeren Systemen. Die Ausführung auf reiner CPU ist technisch möglich, verlängert die Rechenzeit jedoch erheblich.
Wie formatiert man Prompts und Songtexte am besten?
Songtexte sollten in klare Abschnitte wie [verse] und [chorus] unterteilt werden, idealerweise mit kurzen Zeilen und ähnlicher Silbenzahl. Ungewöhnliche Konsonantenanhäufungen und seltene Eigennamen sollten sparsam verwendet werden, da diese bei der Sprachsynthese am ehesten zu Aussprachefehlern führen.
Quellen
- ACE-Step 1.5 auf GitHub (MIT-Lizenz)
- ACE-Step/Ace-Step1.5 Modellkarte auf Hugging Face
- Comfy-Org/ace_step_1.5_ComfyUI_files auf Hugging Face
- m-a-p/YuE2-3B auf Hugging Face (CC BY-NC 4.0)
- MiniMaxAI/MiniMax-Music3 Lizenzdatei auf Hugging Face
- DiffRhythm 2 auf GitHub (Apache 2.0)
- Eigene Messungen auf RTX 4090, Windows 11, ComfyUI 0.41, Transkription via Whisper large-v3, Stand: 17. Oktober 2026.
Geprüft am 17. Oktober 2026.
More on this from WISSNOX