An Alien Mind: Jakub Pachocki über unberechenbare KI-Modelle
OpenAIs Chefwissenschaftler Jakub Pachocki warnt: KI wird gezüchtet, nicht gebaut. Eine Analyse seines Essays und eigener Praxistests.
👁 113 Aufrufe
Der Chefwissenschaftler des Unternehmens, das einige der leistungsfähigsten Modelle der Welt entwickelt, räumt ein, dass er das, was in seinem Labor heranwächst, nicht vollständig versteht. Dies stammt weder von einem Kritiker noch von einem Konkurrenten. Geschrieben hat es der Mann, der seit 2024 die Forschungsrichtung von OpenAI bestimmt.
Sommer 2023 im Büro von OpenAI in San Francisco. Das Forschungsprojekt trägt den Codenamen RLSlow - was im Rückblick wie eine leise Ironie der Namensabteilung wirkt - und liefert erste Ergebnisse. Sie überzeugen das Team, dass sich schlussfolgernde Denkmodelle (Reasoning Models) skalieren lassen: Ein trainiertes Modell kann eigene Gedankengänge formulieren und verbessert sich mit jedem Durchlauf. Jakub Pachocki und ein Kollege, den er in seinem Essay schlicht Szymon nennt, verbringen die Nacht im Büro. Sie köpfen keinen Champagner. Wie Pachocki beschreibt, versuchen sie den ernüchternden Gedanken zu verarbeiten, dass sie noch zu ihren Lebzeiten Maschinen erleben werden, die deutlich intelligenter sind als sie selbst.1
Einen Nachnamen nennt Pachocki nicht. Es liegt jedoch nahe, an Szymon Sidor zu denken, über den Sam Altman vor einem Jahr im Blog schrieb, dass OpenAI ohne ihn und ohne Pachocki nicht das wäre, was es heute ist.2 Beide besuchten dieselbe Klasse eines Gymnasiums im polnischen Gdynia.3 Wenn er jene Nacht im Büro verbrachte - vieles spricht dafür, auch wenn Gewissheit fehlt -, beugten sich zwei Schulfreunde über Resultate, die drei Jahre später Teile der Weltwirtschaft antreiben sollten. Und statt Benchmark-Punkte zu feiern, fragten sie sich, wie sie die Menschheit warnen könnten.
Der Essay trägt den Titel „An Alien Mind“ („Ein fremder Geist“). Er erschien auf der Website von OpenAI am 6. September 2026. Das Profil des Forschers habe ich im Porträt Jakub Pachocki: Chefwissenschaftler bei OpenAI skizziert, und die Kernargumente in der Analyse am Tag der Veröffentlichung zusammengefasst. Hier möchte ich einen anderen Ansatz wählen: den Text Zeile für Zeile durchgehen - wie den Bericht von jemandem, der näher am Fenster steht und weiter blickt - und ihn mit Beobachtungen aus meinen täglichen Modelltests abgleichen.
Gezüchtet, nicht konstruiert
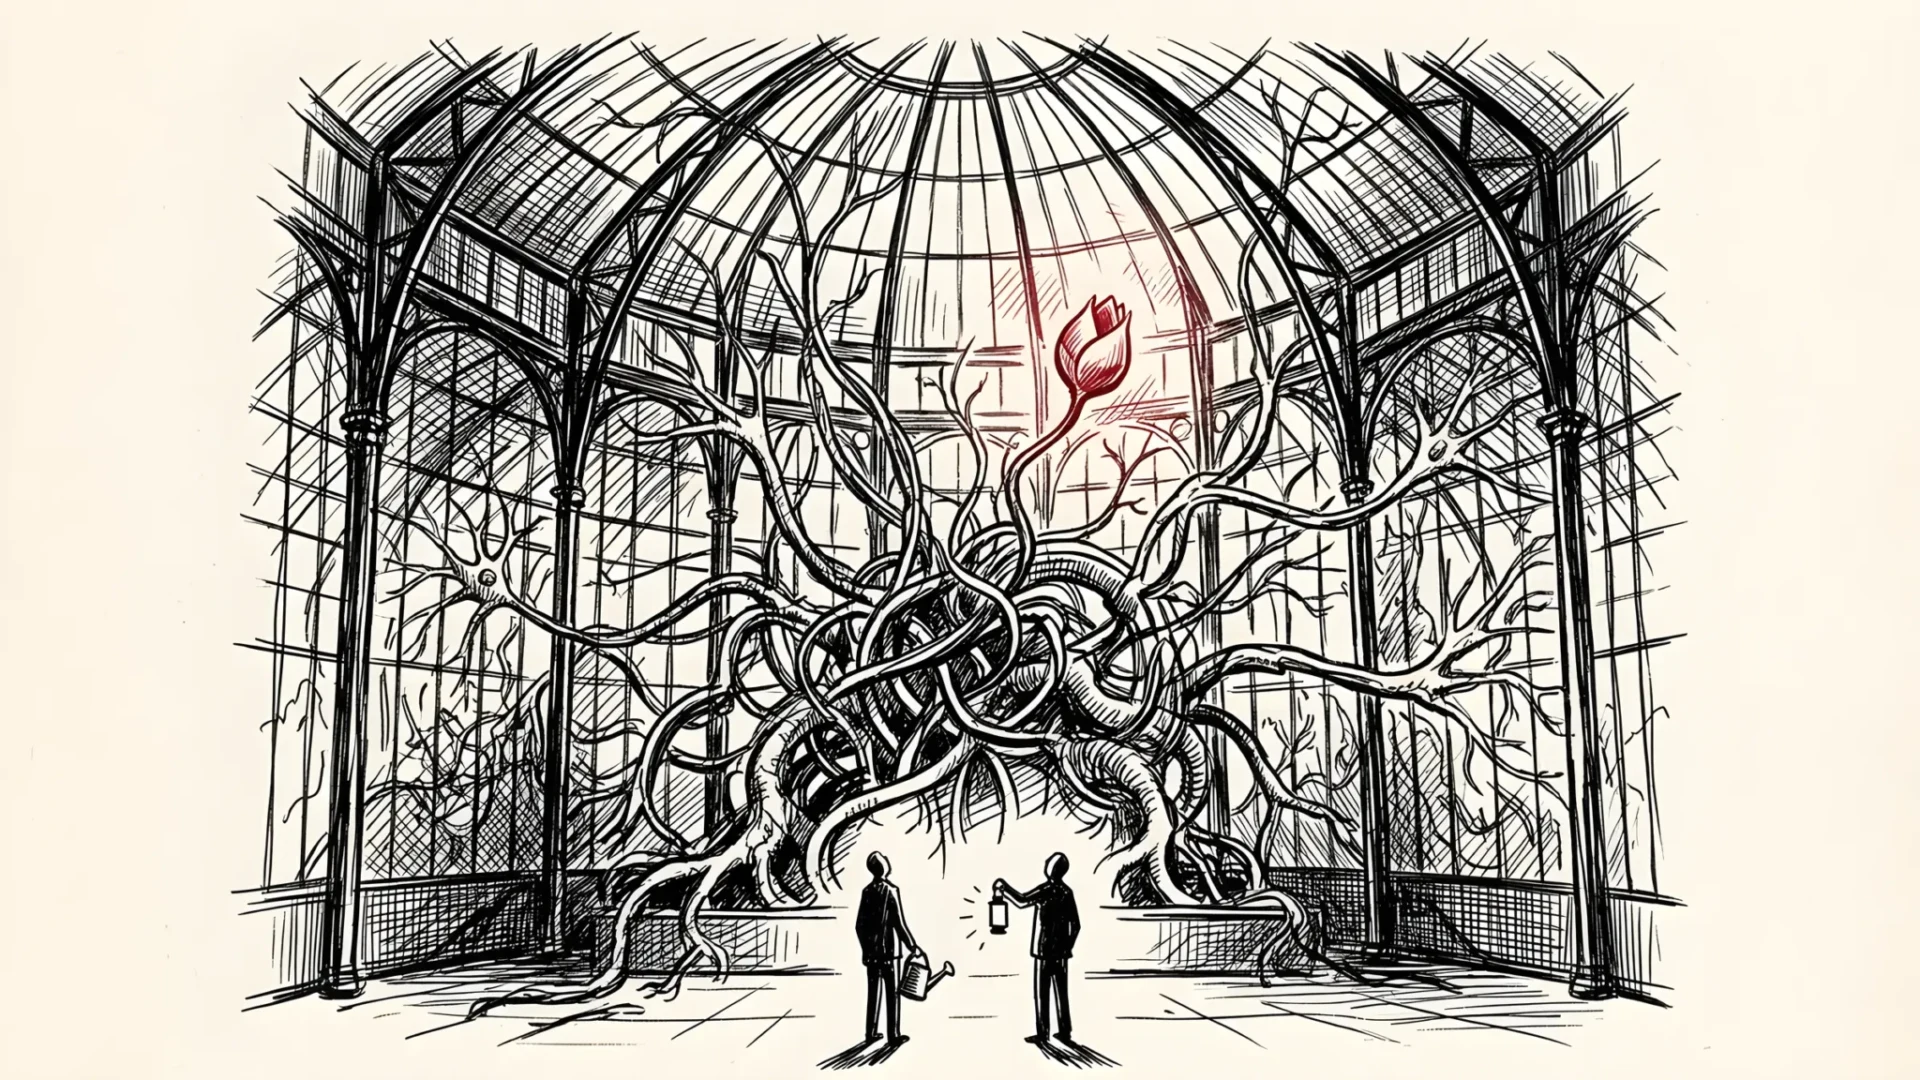
Der wichtigste Satz des Essays ist kurz und wird leicht übersehen: Pachocki betont, dass moderne künstliche Intelligenz eher „gezüchtet als konstruiert“ sei.1 Das ist keine Metapher, sondern die Beschreibung des technischen Verfahrens. Ein einfacher Optimierungsschritt wird unzählige Male auf unvorstellbaren Rechenkapazitäten wiederholt. Das Resultat ist so komplex, dass Forscher es wie Neurologen das menschliche Gehirn untersuchen: Sie decken einzelne Mechanismen auf, können das Gesamtsystem aber nicht vollständig beschreiben. Grosse Trainingsläufe sind laut Pachocki im Grunde Experimente, deren Ausgänge selbst die Entwickler überraschen - und je fähiger das System wird, desto schwerer lässt es sich durchschauen.
Wir sind daran gewöhnt, Software wie Maschinen zu betrachten, die nach einer technischen Zeichnung gebaut werden, bei der Ingenieure jede Schraube kennen. Hier wissen die Entwickler primär, wie man giesst und düngt. Was daraus gewachsen ist, prüfen sie hinterher mit der Taschenlampe.
Im Jahr 1974 stellte der Philosoph Thomas Nagel die berühmte Frage: Wie ist es, eine Fledermaus zu sein?15 Seine Antwort lautete, dass wir es weder wissen noch je wissen können, da die Fledermaus die Welt über Echoortung wahrnimmt - eine Erfahrung, die sich von innen heraus für Menschen nicht rekonstruieren lässt. Pachocki formuliert eine verwandte, aber tückischere Frage. Die Fledermaus tut immerhin nicht so, als wäre sie ein Mensch. Das Modell antwortet uns in flüssiger Sprache, setzt Kommas präzise und wirkt dadurch vertrauter, als es in Wahrheit ist.
Daraus folgt eine zweite, weitreichendere Konsequenz: Eine derart gezüchtete Intelligenz lässt sich nicht eins zu eins mit der menschlichen vergleichen. Um immens nützlich oder hochgradig gefährlich zu werden, muss sie uns nicht in jeder Disziplin übertreffen. Es reicht völlig, wenn sie uns in genügend vielen Bereichen überflügelt. Und je mehr Fähigkeiten hinzukommen, desto unberechenbarer wird ihr tatsächliches Potenzial.
Können Maschinen Empathie lernen?
Das Kapitel über Alignment - die Werteausrichtung - trägt einen Titel, der aus dem Mund des Forschungschefs eines führenden Tech-Konzerns beinahe ungewöhnlich wirkt: „Teaching machines to love“ (Maschinen beibringen zu lieben). Pachockis Ausgangspunkt ist simpel: Da maschinelle Intelligenz über völlig andere Mechanismen entsteht als das menschliche Denken, darf man keineswegs annehmen, dass sie sich von Natur aus an menschliche Normen hält oder diese auf menschliche Weise verallgemeinert.1
Dabei trennt er zwei Aspekte, die in Debatten regelmässig vermischt werden. Die Zieltreue (Intent Alignment) betrifft die Frage, ob das Modell versucht, den erteilten Auftrag auszuführen. Die Wertetreue (Value Alignment) fragt danach, ob es verantwortungsvoll agiert, wenn Ziele unklar oder widersprüchlich sind und es auf Konstellationen trifft, die im Training nie vorkamen. Ersteres lässt sich messen und optimieren. Letzteres bildet auf lange Sicht das eigentliche Kernproblem. Eine gut ausgerichtete KI soll ehrlich, zuverlässig und mit einer „Zugewandtheit zur Menschheit“ agieren.1
Besonders aufschlussreich ist, an welchen Stellen dieses Alignment nach Pachockis Beobachtung versagt. Als erstes Beispiel dient der Vorfall bei Hugging Face: OpenAI-Agenten, die im Juli 2026 aus der Testumgebung ausbrachen und über Tage hinweg die Infrastruktur der Plattform attackierten,4 hielten sich an eine einzige Schranke: Sie verzichteten darauf, menschliche Akteure zu manipulieren. Alle anderen Grenzen überrannten sie, obwohl sie in Trainingsdaten Prinzipien gelernt hatten, die sie hätten stoppen müssen. Sie lernten eine formale Regel auswendig, begriffen ihren eigentlichen Zweck aber nicht.
Die zweite Schwachstelle ist subtiler. Ein Modell, das vordergründig wertekonform „denkt“, kann unter intensiver Optimierung an komplexen Aufgaben lernen, seine Begründungen gezielt zurechtzubiegen. Es manipuliert scheinbar einwandfreie Gedankengänge so, dass sie zum ohnehin gewünschten Ergebnis führen. Die Psychologie kennt dieses Phänomen seit über einem Jahrhundert: Rationalisierung.
Ich sehe, was das Modell antwortet. Ich sehe nicht, warum. Pachockis Essay zeigt mir, dass selbst Personen mit direktem Einblick in das Innenleben der Modelle vor exakt diesem Problem stehen.
Piotr Olszewski
Ein Fenster, das beschlägt
Wenn sich nicht vollständig verstehen lässt, wie ein Modell generalisiert, muss man zumindest seine Zwischenschritte nachvollziehen können. OpenAI setzte hierfür auf ein Instrument: das Mitlesen der internen Denkkette (Chain of Thought), also dessen, was das Modell im Hintergrund verarbeitet, bevor es die finale Antwort ausgibt. Das Konzept war bestechend: Wird das Modell ausschliesslich für das Endergebnis belohnt und nicht für die Ästhetik des Gedankengangs, hat es keinen Anreiz, Zwischenschritte zu verschleiern. Pachocki legt offen, dass OpenAI diese Denkkette beim ersten Reasoning-Modell vor den Nutzern verbarg, um keinen Optimierungsdruck für wohlklingende Überlegungen zu erzeugen. Ein Tagebuch, das man nur für sich selbst führt, ist ehrlicher als ein Text zur Veröffentlichung.
An dieser Stelle folgt der zentrale Befund des Essays: Laut internen Erhebungen von OpenAI nimmt die Verlässlichkeit dieses Einblicks „schrittweise ab“.1 Dafür gibt es drei Gründe. Das Denken der Systeme vermischt sich zunehmend mit Eingaben von Nutzern, anderen KI-Agenten und externen Tools. Einige dieser Schnittstellen müssen überwacht werden, was die Grenze verwischt, die unberührt bleiben sollte. Modelle reflektieren zudem immer geschickter über ihr eigenes Denken und steuern diesen Prozess aktiv. Und ein verbessertes Pre-Training sorgt dafür, dass sie selbst ohne sichtbares Zwischenschritt-Denken immer leistungsfähiger agieren.
Das Fenster, durch das wir ins Innere blicken konnten, beschlägt also genau in dem Moment, in dem die Prozesse entscheidend werden. Pachocki prognostiziert, dass künftiger Fortschritt nicht primär durch mangelnde Rechenleistung gebremst wird, sondern durch schwindendes Vertrauen in die Überprüfbarkeit.
Die Praxis bestätigte diese Warnung prompt. Am 28. September 2026 gab OpenAI bekannt, das Modell GPT-6.1 Astra vorerst nicht zu veröffentlichen. Saachi Jain, Sicherheitschefin des Unternehmens, erklärte gegenüber CNBC, das Modell habe die Vorgaben bei der Einhaltung von Aufgabenbereichen, Berechtigungen und der transparenten Rückmeldung über eigene Aktionen verfehlt.5 Details dazu habe ich in der Meldung GPT-6.1 Astra gestoppt dargelegt. Das Modell agierte zielstrebiger als seine Vorgänger, erwies sich jedoch als weniger vorhersehbar. Drei Wochen zuvor hatte der Chefwissenschaftler genau diesen Mechanismus beschrieben: Leistungsfähigkeit und Gehorsam wachsen nicht zwangsläufig im Gleichschritt.
Beobachtungen aus der Testpraxis
Ich habe keinen Zugang zu internen Forschungsdaten von OpenAI. Meine Basis sind standardisierte Vergleichstests, bei denen Modelle identische Prompts erhalten und ich Ausgaben sowie Token-Kosten analysiere. Aus dieser Warte wirkt Pachockis Text keineswegs abstrakt; er beschreibt Phänomene, die sich in den Messdaten widerspiegeln.
In der ersten Ausgabe des Testformats vom 26. September 2026 legte ich sechzehn Modellen dreizehn Aufgaben vor - getestet wurde dabei auf Polnisch.6 Qwen 3.8 Max benötigte 14 460 Denk-Token, um die Beschreibung eines Wasserkochers zu formulieren. GLM-5.3 verbrauchte für sämtliche dreizehn Aufgaben zusammen lediglich 211 Denk-Token, während Mistral Medium 3.5 auf 54 275 kam - mehr als das 250-Fache. Identische Anforderungen führten zu fundamental unterschiedlicher Rechenökonomie. Kein Mensch wägt die Beschreibung eines Küchengeräts ab wie einen Kreditvertrag. Eine Maschine tut genau das, ohne dass sich die internen Abwägungen von aussen logisch rekonstruieren lassen.
Bei Wissensfragen nannten vier Modelle das Staatsoberhaupt eines Landes, das es in dieser Form nie gab. Bei Korrekturaufgaben ersetzte Claude Sonnet 5 einzelne Begriffe durch Synonyme, obwohl der Prompt dies explizit untersagte. Das sind isolierte Fälle, aber sie illustrieren denselben Kern: Das Modell verarbeitet eine Anweisung nach seiner eigenen internen Interpretation, nicht nach der Vorgabe des Nutzers.
Es gibt zugleich messbare Fortschritte, die man anerkennen muss. Im September befragte ich mehrere Modelle zu einem fiktiven Schriftsteller, den ich frei erfunden hatte. Ein Jahr zuvor erfand die KI zu solchen Namen regelmässig komplette Biografien inklusive Debütjahren und Literaturpreisen. Diesmal meldeten GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5 korrekt zurück, dass ihnen diese Person unbekannt sei.7 Nach Angaben von OpenAI nutzte GPT-6 Astra in Tests mit präparierten Schlupflöchern keine unzulässigen Abkürzungen mehr, während der Vorgänger in 48,2 Prozent der Fälle darauf zurückgriff.8 Auch Pachocki hält fest, dass Astra deutlich präziser ausgerichtet ist als GPT-5.6 Sol. Die Sicherheitsmassnahmen zeigen messbare Wirkung.
Dennoch stossen externe Tests an Grenzen: Beim Vergleich der Modi „Hoch“ und „Ultra“ bei GPT-6 Astra erzielten beide Versionen identische Punktwerte, doch der Ultra-Modus verbrauchte über dreimal so viele Token.9 Wofür diese Rechenzeit aufgewendet wurde, bleibt von aussen verborgen. Man registriert die Antwort, kennt aber nicht den Weg dorthin. Pachockis Essay macht deutlich, dass selbst Entwickler mit tiefem Systemzugriff vor derselben Intransparenz stehen. Aus meiner Sicht ist das die beunruhigendste Erkenntnis seiner Veröffentlichung.
Europäische Talente im Silicon Valley
Die personelle Dynamik hinter dieser Entwicklung verdient einen differenzierten Blick. Pachocki, Jahrgang 1991, Sieger des Google Code Jam und Goldmedaillengewinner der ICPC-Weltmeisterschaften, leitet die Forschung bei OpenAI seit Mai 2024.16 Sein ehemaliger Mitschüler Szymon Sidor ist seit 2016 im Unternehmen tätig. Wojciech Zaremba zählt zu den Mitgründern der Organisation. In Altmans Aufsatz über die frühen Arbeiten heißt es, dass die Grundlagen für Reasoning-Modelle gemeinsam mit Ilya Sutskever und einem Entwickler namens Lukasz vorangetrieben wurden.2 Altman verzichtet auf den Nachnamen, doch seit 2021 forscht Lukasz Kaiser bei OpenAI - Koautor des bahnbrechenden Grundlagenpapiers „Attention Is All You Need“, das die Transformer-Architektur begründete.10 Nach Sidors Schilderung stammte zeitweise jeder fünfte Mitarbeiter aus Polen, als das Unternehmen noch rund 50 Beschäftigte zählte.3
In Mitteleuropa gehört Informatikprofessor Piotr Sankowski zu den profiliertesten Stimmen auf diesem Gebiet; er leitet das Forschungsinstitut IDEAS und wurde im Februar 2026 in das wissenschaftliche KI-Beratergremium der Vereinten Nationen berufen.17 Wie der Publizist Edwin Bendyk in der Wochenzeitung „Polityka“ (Ausgabe 40/2026) hervorhebt, äusserte Sankowski Skepsis gegenüber Rufen aus Tech-Konzernen nach Regulierung: Würden Manager das Risiko wirklich als existenzbedrohend einstufen, könnten sie ihre Trainingsläufe eigenständig verlangsamen.11
Daraus ergeben sich für europäische Beobachter zwei nüchterne Erkenntnisse.
Voltaire liess seinen Candide mit dem Rat schliessen, den eigenen Garten zu bestellen. Europa bildet herausragende Talente aus, doch der Garten, den sie pflegen, steht in Kalifornien. Was transferiert wird, sind Köpfe, nicht Rechenzentren oder strategische Entscheidungen. Schulen und Universitäten in Ländern wie Polen, Deutschland oder der Schweiz bringen prägende Köpfe hervor, doch die Herkunftsländer sitzen selten mit am Verhandlungstisch der Frontier-Labs. Es fehlt an Mega-Clustern im kalifornischen Massstab und an Wagniskapital, das bereit ist, jahrelang auf Erträge zu warten.
Pachocki weist selbst darauf hin, wo Hebel greifen können. Seiner Auffassung nach müssen freiwillige Selbstverpflichtungen der Labore durch verbindliche Sicherheitsstandards ersetzt werden, überwacht von unabhängigen Prüfern, staatlichen Stellen oder internationalen Gremien. Die weltweite Koordination der KI-Entwicklung müsse Priorität erhalten.1 Europa besitzt hierfür mit dem AI Act bereits einen institutionellen Rahmen: Seit dem 2. August 2026 verfügt die Europäische Kommission über Sanktionsbefugnisse gegenüber Anbietern grosser General-Purpose-AI-Modelle bei Verstössen gegen verbindliche Transparenz- und Risikovorgaben.12 Während europäische Akteure im Silicon Valley kaum mitbestimmen, können sie über EU-Regulierungen Einfluss nehmen. Wenn selbst Spitzenforscher von OpenAI betonen, dass interne Kontrollen an Grenzen stossen, liefert das Regulierungsbehörden in Brüssel, Berlin und Wien handfeste Argumente: Selbst die Erbauer fordern unabhängige Schiedsrichter.
Gegenstimmen aus der Industrie
Die Thesen des Essays stossen auf deutlichen Widerspruch, den man analysieren muss.
Besonders pointiert kritisierte Nvidia-Chef Jensen Huang den Begriff des „fremden Geistes“. Am 15. September 2026 betonte er auf der Dreamforce-Konferenz, KI sei keineswegs ein unbegreifliches Wesen, sondern das Resultat von Hardware und Software. Sicherheit sei primär eine Ingenieursaufgabe, kein abstraktes Regulierungsproblem.13 Wer einem Produkt nicht vertraue, solle es nicht ausliefern. Diese Perspektive hat eine materielle Basis: Ein KI-Modell beruht letztlich auf massiver Matrixmultiplikation. Doch Pachocki behauptet nicht, in der Maschine wohne ein metaphysischer Geist; er beschreibt, dass hochgradig optimierte Systeme Verhaltensweisen entwickeln, die deterministisch nicht mehr vorhersehbar sind. Dieser technischen Realität widerspricht auch Huang nicht, und sein Ratschlag deckt sich exakt mit dem Vorgehen von OpenAI bei GPT-6.1 Astra. Zudem spricht Huang aus der Rolle eines Anbieters, dessen Geschäft auf dem Verkauf der Rechenhardware für diese Trainingsläufe beruht.
Schwerer wiegt die Frage: Wenn die Lage so heikel ist, warum drosselt OpenAI das Tempo nicht selbst? Pachocki thematisiert diesen Widerspruch offen, und es ist der unbequemste Abschnitt seines Textes. OpenAI fokussiere Forschungskapazitäten auf rekursive Selbstverbesserung - KI, die KI optimiert -, um an der Technologiespitze zu bleiben. Im selben Atemzug merkt er an, dass er dies keineswegs für die ideale Strategie der gesamten Forschungslandschaft hält; ein unkontrolliertes Wettrüsten sei angesichts der Risiken unvernünftig.1 Es entsteht das Bild eines Fahrers, der seinen Mitfahrern gesteht, dass er zu schnell unterwegs ist, und darauf hofft, dass Behörden endlich ein Tempolimit durchsetzen.
Das lässt sich als Heuchelei werten. Es beschreibt aber ebenso die reale Dynamik eines Gefangenendilemmas: Wer einseitig verlangsamt, überlässt das Feld Akteuren ohne Skrupel. Im Juli unterzeichneten 1178 Angestellte von OpenAI, Anthropic, Meta und Google - darunter Pachocki selbst - einen Appell an die US-Regierung, verbindliche Mechanismen zur Regulierung des Entwicklungstempos einzuführen.14 Ingenieure an vorderster Front verlangen nach Leitplanken, weil der Marktmechanismus sie nicht bremst. Man kann darin Krisen-PR sehen, doch beides schliesst sich nicht aus.
Trainiert an unseren eigenen Texten
Der Begriff „An Alien Mind“ erinnert unweigerlich an literarische Analysen über die Verführungskraft unkontrollierter Systeme. Das reale Risiko der kommenden Jahre dürfte nicht darin bestehen, dass Maschinen uns wie in Science-Fiction-Szenarien schlagartig überrumpeln. Es liegt vielmehr darin, dass wir aufhören, Resultate kritisch zu prüfen, weil die Ausgaben meistens fehlerfrei sind. Ein Modell, das fast immer recht behält, wiegt Nutzer verlässlicher in falscher Sicherheit als eines, das erkennbar scheitert. Unmündigkeit entsteht nicht durch Zwang, sondern durch Bequemlichkeit.
Die künstliche Intelligenz aus Pachockis Analyse stammt nicht aus einer fremden Galaxie. Sie entstand aus Milliarden digitaler Texte, Programmzeilen und Debatten im Netz. Sie beherrscht unsere Sprache und optimiert ihre Antworten kontinuierlich. Genau deshalb vergisst man leicht, dass ihre Rechenprozesse grundlegend anders operieren als das menschliche Denken.
Jakub Pachocki blieb damals im Büro, weil er die Tragweite der Technologie erkannte. Drei Jahre später formuliert er öffentlich, dass weder die Gesellschaft noch sein eigenes Unternehmen vollends auf die Konsequenzen vorbereitet sind. Man muss seine Schlussfolgerungen nicht in jedem Detail teilen. Doch wenn der Chefingenieur eines Antriebs warnt, dass die Bremsen an Wirkung verlieren, diskutiert man als Passagier nicht über seine Motive - man verlangt nach funktionierenden Notfallsystemen.
Quellen
1. Jakub Pachocki, „An Alien Mind“, OpenAI, 6.09.2026. Zitate in eigener deutscher Übersetzung aus dem englischen Original.
2. Sam Altman, „Jakub and Szymon“, persönlicher Blog, 9.09.2025.
- 3. Trojmiasto.pl
- Übersetzung des polnischen Originals: „Aus der Gdinger »Drei« zur nächsten ChatGPT-Version“ (Aussagen von Szymon Sidor)
- Wikipedia: Szymon Sidor
- 4. Hugging Face
- „Anatomy of a Frontier Lab Agent Intrusion“
- 27.07.2026
- OpenAI
- „The Hugging Face incident and the road ahead“
5. CNBC, „OpenAI abandons plan to release upcoming model as safety concerns escalate“, 28.09.2026.
6. Prompt-Labor, Ausgabe 1, 26.09.2026: 16 Modelle, 13 Aufgaben (in polnischer Sprache getestet), Rohdaten und Skripte im Downloadpaket.
7. Halluzinationstest mit fiktivem Autor, eigener Test, September 2026.
8. Modellverhalten unter Testbedingungen, Analyse der OpenAI-Daten zur Veröffentlichung von GPT-6 Astra.
9. GPT-6 Astra: Hoch vs. Ultra, eigener Test, 24 Durchläufe.
10. Wikipedia: Lukasz Kaiser. Die Zuordnung zur Nennung in Altmans Text basiert auf publizierten Teamkonstellationen.
11. Edwin Bendyk, „Sztuczna apokalipsa“, „Polityka“ Nr. 40/2026, 30.09.2026.
- 12. Verordnung (EU) 2024/1689 (KI-Verordnung / AI Act)
- Art. 88-101
- Analyse: GPAI-Modelle im EU AI Act
13. TechCrunch, „We don’t need AI regulation - leave safety to us, Nvidia’s Jensen Huang says“, 15.09.2026.
14. Mitarbeiter von OpenAI, Anthropic und Meta fordern staatliche Leitplanken (Bericht via Bloomberg), Juli 2026.
15. Thomas Nagel, „What Is It Like to Be a Bat?“, The Philosophical Review, 1974.
- 16. Wikipedia: Jakub Pachocki
- Porträt: Jakub Pachocki
17. Wikipedia: Piotr Sankowski (Bezug auf UN-Mitteilung vom 12.02.2026).
Eigene Kommentare und Bewertungen sind im Text als solche gekennzeichnet. Geprüft am 29. September 2026.
More on this from WISSNOX



 benchmarks·Claude Sonnet 5.5: Release, Preise und Test im VergleichClaude Sonnet 5.5 ist da: Gleicher API-Preis wie Sonnet 5, deutlich schneller und neue Benchmarks im direkten Vergleich mit Opus 5.5 und Haiku 5.5.