Model Collapse: Wenn KI die Realität verlernt und das Seltene verschwindet
Trainiert sich künstliche Intelligenz allein mit den eigenen Ergebnissen, verliert sie zunehmend den Kontakt zur Wirklichkeit. Warum menschliche Kreativität plötzlich zur technischen Notwendigkeit wird.
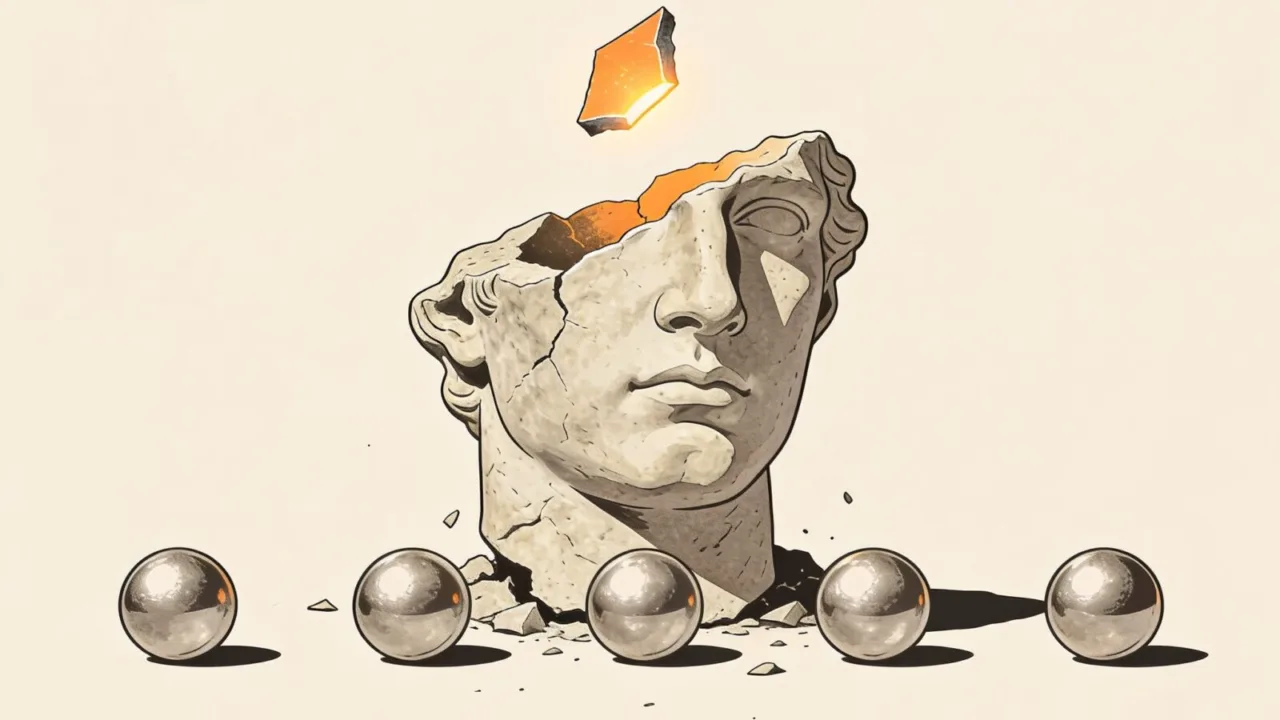
Zwei Wörter in einem aktuellen Fachartikel genügten, um eine tiefgreifende Verunsicherung auszulösen: „misperceive reality“. Sie stammen aus der Beschreibung eines Prozesses, den Forscher der Universitäten Oxford und Cambridge als Model Collapse bezeichnen. Gemeint ist kein gelegentlicher Fehler, keine Halluzination, bei der ein Sprachmodell eine falsche Jahreszahl erfindet, sondern ein schleichender, systemischer Verlust des Realitätsbezugs - ausgelöst durch eine Trainingspraxis, die sich zunehmend auf die eigenen, synthetischen Outputs stützt. Was nach einem technischen Detail klingt, hat das Potenzial, die Leistungsfähigkeit ganzer KI-Generationen zu untergraben.
In der aktuellen, viel beachteten Arbeit warnen die Autoren, dass sich der Effekt über mehrere Iterationen hinweg verstärkt. Jede Modellgeneration, die mit den Ergebnissen ihres Vorgängers trainiert wird, büßt ein Stück jener Vielfalt ein, die die ursprünglichen, von Menschen geschaffenen Daten ausgezeichnet hatte. Die Verluste treten zuerst an den Rändern auf, in den sogenannten Schwänzen der Verteilung. Dort schlummern seltene, ungewöhnliche Muster, die nicht häufig genug vorkommen, um im statistischen Mittel Gewicht zu behalten. Gerade sie aber sorgen für Überraschung, Kreativität und epistemischen Reichtum.
„Die Modelle verlieren zuerst die seltensten, ungewöhnlichsten Teile der Originaldaten. Übrig bleibt das Gewöhnliche, das Erwartete - und genau darauf trainiert die nächste Generation“, heißt es in der Studie.
Die Schwänze der Verteilung: Wo die Erneuerung beginnt
Dass ausgerechnet die Ränder verschwinden, ist kein unbedeutender Kollateralschaden. Newton war ein Schwanz der Verteilung. Einstein ebenfalls. Jeder große intellektuelle Durchbruch beginnt als Ausreißer, als eine Beobachtung oder ein Gedanke, der so weit vom Durchschnitt entfernt liegt, dass ihn kein Optimierungsverfahren gezielt hervorgebracht hätte. Die Schwänze sind nicht nur statistische Kuriositäten; sie sind der Ursprungsort neuer Verteilungen. Wenn eine KI den Kontakt zu diesen Regionen verliert, verliert sie nicht nur etwas Seltenes, sondern den Mechanismus, der künftige Informationen überhaupt erst entstehen lässt.
Die Forschergruppe illustriert den Kollaps anhand verschiedener Modelltypen und stellte konsistent fest: Sobald die Trainingsdaten ausschließlich oder überwiegend aus maschinell erzeugten Inhalten bestehen, schrumpft die Varianz der Repräsentationen. Die Modelle werden zwar nicht dümmer im Sinne geringerer Sprachflüssigkeit - im Gegenteil, sie bleiben oft erstaunlich eloquent - , aber sie werden zunehmend unfähig, Reales von synthetisch Geglättetem zu unterscheiden. Sie nehmen die Welt durch eine sich verengende Linse wahr, die alles ausfiltert, was nicht schon mehrfach bestätigt wurde.
Warum menschliche Daten unersetzlich werden
Die Implikation ist radikal: Echte, von Menschen geschaffene Daten sind nicht nur kulturell wertvoll, sondern eine technische Notwendigkeit. Das Papier stellt ausdrücklich fest, dass menschlich generierte Inhalte mit fortschreitendem Modelldrift immer kostbarer werden, weil nur sie dem System jene Rohheit und Unvorhersehbarkeit zurückgeben können, die ihm durch rekursives Training abhandengekommen sind. Der Traum, KI endlos mit eigenen Erzeugnissen zu füttern und so von teuren, aufwändig kuratierten menschlichen Datensätzen unabhängig zu werden, zerbricht an dieser Erkenntnis.
Das ist eine beunruhigende Wende. Jahrelang drehte sich die Debatte um die Frage, ob menschliches Denken gegenüber einer vermeintlich überlegenen Künstlichen Intelligenz bestehen kann. Nun kehrt sich die Fragestellung um: Kann KI überleben, wenn das menschliche Denken allmählich aus den Trainingsdaten verschwindet? Die Antwort der Studie lautet: Nein, jedenfalls nicht in einer Form, die noch Realitätssinn besitzt. Es entsteht eine fatale Abhängigkeit: Je mehr synthetische Daten kursieren, desto dünner wird der Boden, auf dem die Modelle stehen, und desto mehr sind wir gezwungen, menschliche „Rohdaten“ nachzuliefern, um einen vollständigen Kollaps zu vermeiden.
Das Unwiederholbare als Ressource
Der Autor des begleitenden Artikels im Psychology Today prägt einen treffenden Begriff: das Unwiederholbare. Es ist die kognitive Signatur, die eine bestimmte Person einzigartig macht und die sich nicht auf ein statistisches Mittel reduzieren lässt. Bisher galt dieses Unwiederholbare als das, was KI niemals erzeugen kann. Die neue Studie legt nahe, dass es auch das ist, was sich KI nicht leisten kann zu verlieren. Jedes originäre Gedankenfragment, jede eigensinnige Formulierung, jede unerwartete Kombination ist ein Beitrag zum Erhalt der Datenvielfalt und damit ein Bollwerk gegen den Model Collapse.
Das klingt paradox: Ausgerechnet die fehlerbehafteten, inkonsistenten, oft irrationalen Produkte menschlicher Gehirne bewahren eine hochentwickelte KI vor dem Abgleiten in eine Art epistemische Monotonie. Genau darin liegt jedoch die Kernaussage der Forschungsarbeit. Die „Reibung“ echter menschlicher Äußerungen - ihre Unvollkommenheit, ihr kulturelles Echo, ihre individuelle Färbung - verhindert, dass Modelle in eine so homogene, glattgebügelte Realitätsblase geraten, dass sie selbst grundlegende Fakten nicht mehr von Artefakten unterscheiden können.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Ein Warnsignal, das gehört werden sollte
Was bedeutet das für den praktischen Einsatz? Schon heute trainieren viele große Modelle auf Mischungen aus menschlichen und synthetischen Daten. Die Versuchung, den Anteil letzterer zu erhöhen, ist groß - sie sind billig, in beliebiger Menge verfügbar und frei von urheberrechtlichen Fallstricken. Doch die Studie mahnt zur Vorsicht: Je höher der Anteil synthetischer Daten, desto schneller verflacht die Verteilung, desto ärmer wird die interne Weltrepräsentation. Langfristig könnte dies die Zuverlässigkeit von KI-Systemen in sicherheitskritischen Anwendungen untergraben, von der medizinischen Diagnostik bis zur juristischen Entscheidungsunterstützung.
Model Collapse ist keine ferne Dystopie, sondern ein Mechanismus, der bereits wirkt, sobald rekursive Lernschleifen nicht mehr mit frischen, menschlichen Daten durchbrochen werden. Die Forschung mahnt uns, die Herkunft und Diversität der Daten nicht als optionales Extra, sondern als essenzielle Voraussetzung für leistungsfähige und realitätstaugliche KI zu begreifen. Das Unwiederholbare, das Sperrige und das eigensinnig Menschliche sind keine Störgrößen, sondern der letzte Anker, der verhindert, dass die Maschinen den Boden unter den Füßen verlieren.
Quellen:
- Google DeepMind is worried about what happens when millions of agents start to interact (MIT Technology Review - AI)
- How Preply combines AI and human tutors to personalize learning (OpenAI Blog)
- A new method could spot fentanyl variants no one has cataloged yet (Science News)
- Water molecule unlocks faster interfacial polymerization by lowering energy barrier (Phys.org)
- New OpenAI Academy courses for the next era of work (OpenAI Blog)
- AI Isn’t Replacing Us; It’s Consuming Us (Psychology Today - Articles)
More on this from WISSNOX

 klima·Vier Tage Extremregen tilgten 7 Prozent der seltensten Menschenaffen der WeltEin einziger Zyklon hat im November 2025 in nur vier Tagen etwa 58 Tapanuli-Orang-Utans getötet.