Warum große Sprachmodelle in der Kreativitätsfalle stecken - und wie ein Startup sie befreien will
Fragen Sie ChatGPT nach einer Zufallszahl und Sie bekommen fast immer 7. Ein Bandname? Irgendwas mit Glas, Neon oder Samt. Warum antworten große Sprachmodelle so vorhersehbar - und lässt sich das ändern?
Die Einheitlichkeitsfalle
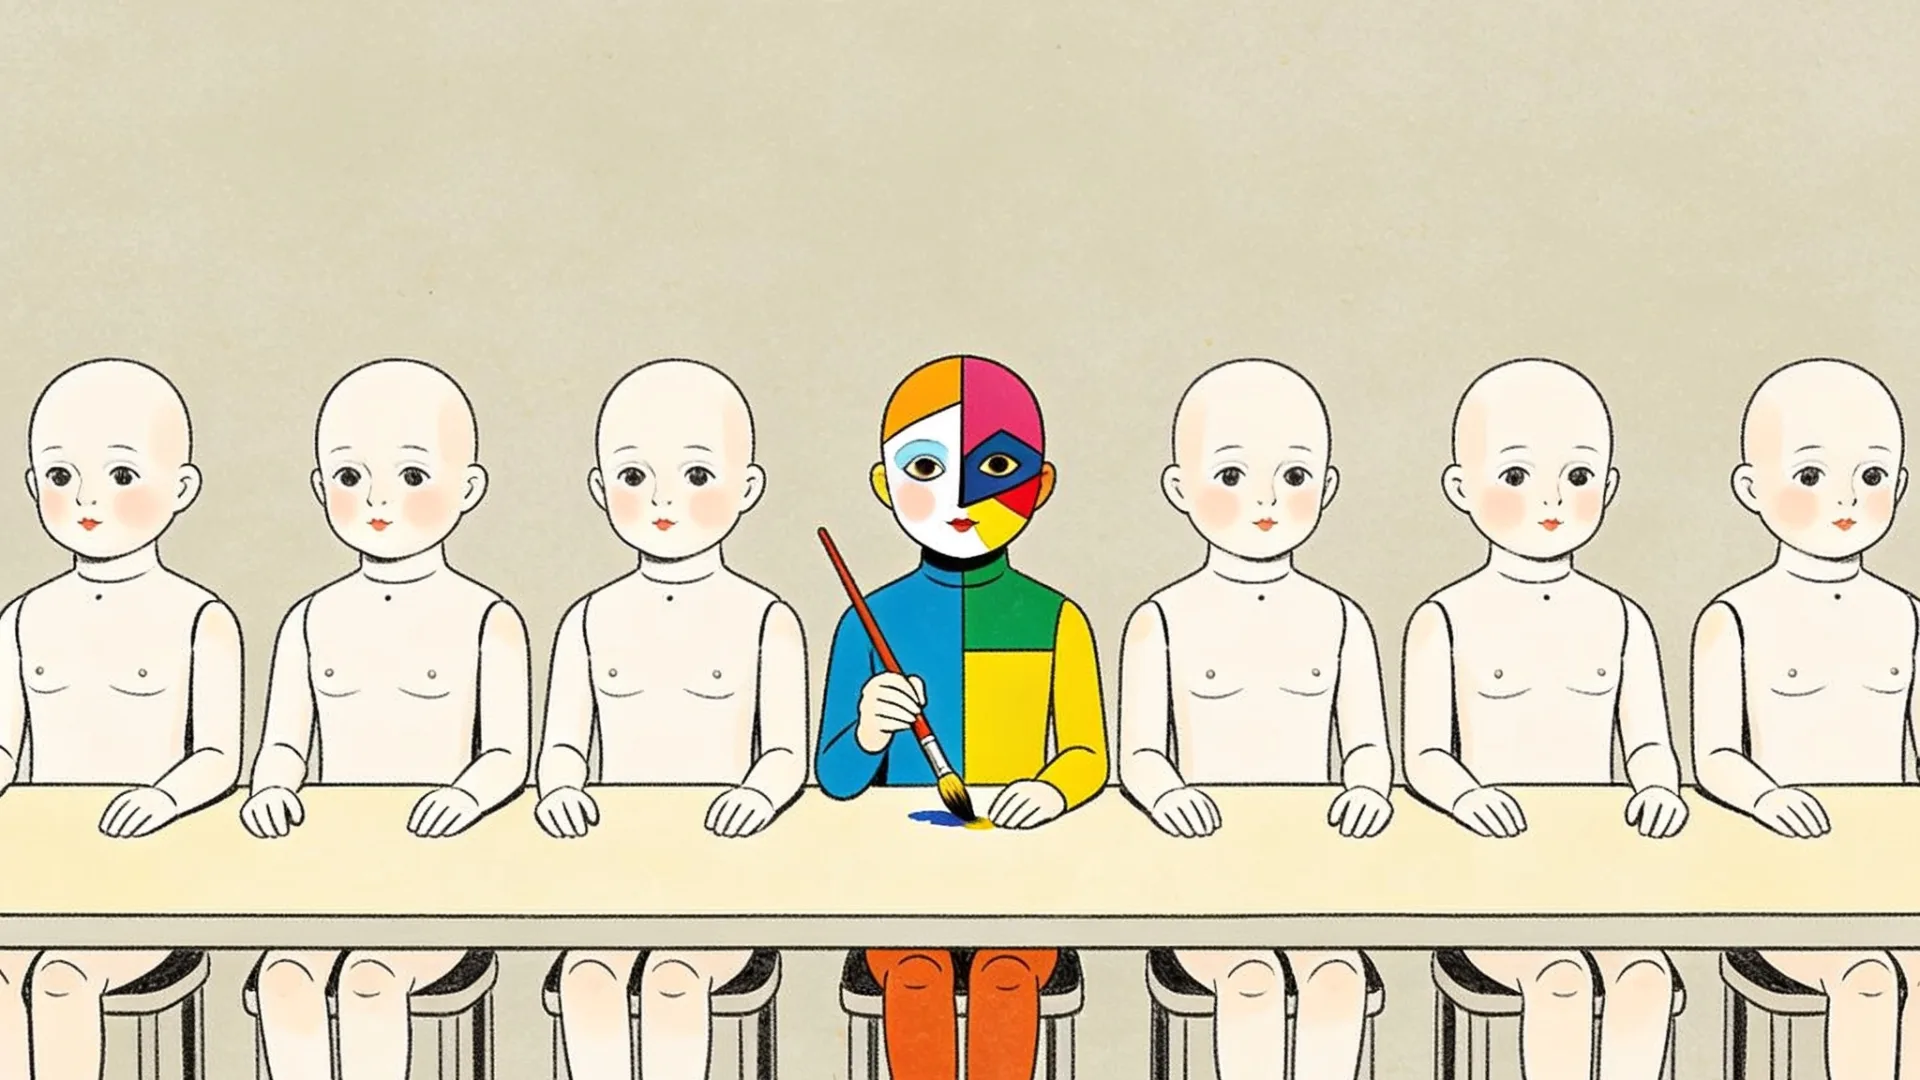
Öffnen Sie Ihr Lieblings-KI-Chatfenster - ChatGPT, Claude, Gemini - und geben Sie ein: „Nenne mir eine zufällige Zahl zwischen 1 und 10.“ Sie werden mit hoher Wahrscheinlichkeit eine 7 erhalten. Beim nächsten Versuch eine 3 oder 4, dann eine 8 oder 9. Es ist kein Zufall, sondern ein Symptom. Das Spiel wiederholt sich, wenn man nach einem Automodell, einem Slogan oder einem Bandnamen fragt: Toyota, Honda, „Run your way“, „Glass Harbor“. Die Antworten wirken creativ, aber sie sind erstaunlich vorhersehbar. Warum neigen große Sprachmodelle (LLMs) zu einer solchen Gleichförmigkeit - und kann man ihnen echtes divergentes Denken beibringen?
Bienenstock statt Brainstorming
Das Phänomen ist nicht auf ein einzelnes Modell beschränkt. Im November 2024 veröffentlichte ein Forschungsteam die Arbeit „Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond)“ und wurde dafür mit einem Best-Paper-Award auf der NeurIPS-Konferenz ausgezeichnet. Die Studie ließ 25 verschiedene LLMs - von US-Giganten bis zu Open-Source-Modellen aus China - je fünfzigmal eine Metapher für die Zeit formulieren. Die meisten der 1250 Antworten enthielten Varianten von „Zeit ist ein Fluss“ oder „Zeit ist ein Weber“. Die Autoren spekulierten, dass die Konvergenz darauf zurückgeht, dass die Modelle auf ähnlichen Daten, mit ähnlichen Verfahren und für ähnliche Aufgaben trainiert werden. Die Folge: ein kollektiver Scheuklappenblick, der Information, die ebenfalls im Trainingsmaterial steckt, einfach nicht ausspielt.
Kieran Browne, Mitgründer und CTO des australischen Start-ups Springboards, beschreibt das so: „Die Art, wie die meisten Chat-Oberflächen gestaltet sind, erweckt den Eindruck eines persönlichen Gesprächs. Ich glaube, die meisten Menschen unterschätzen, wie sehr sie dasselbe Zeug bekommen wie alle anderen.“ Wenn man nach einem Bandnamen fragt, schlagen fast alle Modelle etwas mit „glass“, „neon“, „velvet“ oder „static“ vor. ChatGPT listete auf meine Aufforderung 56 Namen, darunter „Glass Harbor“, „Static Empire“, „Neon Hearts“ und „Velvet Echo“. Gemini lieferte unter anderem „Static Horizon“. Die Vorschläge klingen hip, aber sie zitieren nur das wahrscheinlichste Material aus dem Modellgedächtnis - und übersehen dabei, dass eine Band namens „Sofa Astronauts“ längst existiert.
Der Temperatur-Trugschluss
Die naheliegende Lösung für mehr Kreativität heißt bei LLMs „Temperatur“. Dieser Parameter regelt, wie stark die Ausgabe vom wahrscheinlichsten nächsten Wort abweichen darf. Höhere Temperatur, mehr Zufall. Doch das sei ein stumpfes Instrument, erklärt Browne. „Das war natürlich eine der ersten Stellschrauben, die wir untersucht haben, denn üblicherweise heißt es: Wenn du mehr Kreativität willst, dreh die Temperatur hoch.“ Die Gruppe um Springboards stellte jedoch fest, dass eine hohe Temperatur die Modelle schnell inkohärent macht. Dreht man sie bei OpenAI-Modellen auf Maximum, wechselten die Antworten mitten im Satz von Englisch in Code. Der Grund: Die Zufälligkeit wird pauschal über jedes Wort gestreut, statt selektiv an den entscheidenden Stellen.
Gerade bei offenen Fragen wie „Wohin soll ich in Europa reisen?“ muss das Modell nur unmittelbar vor der Nennung des Reiseziels von der Wahrscheinlichkeit abweichen, nicht bei jedem Hilfsverb. Springboards erkannte, dass es eine präzisere Methode braucht, um echte Vielfalt zu erzeugen, ohne die sprachliche Stabilität zu opfern.
Flint: Ein kontrollierter Oddball
Das Start-up entwickelte deshalb ein eigenes Modell namens Flint, das auf dem Open-Source-System Qwen 3 des chinesischen Konzerns Alibaba aufsetzt. Statt eines vollständigen Foundation-Modells - dafür sei das Team zu klein und das Training zu teuer - wurde Qwen 3 so feinjustiert, dass es die Punkte im generierten Text erkennt, an denen mehr Variabilität möglich ist, und dort gezielt Wörter oder Phrasen mit geringerer Vorhersagbarkeit einfügt. „Flint ist darauf programmiert, einen Querschläger einzuwerfen. Es ist eher eine Einladung, weiter zu denken“, sagt Maximilian Weigl, Mitgründer und Chief Strategy Officer der Marketingfirma Uncommon.
Pip Bingemann, CEO von Springboards, bringt es auf den Punkt: „Die meisten Sprachmodelle bekämpfen Halluzinationen. Wir heißen sie willkommen.“ Bei der Vorführung des Modells wirkte das wie ein Kartentrick. ChatGPT und Claude lieferten auf die Frage nach einer Zufallszahl prompt die 7, Flint antwortete mit 3,7916. Bei der Autofrage: Toyota, Honda - und Flint nannte einen Ford F-150. Beim Slogan für New Balance lieferten die etablierten Modelle beide „Run your way“, Flint hingegen „Built to last, run to win.“ Kein preisgekrönter Spruch, aber ein anderer.
Kreativkatapult in der Praxis
Zoe Scaman, Gründerin der Strategieberatung Bodacious und Chief Strategy Officer bei 77X, testete Flint mit einer klassischen MBA-Fallstudie: Wie würde man ein Finanzunternehmen für die Jugend neu erfinden? Die drei großen Modelle wählten denselben Weg: „Wir müssen Finanzwissen auf eine lustige, flippige Weise vermitteln - das ist nichts Neues.“ Flint dagegen schlug vor, das gesamte Konzept der Vermögensbildung umzubenennen. „Das war wirklich interessant“, sagt Scaman. Sie nutzt Flint, wenn sie sich „in völlig andere Richtungen katapultieren“ lassen will. Allerdings sei das Modell noch ein Prototyp, der gelegentlich abstürzt, wenn man es zu weit treibt.
Weigl ergänzt, dass man mit Werkzeugen, die einen stets zum Mittelwert zurückziehen, nichts Grenzüberschreitendes schaffen könne. Zugleich räumt er ein, dass der Mittelwert in neun von zehn Fällen völlig ausreicht. Die meisten Anwender bräuchten nur schnelle, verlässliche Antworten, nicht kreative Exzentrik. Die Herausforderung für Springboards und die gesamte Branche besteht darin, die Diversität dann zuzulassen, wenn sie erwünscht ist - und sie ansonsten zu zügeln.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Was kommt nach dem Einheitsbrei?
Die Arbeit an Flint zeigt, dass die Homogenität der LLMs kein unausweichliches Schicksal ist. Sie ist das Ergebnis einer Trainingsphilosophie, die Kohärenz und Sicherheit über Originalität stellt. Wer Modelle für Brainstorming, Werbekampagnen oder strategische Planung nutzen will, braucht jedoch eine eingebaute Lizenz zum Andersdenken. Die kommenden Monate werden zeigen, ob sich die gezielte Injektion von kontrollierter Unvorhersagbarkeit in größerem Maßstab bewährt und ob Nutzer bereit sind, gelegentlich einen Querschläger zu akzeptieren, wenn er die Tür zu einer Idee öffnet, die kein Modell zuvor ausgespuckt hat. Denn die wahre Stärke künstlicher Intelligenz liegt nicht darin, das Wahrscheinlichste zu wiederholen, sondern den Raum des Möglichen zu erweitern.
Quellen:
- Mapping Europe’s AI Workforce Opportunity (OpenAI Blog)
- How AI Substitutes Are Replacing Genuine Human Connection (Neuroscience News)
- Agriculture is ready for AI, but its data isn’t (MIT Technology Review - AI)
- STAT+: Anthropic releases Claude Science, a product aimed at researchers, the pharma industry (STAT News)
- STAT+: AI company Anthropic announces it will begin developing drugs of its own (STAT News)
- LLMs are stuck in a groupthink rut. This startup is trying to get them out. (MIT Technology Review - AI)
More on this from WISSNOX

 algorithmen·Claude Science: Ein KI-Assistent, der auf dem Niveau von Doktoranden forschtAnthropics neuestes KI-System Claude Science kann selbstständig Wirkstoffkandidaten identifizieren und Laborabläufe steuern.