// meta ki-modell
Muse Wonder von Meta: Details, Preise und Benchmarks
Muse Wonder ist ein von Meta am 12. Oktober 2026 vorgestelltes Frontier-Modell für persönliche und professionelle Agentenarbeit. Es löst als Nachfolger das bisherige Muse Spark an der Spitze der Meta-Modellreihe ab. Die Serie richtet sich an Anwender, die komplexe Aufgaben mit Funktionen wie Active Memory und Active Focus bewältigen möchten.
Preise für Muse Wonder
| model | input / 1M | output / 1M | context |
|---|---|---|---|
| Muse Wonder | $4 | $20 | 1,048,576 |
Die angegebenen Tarife stammen aus einem Snapshot von OpenRouter vom 12. Oktober 2026 und können sich mit der Zeit ändern. (2026-10-12 19:54:27)
Vergleich mit anderen Modellen
| model | input / 1M | output / 1M | context |
|---|---|---|---|
| Muse Wonder | $4 | $20 | 1,048,576 |
| Claude Opus 5.5 | $4 | $20 | 1,000,000 |
| Claude Fable 5.1 | $10 | $50 | 1,000,000 |
| GPT-6 Astra | $10 | $50 | 1,050,000 |
| Gemini 4 Argon | $2 | $10 | 1,000,000 |
Gemini 4 Argon ist nach dem Ausgabepreis die günstigste Option im Vergleich, während Claude Fable 5.1 und GPT-6 Astra die teuersten Optionen darstellen.
Muse Wonder vs Muse Wonder Full
- Muse Wonder - verfügbar über die Meta Model API (Modell-ID muse-wonder-1.0), in Muse Code und bei OpenRouter (meta/muse-wonder). Preis: 4 USD pro 1 Mio. Eingabe-Tokens, 20 USD pro 1 Mio. Ausgabe-Tokens.
- Muse Wonder Full - die leistungsstärkere Variante, ohne API. Nur in Muse Code mit den Tarifen Power Usage (50 USD pro Monat) und Maximum Usage (200 USD pro Monat).
- Reasoning-Stufe "max" macht aus Muse Wonder kein Muse Wonder Full - es sind getrennte Modelle.
- Kontextfenster: 1.048.576 Tokens. Eingabe: Text, Bild, Video, Audio und PDF. Ausgabe: Text.
Benchmarks laut Meta
Von Meta am 12. Oktober 2026 veröffentlichte Werte, alle Modelle mit maximaler Reasoning-Stufe. Es sind Messungen des Herstellers, keine unabhängigen Tests.
| benchmark | Muse Wonder Full | Muse Wonder | Claude Fable 5.1 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partial) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| OSWorld V2.1 (binary) | 39.4 | 34.3 | 43.1 | 34.3 | - |
| MemoryBench | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5 | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
Unabhängige Rangliste: Artificial Analysis Intelligence Index
- Claude Opus 5.5 - 58
- Muse Wonder Full - 56
- Claude Fable 5.1 - 53
- GPT-6 Astra - 53
- Gemini 4 Argon - 53
- Muse Wonder - 52
Stand: 12. Oktober 2026. Am selben Tag hatte Muse Wonder noch keine Platzierung in LMArena.
Unser Test
Wir haben am Tag der Vorstellung, dem 12. Oktober 2026, einen eigenen Test durchgeführt: 23 Aufgaben über OpenRouter, Reasoning-Stufe low für alle Modelle, automatische Bewertung (lokal ausgeführte Unit-Tests, Prüfung der Tool-Aufrufe, exakte Antworten), ein Durchlauf pro Aufgabe, kein KI-Richter. Dabei waren 3 Agenten-Aufgaben mit Tools, 4 Programmieraufgaben mit Unit-Tests, 4 Schreibaufgaben auf Polnisch, 11 Denkaufgaben mit exakter Lösung und 1 Aufgabe mit langem Dokument.
| Modell | Ergebnis | Kosten (USD) | Zeit (s) |
|---|---|---|---|
| Muse Wonder | 99,7% | 0,64 | 165 |
| Claude Opus 5.5 | 99,4% | 0,75 | 222 |
| GPT-6 Astra | 100,0% | 1,12 | 200 |
| Claude Fable 5.1 | 99,4% | 1,71 | 263 |
| Gemini 3.8 Flash | 99,5% | 0,09 | 139 |
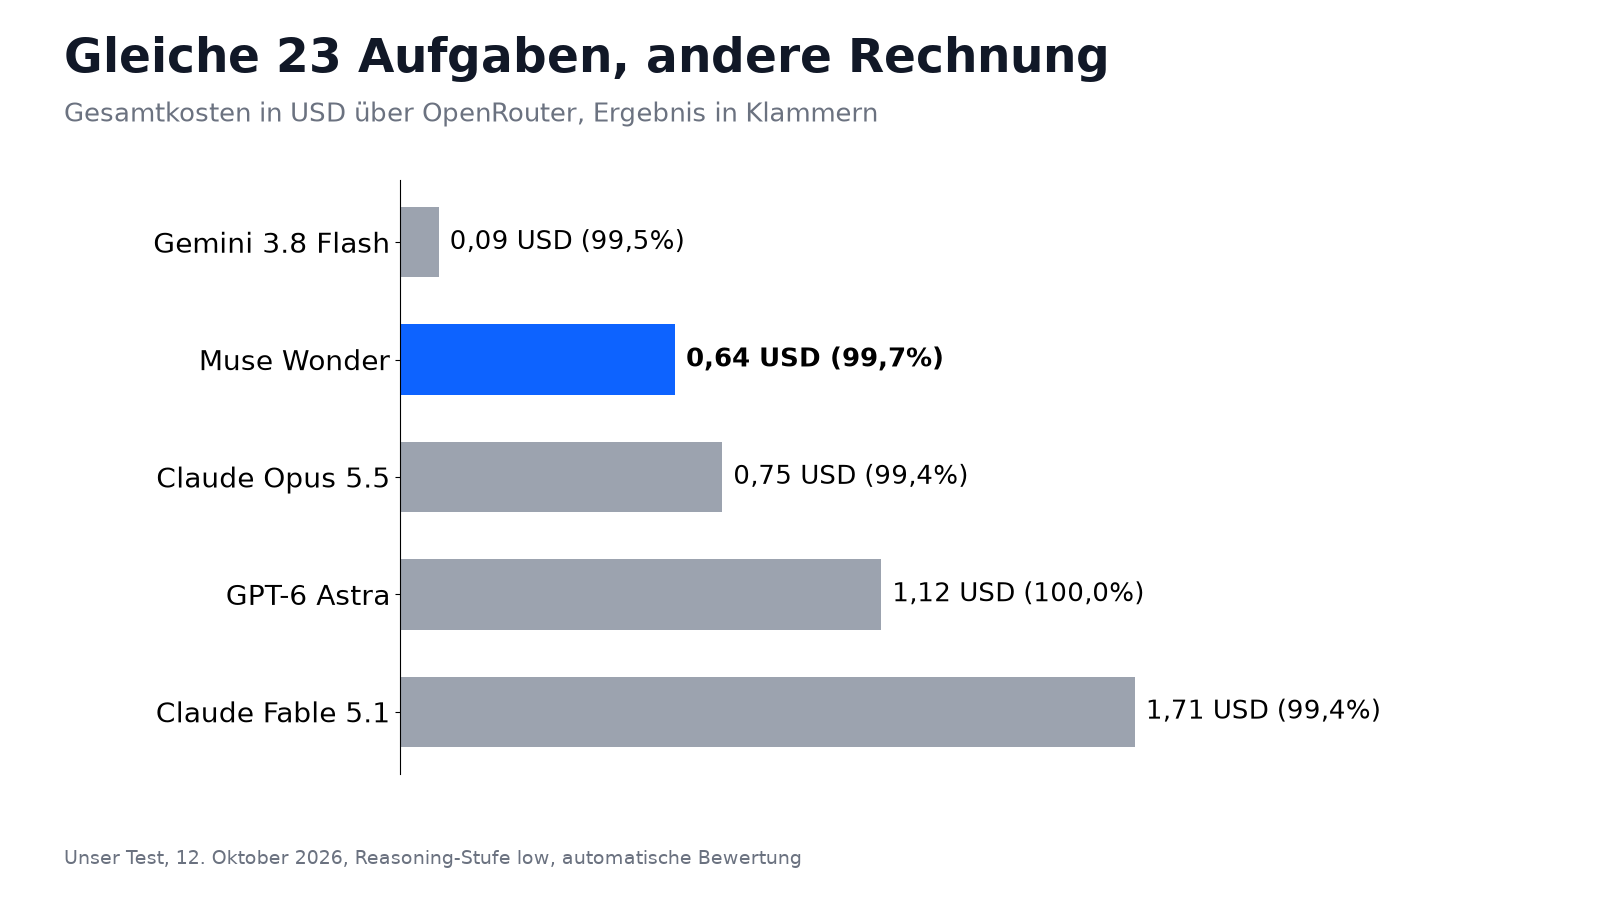
- Muse Wonder erreichte 99,7 % für 0,64 USD - knapp vor Claude Opus 5.5 (99,4 %, 0,75 USD) zum gleichen Listenpreis und schneller: 165 s statt 222 s.
- GPT-6 Astra kam als einziges Modell auf 100 %, kostete aber 1,12 USD; Claude Fable 5.1 kostete 1,71 USD für 99,4 %.
- Gemini 3.8 Flash erreichte 99,5 % für nur 0,09 USD.
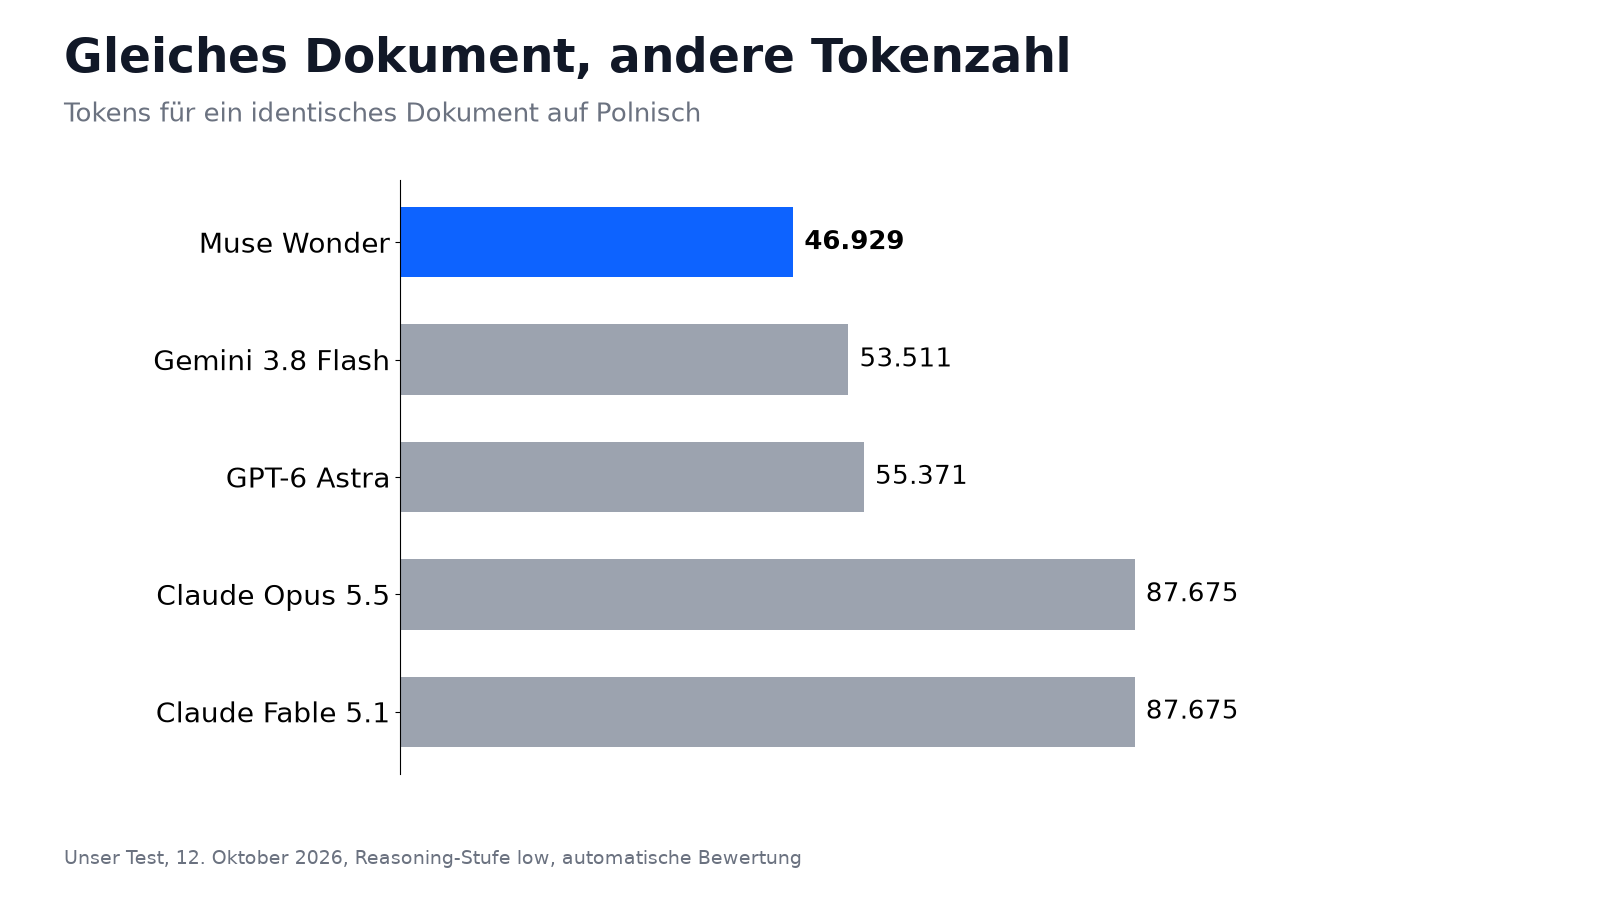
- Dasselbe polnische Dokument ergab bei Muse Wonder 46.929 Tokens, bei Claude 87.675. Eine Frage dazu kostete mit Muse Wonder 0,193 USD, mit Opus 5.5 0,355 USD.
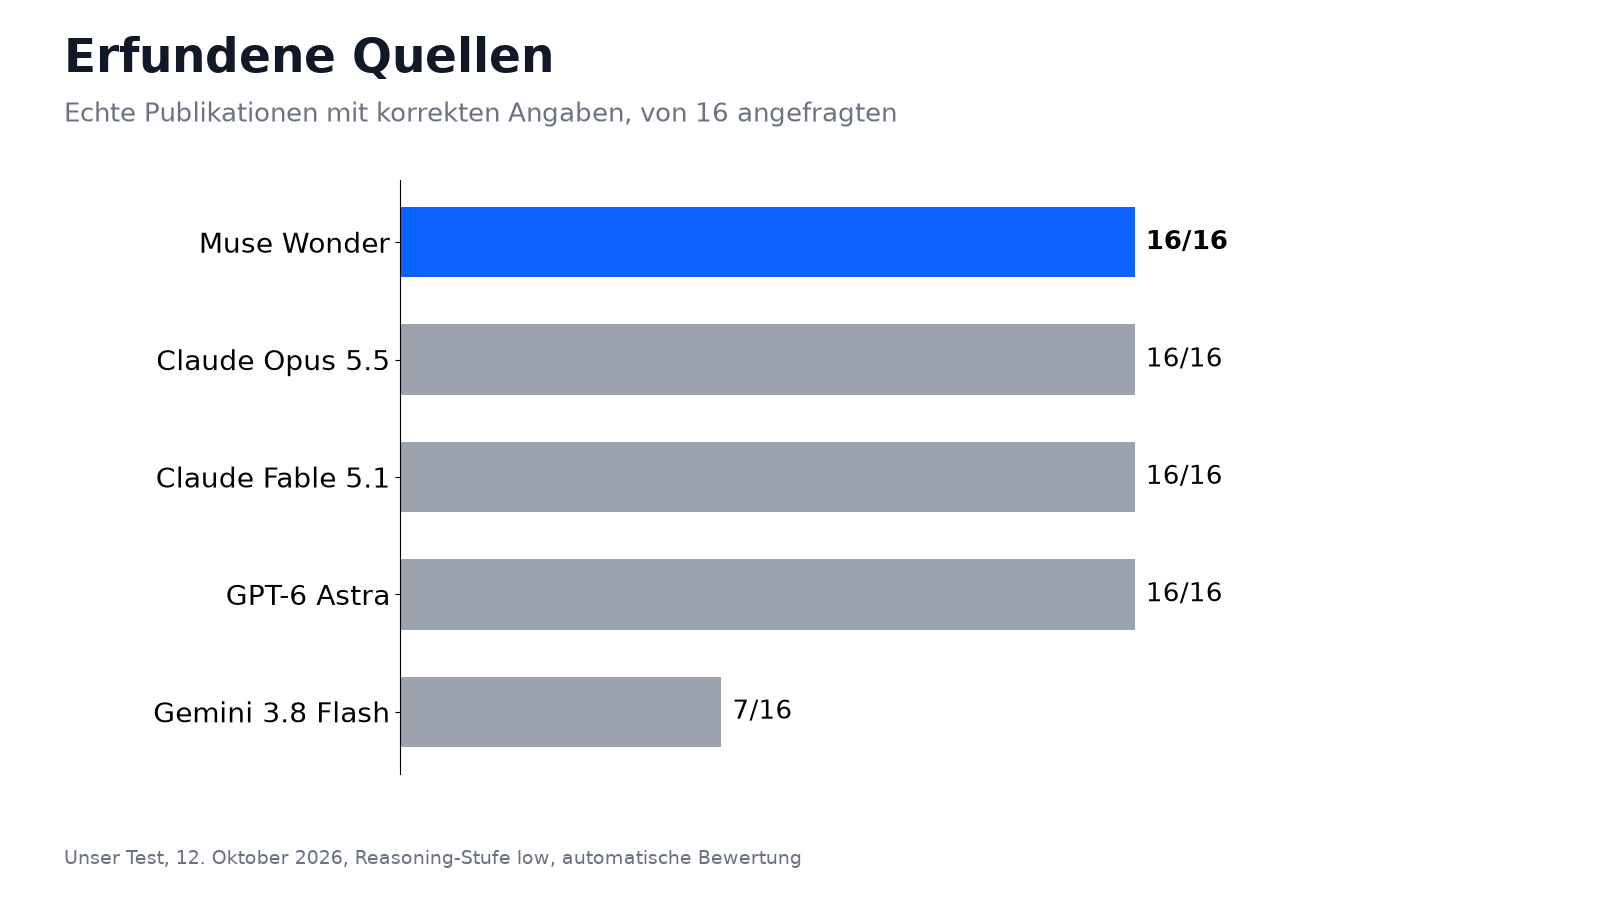
- Erfundene Quellen: Gefragt waren 8 echte Publikationen zu 2 Themen. Muse Wonder, Opus 5.5, Fable 5.1 und GPT-6 Astra lieferten 16 von 16 echten Titeln mit korrekten Angaben, Gemini 3.8 Flash nur 7 von 16 (früherer Durchlauf, gleicher Prompt). Geprüft in Crossref und OpenAlex.
- Der einzige echte Fehler von Muse Wonder: ein nicht existierendes Zahlwort im Code, der Beträge in Worten ausgibt (15 von 16 Unit-Tests bestanden).
Ein Durchlauf pro Aufgabe auf Stufe low: Unterschiede unter 1 Punkt liegen im Rauschen.
Artikel zu Muse Wonder
- Muse Wonder: API-Preise, Muse Code und echte Kosten 2026-10-16
- Muse Wonder Benchmarks im Detail: Metas 14 Tests erklärt 2026-10-13
- Meta Muse Wonder im Test: Benchmarks, Preise und API-Details 2026-10-12
- Muse Wonder vs Claude Opus 5.5, Fable 5.1 und GPT-6 Astra: Zahlen 2026-10-12
- Meta Muse Wonder: Benchmarks, Preise und erste Testergebnisse 2026-10-12
- Muse Wonder: Alternativen zu Metas KI-Modell 2026-10-12
- Muse Wonder nutzen: Anleitung für OpenRouter, API und Muse Code 2026-10-12
- Muse Wonder vs Claude Opus 5.5: Vergleich der Modelle 2026-10-12
- Muse Wonder im Test: 23 Aufgaben gegen Opus 5.5 und GPT-6 2026-10-12
- Muse Wonder Preis: Kosten der Meta-KI im Detail 2026-10-12
Häufig gestellte Fragen (FAQ)
- Was kostet die Nutzung von Muse Wonder?
- Über die API kostet Muse Wonder 4 USD pro 1 Million Eingabe-Tokens und 20 USD pro 1 Million Ausgabe-Tokens, wobei Reasoning-Tokens als Ausgabe abgerechnet werden. Für zwischengespeicherte Eingaben fallen 0.20 USD pro 1 Million Tokens an. Im Muse Code Abonnement ist das Modell in Plänen ab 5 USD bis 200 USD monatlich enthalten.
- Wie unterscheidet sich Muse Wonder von Claude Opus 5.5?
- Beide Modelle weisen mit 4 USD für Input und 20 USD für Output identische API-Listenpreise auf. Laut Angaben von Meta führt Muse Wonder auf MemoryBench mit 85.6 gegenüber 81.5 Punkten bei Claude Opus 5.5, liegt aber auf Terminal-Bench 4.0-AA mit 52.0 hinter Opus 5.5 mit 59.6 Punkten. Im unabhängigen Artificial Analysis Intelligence Index erreicht Claude Opus 5.5 58 Punkte, während Muse Wonder auf 52 Punkte kommt.
- Was unterscheidet Muse Wonder von Muse Wonder Full?
- Muse Wonder Full ist die leistungsstärkere Variante der Serie, besitzt jedoch keine API-Schnittstelle. Es steht ausschließlich über Muse Code in den Plänen für 50 USD und 200 USD pro Monat bereit. Laut Meta-Dokumentation wird Muse Wonder auch bei maximaler Reasoning-Stufe nicht zu Muse Wonder Full, da es sich um zwei getrennte Modelle handelt.
- Welche Modalitäten und Kontextlängen unterstützt Muse Wonder?
- Das Modell verarbeitet Eingaben in Form von Text, Bild, Video, Audio sowie PDF und liefert Textausgaben zurück. Das Kontextfenster umfasst 1.048.576 Tokens. Zudem lassen sich Stufen für den Reasoning-Aufwand von minimal bis maximal festlegen.
- Werden API-Daten für das Training von Meta-Modellen verwendet?
- Meta gibt an, dass Eingabeaufforderungen und Antworten im Standard-Modus der API nicht für das Training von Modellen verwendet werden. Zudem liegt für Muse Wonder bisher keine Platzierung im LMArena-Ranking vor. Eine Liste der Länder, in denen das Modell bereitgestellt wird, wurde von Meta bislang nicht veröffentlicht.