Gemini 4 Argon im Test: 23 Aufgaben gegen Opus 5.5 und GPT-6 Astra
Gemini 4 Argon im Härtetest: 23 Aufgaben zu Code, Agenten und Kontext. 99,5 % Genauigkeit bei ca. 0,20 EUR und Rekordzeit im Flaggschiff-Vergleich.
Aktualisierung (9. November 2026): Claude Fable 5.2 und Mythos 5.2 sind erschienen - Preise, Zugang und Benchmarks im Überblick zu Claude Fable 5.2.
👁 134 Aufrufe
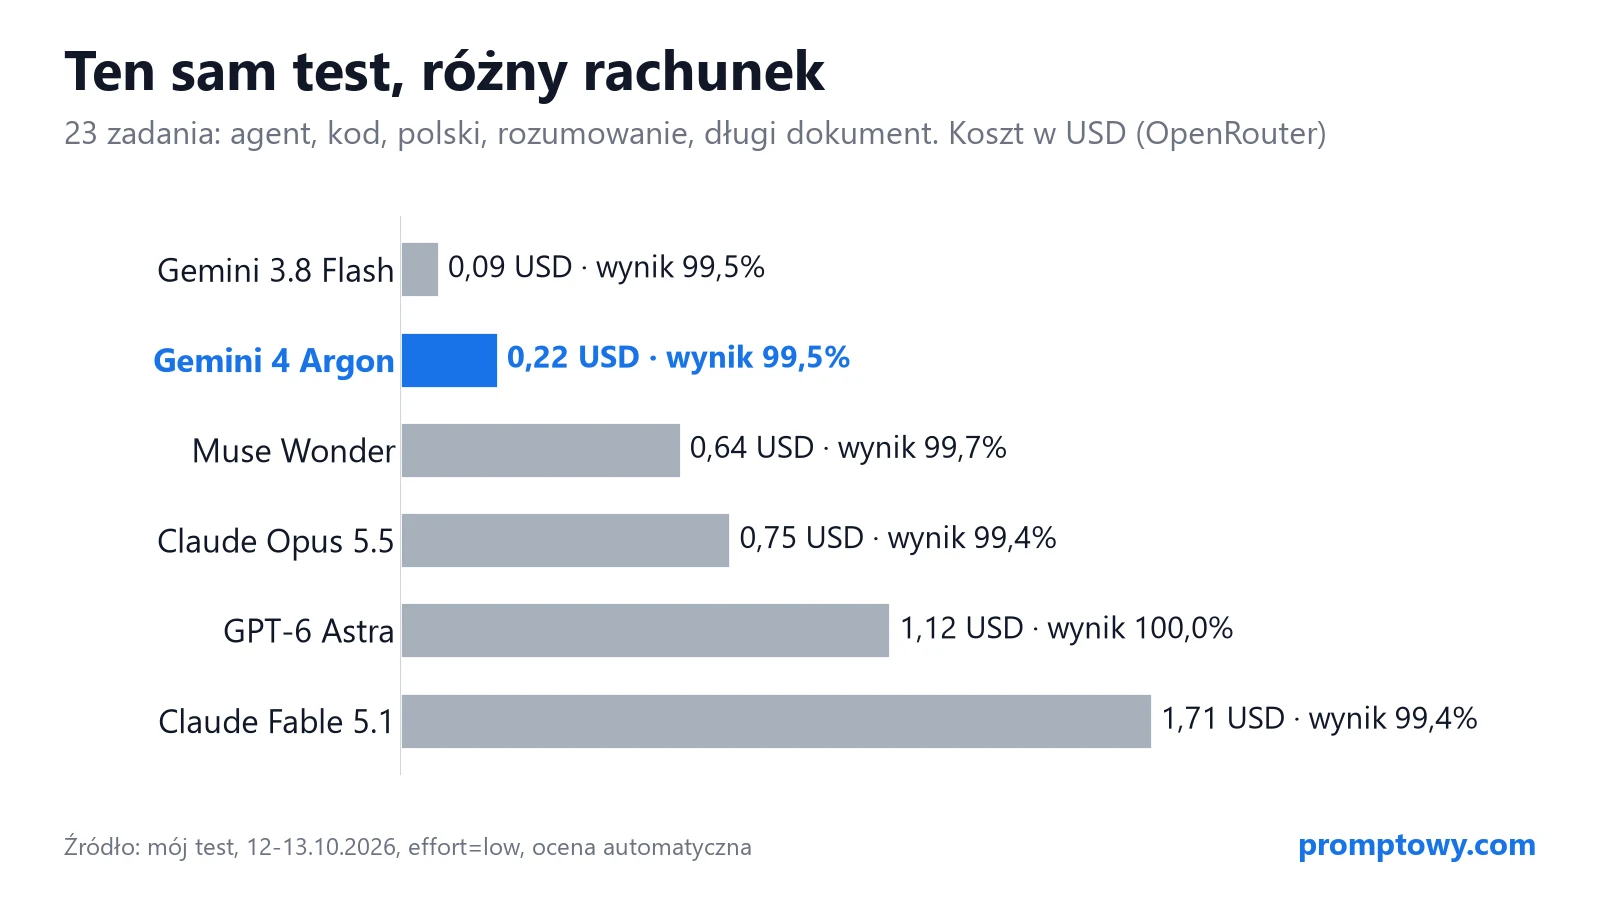
Am Abend des 13. Oktober 2026, eine halbe Stunde nachdem Google Gemini 4 Argon für zahlende Nutzer freigeschaltet hatte, schickte ich das Modell durch denselben Parcours aus 23 Aufgaben, den am Vortag Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra und Gemini 3.8 Flash absolviert hatten. Argon erreichte 99,5 %, kostete rund 0,20 EUR (0,22 USD) und war mit 135 Sekunden für das gesamte Set das schnellste Modell im Testfeld (Umrechnungskurs: 1 EUR = 1,1181 USD, EZB-Referenzkurs vom 12.10.2026, Quelle: EZB). Der einzige abgezogene Punkt ging auf einen Fehler in meinem Auswertungsskript zurück; der eigentliche Patzer lauerte jedoch tiefer im generierten Text. Modellarchitektur, offizielle Tarife und Verfügbarkeit habe ich im Ratgeber zu Gemini 4 Argon zusammengefasst.
Testdurchlauf vom 13. Oktober 2026, Abendsitzung
- Modell:
google/gemini-4-argonüber OpenRouter, Reasoning-Level auf „low“ eingestellt. - Vergleichsmodelle: identische 23 Aufgaben, derselbe Code und dieselben Konfigurationen, durchgeführt am 12. Oktober im Rahmen des Muse-Wonder-Tests.
- Automatisierte Auswertung: Unit-Tests, Überprüfung von Tool-Calls und String-Matching. Kein AI-Judge. Jeder Punkteabzug wurde von mir manuell nachgeprüft.
- Kosten für Argon im Testdurchlauf: ca. 0,20 EUR (0,22 USD) zum Einführungstarif (2 / 10 USD pro Million Token; ca. 1,79 / 8,94 EUR).
Ergebnisse im Gesamtüberblick
| Modell | Ergebnis (23 Aufgaben) | Kosten (USD) | Kosten (ca. EUR) | Gesamtzeit |
|---|---|---|---|---|
| Gemini 4 Argon | 99,5% | 0,22 USD | ca. 0,20 EUR | 135 s |
| Muse Wonder | 99,7% | 0,64 USD | ca. 0,57 EUR | 165 s |
| Claude Opus 5.5 | 99,4% | 0,75 USD | ca. 0,67 EUR | 222 s |
| GPT-6 Astra | 100% | 1,12 USD | ca. 1,00 EUR | 200 s |
| Claude Fable 5.1 | 99,4% | 1,71 USD | ca. 1,53 EUR | 263 s |
| Gemini 3.8 Flash | 99,5% | 0,09 USD | ca. 0,08 EUR | 139 s |
Das Gesamtergebnis bildet den ungewichteten Durchschnitt über alle 23 Aufgaben ab. Bei mehrteiligen Aufgaben zählt der prozentuale Anteil der erfüllten Kriterien. Unter den Flaggschiff-Modellen arbeitet Argon am günstigsten: Es ist 3,4-mal preiswerter als Claude Opus 5.5, 5-mal günstiger als GPT-6 Astra und unterbietet Muse Wonder um den Faktor 2,9. Lediglich Gemini 3.8 Flash aus dem Einstiegssegment erzeugte geringere Kosten. (Hinweis zu Schätzungen: Umrechnung anhand von 1 EUR = 1,1181 USD, EZB-Referenzkurs vom 12.10.2026).
Prüfkriterien und Aufgabenaufbau
| Kategorie | Aufgaben | Evaluationsmethode |
|---|---|---|
| Agent mit Tools (3) | Reiseplanung nach Lissabon mit 3 API-Tools und Preisfallen; Retoure von Schuhen nach Fristablauf; EUR-Rechnungen mit Wechselkursabfrage bei provoziertem API-Fehler (503) | Korrektheit der Tool-Calls, Auswahlkriterien, numerische Genauigkeit |
| Code (4) | Steuernummern-Validierung, Intervallzusammenführung, Werktagsberechnung inklusive Sonderfeiertage, Konvertierung von Rechnungsbeträgen in ausgeschriebene Wörter | 51 lokale Unit-Tests |
| Sprachverarbeitung (4) | Korrektur von 10 Fehlern, Zusammenfassung in 3 Punkten auf maximal 60 Wörter, behördlicher Widerspruchsbescheid, Flexion komplexer Eigennamen | Prüfliste und exakte morphologische Zielformen (getestet in polnischer Sprache) |
| Reasoning (11) | Kombinatorik, Kalenderlogik, Uhrzeigerwinkel, Ritter-und-Schurken-Rätsel | Exakter Abgleich der Lösungswerte |
| Langer Kontext (1) | 80 Vorstandsprotokolle (158.111 Zeichen auf Polnisch), 5 Detailfragen, darunter ein nachträglich revidierter Beschluss und eine Fangfrage zu nicht existierenden Daten | Exakte Übereinstimmung der Zielantworten |
Argon im direkten Kategorievergleich
| Kategorie | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Agent | 100%, ca. 0,022 EUR (0,025 USD) | 100%, ca. 0,081 EUR (0,091 USD) | 100%, ca. 0,089 EUR (0,100 USD) |
| Code | 100%, ca. 0,025 EUR (0,028 USD) | 100%, ca. 0,074 EUR (0,083 USD) | 100%, ca. 0,116 EUR (0,130 USD) |
| Sprachverarbeitung | 97,2%, ca. 0,020 EUR (0,022 USD) | 96,4%, ca. 0,098 EUR (0,110 USD) | 100%, ca. 0,097 EUR (0,108 USD) |
| Reasoning | 100%, ca. 0,039 EUR (0,044 USD) | 100%, ca. 0,102 EUR (0,114 USD) | 100%, ca. 0,075 EUR (0,084 USD) |
| Langer Kontext | 100%, ca. 0,092 EUR (0,103 USD) | 100%, ca. 0,317 EUR (0,355 USD) | 100%, ca. 0,622 EUR (0,695 USD) |
Hervorgehoben ist der Bestwert je Zeile, bei Punktgleichstand die geringste Kostenquote. Die übrigen Modelle verloren Punkte an anderer Stelle: Muse Wonder stolperte im Code-Bereich (98,4 %, Wortbildungsfehler bei Zahlwörtern), Gemini 3.8 Flash patzte bei der Feiertagsberechnung (96,9 %), während Claude Fable 5.1 und Opus 5.5 bei der Textzusammenfassung das strenge 60-Wörter-Limit überschritten (96,4 %).
Stärken von Argon: API-Kosten und Latenz
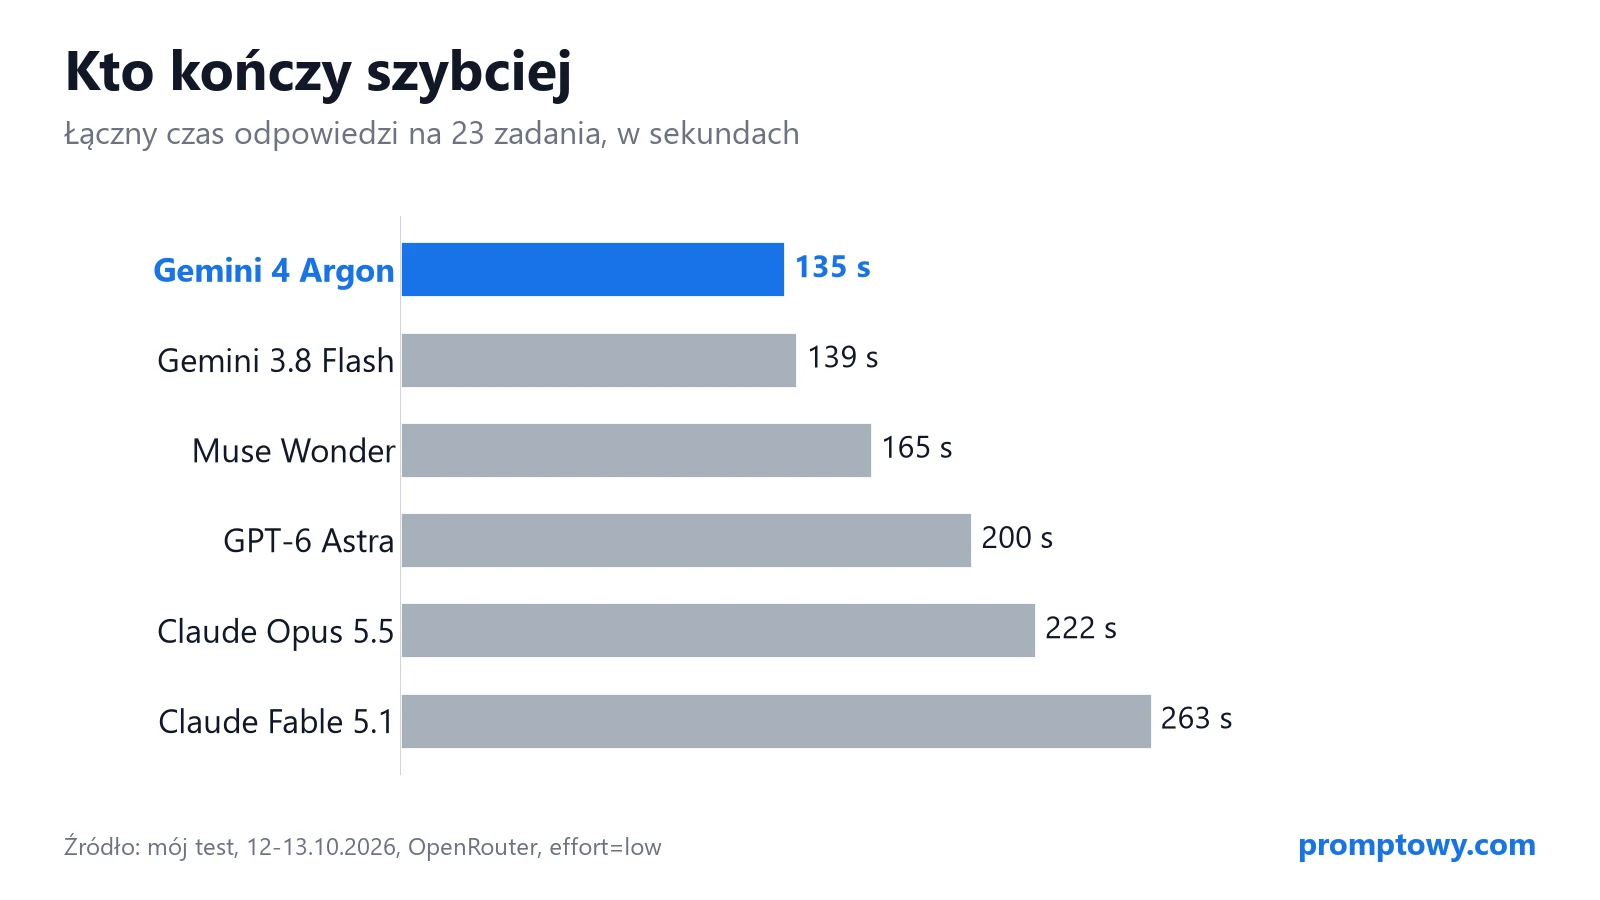
Argon formuliert präzise und liefert Tokens ohne lange Wartezeiten. Über OpenRouter mit der Einstellung „effort=low“ wurden in keinem der 23 Durchläufe Reasoning-Tokens ausgewiesen; die Korrektur des 10-Fehler-Texts lag nach 2,6 Sekunden vor. Im Vergleich dazu verbrauchte Muse Wonder allein für die Reiseplanung 636 interne Denk-Tokens. Wesentliche Beobachtungen aus den Szenarien:
- Reiseplanung Lissabon: 4 Tool-Aufrufe über 2 Iterationen, beide Fallen umschifft (zu früher Abflug und unterbewertetes Hotel), Gesamtausgaben exakt berechnet, Einplanung eines Museumsbesuchs wegen 80 % Regenrisiko. Identisches Ergebnis wie die Konkurrenz, jedoch für lediglich ca. 0,010 EUR (0,011 USD).
- Shop-Widerruf: Identifizierte die korrekte Bestellposition, verweigerte das Retourenetikett und begründete dies sachlich mit Ablauf der 30-Tage-Frist (32 Tage seit Zustellung).
- Rechnungsprüfung: Nach einem simulierten 503-Statuscode der Zentralbank-API erfolgte ein automatischer Retry; bereits beglichene Posten wurden ignoriert und der offene Betrag exakt kalkuliert.
- Langer Kontext: 5 von 5 Detailfragen wurden innerhalb von 4,5 Sekunden für ca. 0,09 EUR (0,10 USD) beantwortet. Das Modell erkannte die spätere Korrektur einer Lagerfläche auf 6.200 m2 und gab bei der erfundenen TikTok-Kampagne korrekt „NICHT VORHANDEN“ aus. Nur GPT-6 Astra war mit 3,5 Sekunden schneller, schlug aber mit ca. 0,62 EUR (0,69 USD) zu Buche.
Bei langen Dokumenten spielt der Tokenizer eine erhebliche Rolle. Dieselben 158.111 Zeichen belegten bei Argon 51.482 Tokens, während Claude 87.675 Tokens zählte - ein Aufschlag von 70 %. Gepaart mit den niedrigeren Token-Preisen führt das zu deutlichen Kostenabständen: Die Dokumentenabfrage kostete bei Argon 0,10 USD, bei Muse Wonder 0,19 USD (trotz schlanker 46.929 Tokens wegen des Basispreises von 4 USD / 1M), bei Opus 5.5 0,35 USD, bei Astra 0,69 USD und bei Fable 5.1 0,88 USD.
Der Behördenbrief: Falscher Punktabzug, echte Halluzination
Das automatisierte Skript vergab für Argons Entwurf eines Widerspruchsschreibens gegen einen abgelehnten Rentenbescheid 8 von 9 Punkten. Angeblich fehlte das Bezirksgericht als Adressat. Die manuelle Nachprüfung zeigte: Der Empfänger war vorhanden, allerdings im Akkusativ/Genitiv formuliert („An das Bezirksgericht… über die Rentenversicherungsanstalt“). Mein Skript hatte starr nach dem Nominativ gesucht - der Fehler lag also beim Testskript, nicht am LLM. Manuell korrigiert läge Argon wie GPT-6 Astra bei glatten 100 %. Um gleiche Maßstäbe anzulegen, verbleibt in den Tabellen der automatisierte Messwert.
Inhaltlich überzeugte der Schriftsatz in weiten Teilen: Argon wies auf die vorherige Anrufung der Ärztekommission hin und berechnete die Fristen inklusive Feiertagsverschiebung auf den Werktag korrekt. Die Schwachstelle lag in der Sachverhaltsbegründung. Vorgegeben war lediglich, dass kardiologische Befunde aus 2026 übergangen worden seien. Argon ergänzte eigenmächtig nicht genannte Symptome sowie Vorwürfe gegen den Gutachter (Übersetzung aus dem polnischen Originaltest):
„Die Krankheitssymptome wie rasche Ermüdbarkeit, Belastungsdyspnoe, Blutdruckspitzen und Schmerzen im Brustkorb machen mir ein normales Funktionieren im Alltag unmöglich (…)“
„Der Gutachterarzt führte die Untersuchung bei der Erstellung des Gutachtens lediglich oberflächlich durch (…)“
Opus 5.5 schlug Beschwerden ebenfalls vor, setzte diese jedoch in eckige Klammern als Platzhalter für den Nutzer. Argon stellte Behauptungen als feststehende Tatsachen dar. Bei rechtlichen Schriftsätzen birgt dies erhebliche Risiken. Wer Behördentexte generieren lässt, muss Begründungsteile zwingend Satz für Satz prüfen.
Kostenentwicklung nach der Einführungsphase
Der Tarif von 2 / 10 USD pro 1 Million Tokens (Input / Output) galt bis zum 30. November 2026. Ab dem 1. Dezember steigen die API-Preise regulär auf 4 / 20 USD (ca. 3,58 / 17,89 EUR; EZB-Kurs 12.10.2026: 1 EUR = 1,1181 USD), womit Argon preislich mit Opus 5.5 und Muse Wonder gleichzieht. Hochgerechnet auf diesen Testaufbau verdoppeln sich die Kosten annähernd:
| Modell | Preis je 1 Mio. Tokens (In / Out in USD) | Preis je 1 Mio. Tokens (ca. EUR) | Kosten des Testsets |
|---|---|---|---|
| Gemini 4 Argon (bis 30.11.) | 2 / 10 USD | ca. 1,79 / 8,94 EUR | ca. 0,20 EUR (0,22 USD) |
| Gemini 4 Argon (ab 01.12.) | 4 / 20 USD | ca. 3,58 / 17,89 EUR | ca. ca. 0,40 EUR (0,45 USD) |
| Muse Wonder | 4 / 20 USD | ca. 3,58 / 17,89 EUR | ca. 0,57 EUR (0,64 USD) |
| Claude Opus 5.5 | 4 / 20 USD | ca. 3,58 / 17,89 EUR | ca. 0,67 EUR (0,75 USD) |
| GPT-6 Astra | 10 / 50 USD | ca. 8,94 / 44,72 EUR | ca. 1,00 EUR (1,12 USD) |
| Claude Fable 5.1 | 10 / 50 USD | ca. 8,94 / 44,72 EUR | ca. 1,53 EUR (1,71 USD) |
| Gemini 3.8 Flash | 0,75 / 3,75 USD | ca. 0,67 / 3,35 EUR | ca. 0,08 EUR (0,09 USD) |
Selbst nach der Preisanpassung bleibt Argon bei dieser Aufgabenstellung rund 1,7-mal günstiger als Opus 5.5 bei nominell gleichen Token-Preisen. Ausschlaggebend hierfür sind knappe Ausgaben ohne ausgewiesene Reasoning-Overheads und eine effiziente Tokenisierung. Die Kosten für Prompt-Caching steigen synchron von 0,10 auf 0,20 USD pro Million Tokens.
Methodische Grenzen des Tests
- Effort=low: Alle Modelle wurden mit der niedrigsten Reasoning-Stufe betrieben, um Kosten und Laufzeiten vergleichbar zu halten. Hersteller-Benchmarks von Google bilden häufig die maximale Denkstufe ab.
- Stichprobenumfang: 23 Aufgaben in je einem Einzeldurchlauf. Minimale Punktunterschiede sind stochastischer Natur und begründen keine generelle Überlegenheit.
- Messzeitpunkte: Die Konkurrenzmodelle wurden am 12. Oktober getestet, Argon am 13. Oktober kurz nach Veröffentlichung der Schnittstelle. Schwankungen in der Serverauslastung beeinflussen die Latenzen.
- Deckeneffekt: Alle Kandidaten bewegten sich im Bereich von 99 bis 100 %. Der Test dient dem Vergleich von Effizienz, Kosten und Fehlertypen, nicht der Ermittlung kognitiver Höchstgrenzen bei komplexen mathematischen Beweisen.
- Automatisierte Bewertung: Das Framework erfasst syntaktische und sachliche Übereinstimmungen, keine stilistischen Nuancen.
- OpenRouter-Routing: Die Anbindung erfolgte über OpenRouter und nicht über die native Gemini-API mit Google-Rechnungsstellung.
Fazit
Im praktischen Einsatz erbringt Gemini 4 Argon vergleichbare Leistungen wie Opus 5.5, Astra und Fable 5.1, arbeitet dabei jedoch spürbar schneller und kostengünstiger. Bis Ende November 2026 markierte das Modell das wirtschaftlichste Flaggschiff in dieser Testreihe; auch nach der Preiserhöhung bleibt es im Token-Verbrauch effizient. Einschränkungen zeigen sich bei Details: Bei juristischen Dokumenten ergänzt Argon ungefragt plausible, aber frei erfundene Behauptungen. Bei anspruchsvoller Prosa und stilistischer Textarbeit erzielte Opus 5.5 in separaten Blindtests mit 90,1 Punkten gegenüber 81,8 Punkten von Argon (Platz 8) bessere Resultate - mehr dazu im Bericht Gemini 4 Argon Sprachqualitätsanalyse. Diese Einschätzung basiert auf den Ergebnissen des Testlaufs vom 13. Oktober 2026.
Häufige Fragen (FAQ)
Ist Gemini 4 Argon besser als Claude Opus 5.5?
Im 23-Aufgaben-Benchmark liegen beide Modelle mit 99,5 % gegenüber 99,4 % praktisch gleichauf. Argon arbeitete im Test 3,4-mal günstiger und lieferte Antworten schneller. Bei rein stilistischen Schreibaufgaben behält Opus 5.5 die Oberhand.
Welche API-Preise gelten für Gemini 4 Argon?
Bis zum 30. November 2026 liegen die Tarife bei 2 USD pro 1 Million Input-Tokens (ca. 1,79 EUR) und 10 USD pro 1 Million Output-Tokens (ca. 8,94 EUR). Ab dem 1. Dezember 2026 gelten regulär ca. 3,58 EUR (4 USD) beziehungsweise 20 USD (ca. 17,89 EUR; Umrechnung via EZB-Kurs vom 12.10.2026).
Über welche Plattform wurde der Test durchgeführt?
Der Testlauf erfolgte über OpenRouter unter der Modellkennung google/gemini-4-argon, worüber der Zugriff am 13. Oktober 2026 zur Verfügung stand.
Quellen
- Eigener Test via OpenRouter: Gemini 4 Argon am 13.10.2026, Vergleichsmodelle am 12.10.2026, 23 Aufgaben, Reasoning-Level „low“, automatisierte Unit-Tests mit manueller Verifikation
- OpenRouter: Gemini 4 Argon Modellübersicht und Preise
- Gemini API: Offizielle Preisdokumentation
- Google: Gemini 4 Argon: Built to solve your hardest problems (13.10.2026)
- Google DeepMind: Gemini 4 Argon Evaluation Technical Report
More on this from WISSNOX