Imagen 2 vs Imagen 3 vs DALL-E 3: Test mit 6 Aufgaben
Drei Bildgeneratoren, sechs Aufgaben, identische Prompts: Polnische Sonderzeichen, Objekte zählen, Hände, Fotorealismus, flache Illustration und Diagramm.
👁 115 Aufrufe
- Imagen 3 gewann den Vergleich aller sechs Aufgaben: Es zählte Früchte korrekt, befolgte die Minimalismus-Anweisung und lieferte das erkennbarste Warschau-Motiv.
- DALL-E 3 war mit durchschnittlich 76 Sekunden pro Bild vier- bis achtmal langsamer als Imagen 2 (etwa 12 s) und Imagen 3 (etwa 21 s).
- Imagen 2 scheiterte als einziges Modell beim Zählen - es generierte fünf statt vier Äpfel und fiel damit bei Aufgaben mit genauer Objektanzahl aus.
Die Frage, die wir bei Bildgeneratoren am häufigsten gestellt bekommen, lautet: Welcher ist derzeit der beste? Die Antwort „das kommt darauf an“ ist zwar richtig, aber wenig hilfreich. Deshalb haben wir einen direkten Test gemacht: Dieselben Prompts an drei Modelle, jeweils ein Durchgang, ohne Auswahl des schönsten Ergebnisses. Was herauskam, sehen Sie hier nebeneinander.
Die Modelle: Imagen 2 und Imagen 3 von Google (beide von Juni) sowie DALL-E 3 von OpenAI (von April). Zur Klarstellung: Ein neueres Bildmodell von OpenAI gibt es schlicht nicht - wir haben die Modellliste am 4. September geprüft, und dies ist die aktuellste Position des Unternehmens. Die sechs Aufgaben haben wir so gewählt, dass jede eine konkrete Fähigkeit testet, nicht nur allgemein „schön“.
Aufgabe 1: Polnischer Text mit Sonderzeichen
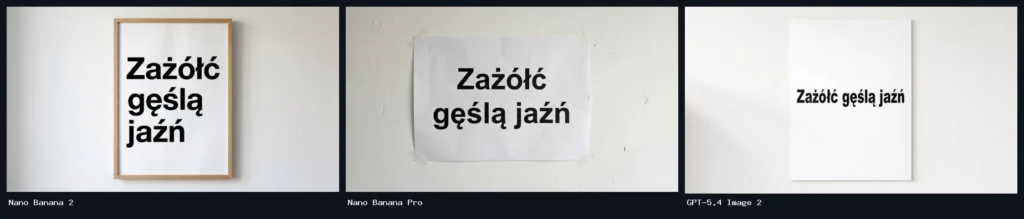
Noch vor einem Jahr war dies ein Test, den jeder Generator nicht bestand: Die polnischen Buchstaben ą, ę, ł, ś, ź landeten als zufällige Striche oder verschwanden ganz. Heute haben alle drei Modelle „Zażółć gęślą jaźń„ fehlerfrei geschrieben, mit jedem diakritischen Zeichen an der richtigen Stelle. Die Unterschiede sind rein stilistisch: Google fügte einen Rahmen und Klebeband hinzu, OpenAI erzeugte ein nacktes Blatt. Dieses Problem kann als gelöst betrachtet werden. Wir haben den Test auf Polnisch durchgeführt, da dies die Muttersprache unserer Redaktion ist.
Aufgabe 2: Genau vier Äpfel und zwei Birnen
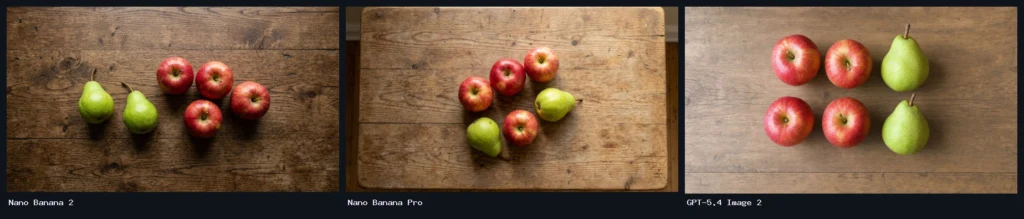
Das Zählen ist nach wie vor eine Schwachstelle. Imagen 2 hat einen fünften Apfel hinzugefügt. Imagen 3 und DALL-E 3 haben korrekt gezählt, wobei das OpenAI-Modell die Früchte in einem starren Zwei-mal-drei-Raster anordnete, als wolle es sich die Aufgabe erleichtern, während das Google-Modell sie natürlich verteilte und sich ebenfalls nicht verzählte. Wenn ein Bild eine bestimmte Anzahl von Objekten zeigen soll, fällt das günstigere Google-Modell aus.
Aufgabe 3: Hände
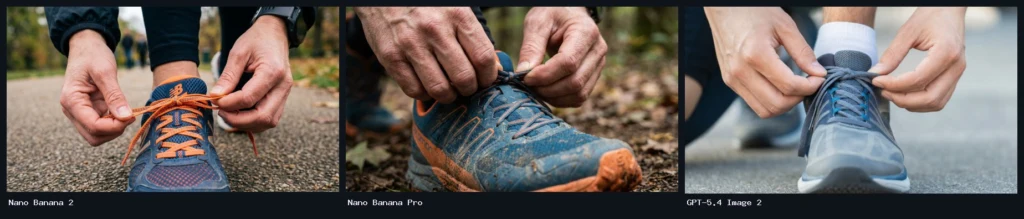
Der klassische Test, bei dem Generatoren früher einen sechsten Finger hinzufügten. Auf allen drei Bildern haben die Hände die korrekte Anzahl von Fingern und einen sinnvollen Griff am Schnürsenkel. Imagen 3 lieferte den fotografischsten Bildausschnitt mit Schmutz am Schuh, DALL-E 3 das sauberste, aber etwas plastisch wirkende Ergebnis. Bei dieser Auflösung sehen wir bei keinem anatomische Fehler.
Aufgabe 4: Warschau, Straßenbahn, Regen, Dämmerung
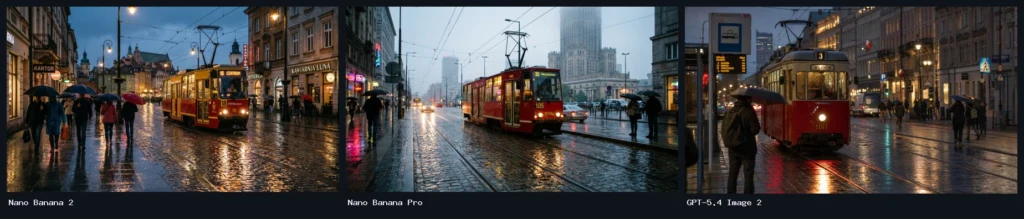
Hier zeigt sich, was die Modelle über Polen wissen. Imagen 3 platzierte im Hintergrund den Kulturpalast und eine Gelenkstraßenbahn in Warschauer Farben - eine Szene, die jeder erkennt, der in der Hauptstadt war. Imagen 2 lieferte eine Straße im Altstadtstil mit lesbaren polnischen Schildern. DALL-E 3 generierte einen historischen Waggon mit Richtungsschild und Haltestellenmast, korrekt, aber ohne Orientierungspunkt. Alle drei halten Licht, nasses Pflaster und Reflexionen auf einem Niveau, das vor zwei Jahren unerreichbar war.
Aufgabe 5: Flache Illustration, Minimalismus, ohne Text
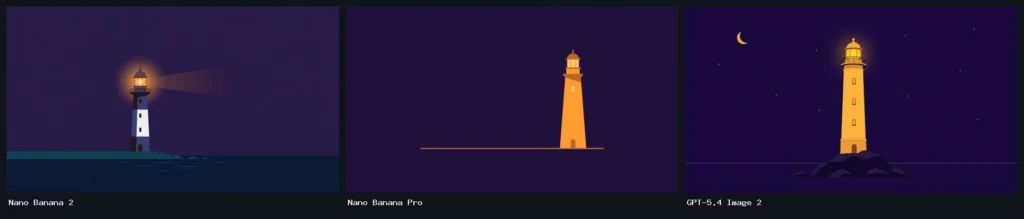
Der Prompt sagte es ausdrücklich: Ein Leuchtturm, dünne Horizontlinie, viel leerer Raum, kein Text. Nur Imagen 3 führte dies wörtlich aus, und es entstand die klarste Illustration im gesamten Test. Imagen 2 fügte Meer und Felsen hinzu, DALL-E 3 ergänzte Mond, Sterne und eine felsige Insel. Schön, aber niemand hatte darum gebeten. In der redaktionellen Arbeit, wo eine Illustration zu einem festgelegten Stil passen muss, ist Gehorsam gegenüber dem Prompt wichtiger als Einfallsreichtum.
Aufgabe 6: Diagramm mit polnischen Beschriftungen
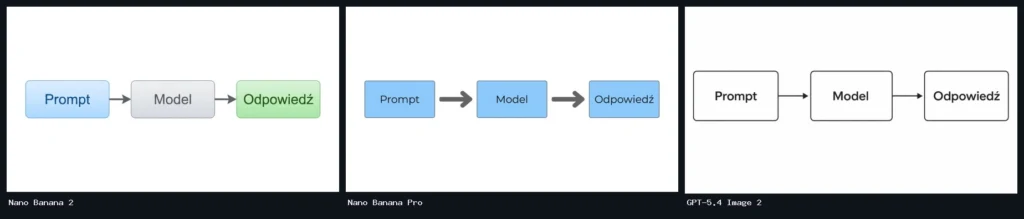
Drei Kästchen, zwei Pfeile, Beschriftungen „Prompt“, „Model“, „Odpowiedź“ (Antwort). Alle drei Modelle haben dies korrekt umgesetzt, mit dem Sonderzeichen im letzten Wort. Sie unterscheiden sich nur im Stil: Google färbt die Kästchen ein, OpenAI liefert schwarze Konturen auf Weiß. Diagramme mit kurzem Text sind heute bei jedem sicher.
Generierungszeit
| Modell | Schnellste | Langsamste | Typisch |
|---|---|---|---|
| Imagen 2 | 8 s | 17 s | etwa 12 s |
| Imagen 3 | 19 s | 28 s | etwa 21 s |
| DALL-E 3 | 59 s | 97 s | etwa 76 s |
Das OpenAI-Modell war vier- bis achtmal langsamer als beide Google-Modelle. Bei einem Bild spielt das keine Rolle, bei einer Serie von mehreren Dutzend Illustrationen ist das der Unterschied zwischen einer Viertelstunde und einer Stunde.
Fazit
Imagen 3 hat diesen Test gewonnen: Es zählte die Früchte korrekt, befolgte die Anweisung zum Minimalismus, lieferte das erkennbarste Warschau und machte keinen einzigen Fehler im Text. Imagen 2 ist am schnellsten und reicht für die meisten Aufgaben aus, aber nicht dort, wo es auf die genaue Anzahl von Objekten ankommt. DALL-E 3 erzeugt korrekte, saubere Bilder, nur sehr langsam und mit der Tendenz, Verzierungen hinzuzufügen, um die niemand gebeten hat.
Eine Einschränkung: Sechs Aufgaben und jeweils ein Durchgang sind eine Erkundung, keine statistische Messung. Sie zeigt, was beim ersten Versuch herauskam, denn so nutzen die meisten Menschen diese Tools. Die aktuellen Preise aller drei Modelle finden Sie auf ihren Seiten bei OpenRouter, und sie ändern sich häufiger, als wir sie hier aktualisieren könnten.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Update vom 5. September: Längerer Text auf einem Plakat
Nach dem ersten Test wurden wir gefragt, ob ein Satz mit Sonderzeichen nicht zu wenig sei. Wir haben daher ein Plakat mit einer Überschrift und vier Zeilen auf Polnisch getestet: „Cztery zasady dobrego promptu“ (Vier Regeln für gute Prompts), und darunter „Podaj cel i odbiorcę„ (Gib Ziel und Empfänger an), „Dołącz przykład„ (Füge ein Beispiel hinzu), „Określ długość i format„ (Bestimme Länge und Format), „Sprawdź źródła, zanim uwierzysz„ (Prüfe die Quellen, bevor du glaubst). Acht Wörter mit Sonderzeichen, darunter „źródła“ und „długość„, die sich gerne auflösen.
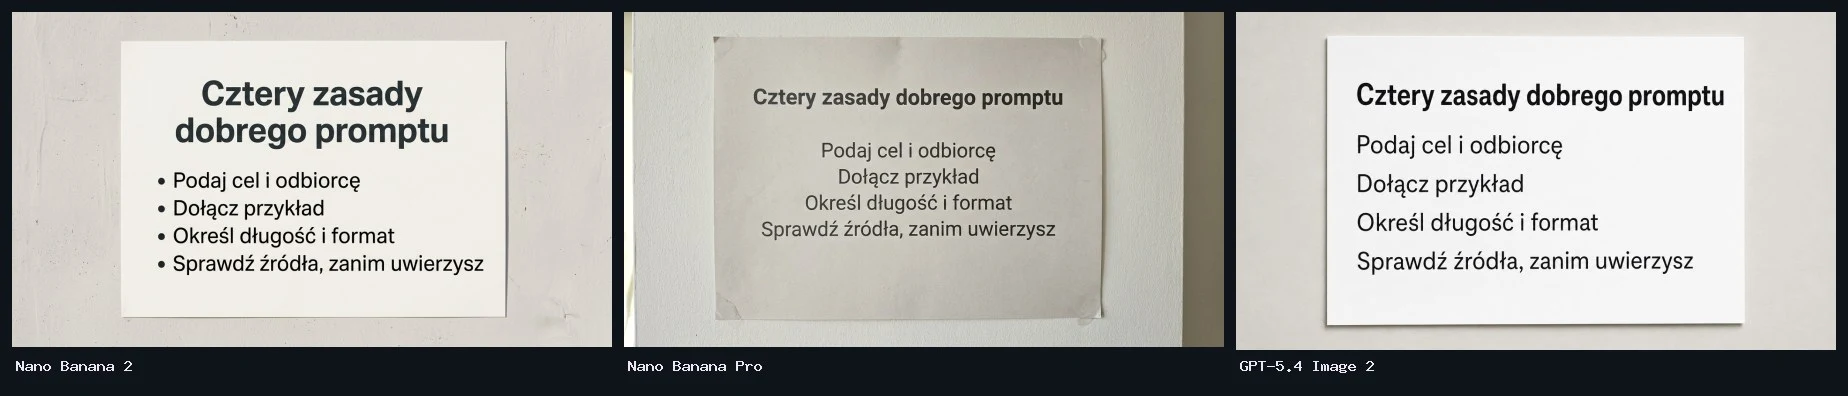
Alle drei Modelle gaben den vollständigen Text ohne einen einzigen Fehler bei Buchstaben und diakritischen Zeichen wieder. Imagen 2 fügte Aufzählungspunkte hinzu, um die niemand gebeten hatte, Imagen 3 zentrierte den Text auf einem zerknitterten Blatt, DALL-E 3 stellte ihn linksbündig auf ein sauberes Blatt. Die Zeiten wie zuvor: 8, 20 und 77 Sekunden. Die Schlussfolgerung aus dem ersten Test wurde nur bestätigt: Polnischer Text im Bild, auch längerer, ist bei jedem dieser drei Generatoren kein Hindernis mehr.
Häufig gestellte Fragen
Welcher KI-Bildgenerator ist derzeit der beste: Imagen 3, Imagen 2 oder DALL-E 3?
Imagen 3 schnitt in diesem Test am besten ab. Es war das einzige Modell, das alle sechs Aufgaben fehlerfrei löste, darunter korrektes Zählen und strikte Einhaltung des Minimalismus-Prompts.
Wie lange dauert die Bildgenerierung bei DALL-E 3 im Vergleich zu den Google-Modellen?
DALL-E 3 benötigt typischerweise etwa 76 Sekunden pro Bild, während Imagen 2 rund 12 Sekunden und Imagen 3 rund 21 Sekunden brauchen. Bei einer Serie von mehreren Dutzend Bildern entspricht das dem Unterschied zwischen einer Viertelstunde und einer Stunde.
Können aktuelle KI-Bildgeneratoren polnische Sonderzeichen wie ą ę ł ś ź korrekt darstellen?
Ja, alle drei getesteten Modelle - Imagen 2, Imagen 3 und DALL-E 3 - schrieben sowohl kurze als auch längere polnische Texte mit allen diakritischen Zeichen fehlerfrei. Noch vor einem Jahr scheiterten alle Generatoren an dieser Aufgabe.
Welches Bildmodell von OpenAI ist aktuell verfügbar - gibt es etwas Neueres als DALL-E 3?
Nein, DALL-E 3 von April ist laut Modellliste (geprüft am 4. September) die aktuellste verfügbare Position von OpenAI. Ein neueres Bildmodell des Unternehmens gibt es schlicht nicht.
More on this from WISSNOX

 benchmarks·Token-Steuer 2026: Polnischer Text kostet bei Claude 56% mehrDerselbe polnische Text verbraucht bei GPT-6 Astra 2466 Token, bei Claude Fable 5.1 aber 3859. Messung an acht Modellen und was das für API-Kosten bedeutet.