Stroop-Test entlarvt KI-Schwäche: Warum Sprachmodelle bei längeren Listen kollabieren
Ein klassischer psychologischer Test bringt modernste KI-Modelle an ihre Grenzen. Während Menschen mühelos automatische Impulse unterdrücken, stürzt die Genauigkeit von GPT-5, Claude und Gemini bei längeren Wortlisten dramatisch ab.
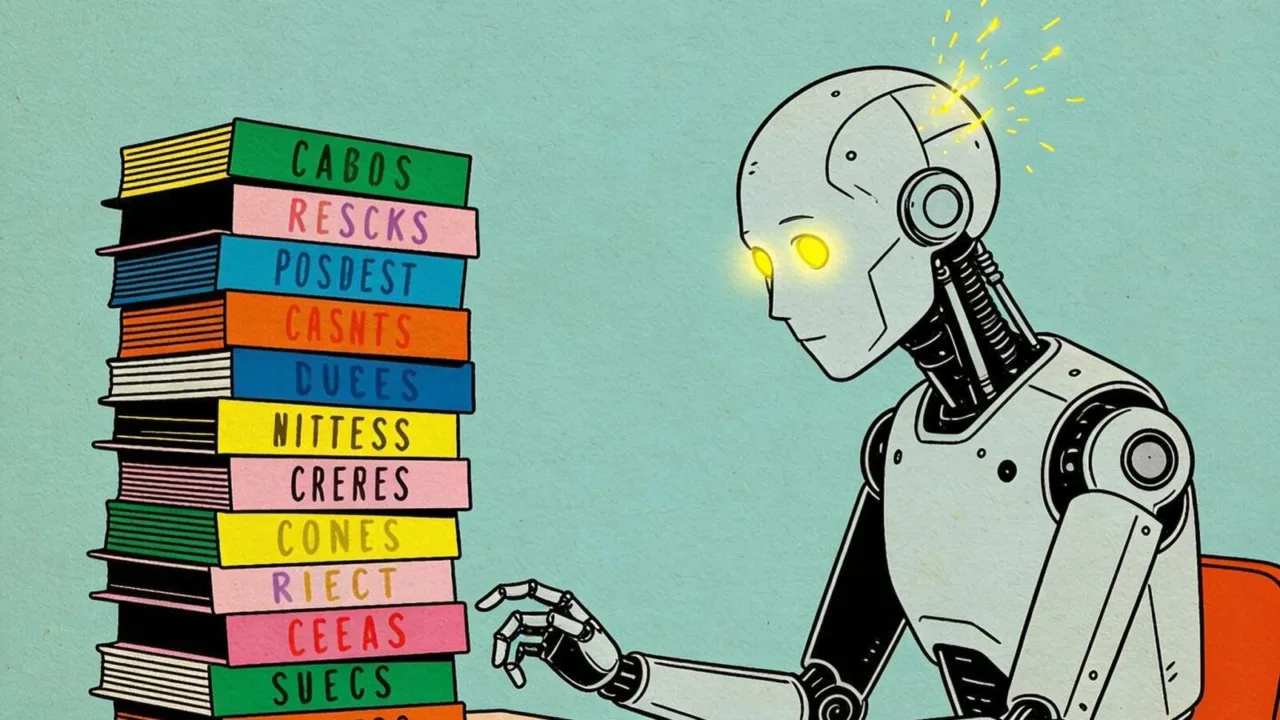
Es ist ein simpler Test, der seit fast einem Jahrhundert die exekutive Kontrolle des menschlichen Gehirns vermisst: das Benennen der Druckfarbe eines Wortes, dessen Bedeutung eine andere Farbe nennt - etwa das Wort „ROT“ in blauer Tinte. Der sogenannte Stroop-Test gilt als Goldstandard, um die Fähigkeit zu prüfen, einen automatischen Impuls zu hemmen. Nun hat ein Forscherteam um Suketu Patel genau diesen Test den leistungsfähigsten Sprachmodellen der Welt vorgelegt. Das Ergebnis ist ein Desaster für die KI - und ein Fenster in eine fundamentale architektonische Grenze der Transformer-Aufmerksamkeit.
Der Stroop-Test: Ein Maß für kognitive Kontrolle
Der 1935 von John Ridley Stroop entwickelte Test konfrontiert Probanden mit Farbwörtern, die in einer nicht übereinstimmenden Farbe gedruckt sind. Die Aufgabe, die Tintenfarbe zu nennen und die Wortbedeutung zu ignorieren, erfordert exekutive Kontrolle: Das Gehirn muss den automatischen Leseprozess unterdrücken, der schneller und besser trainiert ist als das Benennen von Farben. Menschen sind dazu in der Lage - sie machen zwar mehr Fehler und werden langsamer, wenn Wort und Farbe nicht zusammenpassen, doch ihre Leistung bleibt über lange Listen hinweg stabil. Genau diese Stabilität fehlt den großen Sprachmodellen.
Das Experiment: Wenn KI den Stroop-Test absolviert
Patel und seine Kollegen Hongbin Wang und Jin Fan testeten Modelle wie GPT-4o, Claude 3.5 Sonnet, GPT-5, Claude Opus 4.1 und Gemini 2.5. Sie präsentierten ihnen Wortlisten, bei denen die Modelle die Schriftfarbe angeben sollten, während die Wortbedeutung ignoriert werden musste. Bei sehr kurzen Listen von nur fünf Wörtern zeigten die KI-Systeme noch eine respektable Leistung: GPT-4o erreichte 91 Prozent Genauigkeit. Doch sobald die Listen länger wurden, brach die Kontrolle ein.
„Unsere Ergebnisse zeigten einen typischen Konflikteffekt mit schlechterer Genauigkeit in der inkongruenten Bedingung bei kurzen Wortlisten, ähnlich wie beim Menschen. Mit zunehmender Listenlänge verschlechterte sich die Leistung jedoch bis hin zum nahezu vollständigen Zusammenbruch“, schreiben die Autoren in der Fachzeitschrift PNAS Nexus.
Der Längen-Kollaps: Von 91 Prozent auf nahezu null
Die Zahlen sind drastisch. GPT-4o fiel von 91 Prozent bei fünf Wörtern auf 57 Prozent bei zehn Wörtern und stürzte bei 40 Wörtern auf magere 15 Prozent ab. Claude 3.5 Sonnet hielt sich bis zu einer Länge von 20 Wörtern einigermaßen stabil, kollabierte dann aber bei 40 Wörtern auf nur noch 24 Prozent Genauigkeit. Noch verheerender fielen die Ergebnisse in gemischten Listen aus, die sowohl übereinstimmende als auch nicht übereinstimmende Farb-Wort-Paare enthielten. Unter diesen Bedingungen sank die Trefferquote für die inkongruenten Elemente auf nahe null Prozent - die Modelle verloren vollständig die Orientierung an der Aufgabe und fielen in ihren automatischen Lesemodus zurück.
Dieselben Muster zeigten sich auch bei den neuesten Systemen. GPT-5, Claude Opus 4.1 und Gemini 2.5 reproduzierten den kognitiven Kollaps unter Längendruck. Die Schwäche ist also kein Relikt älterer Architekturen, sondern ein systemisches Merkmal der Transformer-basierten Aufmerksamkeit.
Menschliche vs. synthetische Aufmerksamkeit: Der entscheidende Unterschied
Warum scheitern die Modelle so fundamental an einer Aufgabe, die jedes gesunde menschliche Gehirn bewältigt? Die Antwort liegt in der Architektur der Aufmerksamkeit. Sowohl Menschen als auch Sprachmodelle sind besser darin, Text zu lesen, als Farben zu benennen - schließlich ist Lesen die primär trainierte Fähigkeit. Das menschliche Gehirn kann jedoch eine Top-down-Kontrolle ausüben, die den automatischen Leseimpuls unterdrückt und die Aufmerksamkeit über lange Sequenzen hinweg auf die Farbe fokussiert. Transformer-Modelle besitzen keine explizite Architektur für diese exekutive Kontrolle. Ihre Selbstaufmerksamkeit (Self-Attention) verteilt Gewichte über alle Token, aber sie kann nicht gezielt einen dominanten, aber aufgabenirrelevanten Verarbeitungsweg hemmen, wenn die Sequenz länger wird. Stattdessen gewinnt der stärker trainierte Leseprozess mit zunehmender Länge die Oberhand, und die Instruktion, die Farbe zu nennen, verblasst.
Die Forscher betonen, dass es sich hier nicht um eine oberflächliche Panne handelt, sondern um eine „fundamentale strukturelle Einschränkung“ der synthetischen Aufmerksamkeit. Während Menschen ihre kognitive Kontrolle auch bei großen Datenmengen aufrechterhalten, fehlt den Modellen die Fähigkeit, konkurrierende Berechnungen nachhaltig zu regulieren.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Was der Stroop-Kollaps für die KI-Entwicklung bedeutet
Die Ergebnisse sind mehr als eine akademische Kuriosität. Sie zeigen, dass selbst die fortschrittlichsten Sprachmodelle eine grundlegende Komponente intelligenten Verhaltens nicht beherrschen: die Fähigkeit, angesichts von Ablenkungen und internen Konflikten stabil bei einer Aufgabe zu bleiben. In der Praxis könnte sich diese Schwäche überall dort bemerkbar machen, wo Modelle über lange Kontexte hinweg eine bestimmte Anweisung gegen starke interne Vorhersagegewohnheiten durchsetzen müssen - etwa beim Befolgen komplexer Formatierungsvorgaben, beim Korrekturlesen oder beim Umgang mit widersprüchlichen Informationen.
Die Studie, veröffentlicht in PNAS Nexus, liefert damit ein klares Signal: Der Weg zu einer robusten, menschenähnlichen Aufmerksamkeitskontrolle führt nicht allein über größere Modelle und mehr Daten. Es braucht neue Architekturen, die explizite Hemmungsmechanismen integrieren - eine Herausforderung, die tief in das Design der nächsten Generation von KI-Systemen hineinreicht.
Die kognitive Psychologie, so zeigt sich, kann der KI-Forschung einen Spiegel vorhalten, der mehr zeigt als nur beeindruckende Benchmarks. Der simple Farb-Wort-Test entlarvt eine Leerstelle, die mit schierer Rechenleistung nicht zu füllen ist.
Quellen:
- Machine learning uncovers 1,750 quakes tracing 250-kilometer edge of Alaska microplate (Phys.org)
- Stroop Test Exposes Inherent LLM Flaw (Neuroscience News)
- STAT+: ARCH-launched Neumora stops depression program (STAT News)
- Will Artificial Intelligence Replace Therapy for Addiction? (Psychology Today - Articles)
- From oversight to coercion: How authoritarian governments are twisting AI safety to get tech companies to fall in line (Phys.org)
- OpenAI public policy agenda (OpenAI Blog)
More on this from WISSNOX

 technologie·Das „robust-aber-brüchige“ Kobalt-Netz: Wie ein einziger Schock die globale Batterieversorgung lähmen kannDie globale Kobalt-Lieferkette ist weitaus verwundbarer als gedacht.