Warum ein simpler Algorithmus mindestens die Hälfte aller Cloud-Jobs rettet
In der Cloud ist nichts konstant: Ständig schwankende Rechenkapazitäten machen Job-Scheduling zum Albtraum. Forscher von Google zeigen nun, dass eine fast schon naive Strategie selbst im schlimmsten Chaos erstaunlich gut funktioniert.
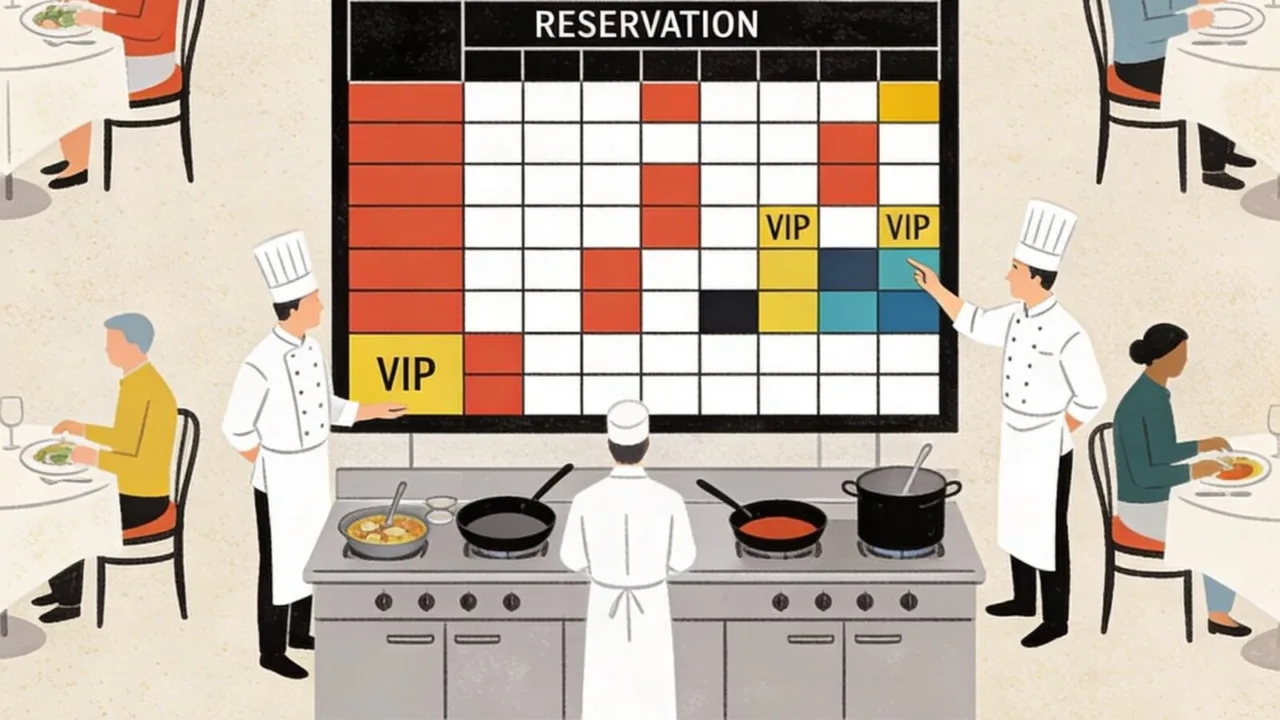
Stellen Sie sich ein Restaurant vor, in dem ständig Tische für VIPs reserviert werden - mal um 19 Uhr, mal um 20:30 Uhr, oft ohne Vorwarnung. Der Restaurantleiter muss die übrigen Gäste so platzieren, dass möglichst viele zufrieden essen können, ohne dass jemand mitten im Hauptgang den Tisch räumen muss. Genau vor diesem Problem stehen die Scheduler in modernen Cloud-Rechenzentren. Die „VIPs“ sind hochprioritäre Aufgaben, die jederzeit Ressourcen beanspruchen können. Die „übrigen Gäste“ sind Batch-Jobs, etwa für Datenanalysen oder das Training von KI-Modellen, die nicht unterbrochen werden dürfen, weil sonst alle bisherigen Berechnungen verloren sind.
Forscher von Google Research haben dieses Problem nun in einer grundlegenden Arbeit mathematisch durchdrungen. Ihr Ergebnis ist ebenso überraschend wie beruhigend: Ein Algorithmus, der im Grunde nur die nächstbeste, am schnellsten zu erledigende Aufgabe wählt, liefert selbst unter widrigsten Bedingungen eine feste Leistungsgarantie. Er schafft stets mindestens die Hälfte des theoretisch optimalen Durchsatzes - eine Eigenschaft, die in der Informatik als 1/2-Approximation bezeichnet wird.
Das trügerische Ideal der statischen Ressourcen
In der klassischen Informatik-Lehre wird Rechenkapazität oft als statische Größe betrachtet: Ein Server hat 64 CPUs, ein Cluster 100 Maschinen. Die Realität großer Rechenzentren ist eine fundamental andere. „Ressourcen schwanken ständig aufgrund von Hardware-Ausfällen, Wartungszyklen oder Strombegrenzungen“, erklärt Manish Purohit, Research Scientist bei Google und Hauptautor der Studie, die auf der SPAA 2025 vorgestellt wurde. Noch entscheidender ist ein architektonischer Faktor: In gestaffelten Scheduling-Systemen greifen hochprioritäre Aufgaben jederzeit auf Ressourcen zu und hinterlassen eine zeitlich variierende „Restkapazität“ für niedriger priorisierte Jobs.
Für diese Batch-Jobs gilt eine harte Regel: Sie sind nicht-unterbrechbar (non-preemptive). Wird ein Job mittendrin gestoppt, ist alle geleistete Arbeit verloren. Der Scheduler steht damit vor einer folgenschweren Entscheidung: Starte ich einen langen Job jetzt und riskiere, dass die Kapazität in zehn Minuten einbricht? Oder warte ich auf ein sichereres Zeitfenster und verpasse womöglich die Deadline? Jeder Fehlgriff bedeutet verschwendete Rechenzeit und verpasste Geschäftschancen.
Die überraschende Kraft der Gier
Die Google-Forscher analysierten das Problem in zwei Szenarien: einem Offline-Setting, bei dem alle künftigen Jobs und Kapazitätsschwankungen im Voraus bekannt sind, und einem Online-Setting, bei dem Jobs in Echtzeit eintreffen und sofortige, unwiderrufliche Entscheidungen verlangen. In beiden Fällen ist die optimale Lösung NP-schwer, also für realistische Problemgrößen nicht exakt berechenbar.
Für das Offline-Szenario untersuchte das Team eine Strategie namens Greedy (englisch für „gierig“). Der Algorithmus wählt iterativ den Job aus, der am frühesten fertiggestellt werden kann, und weist ihm ein passendes Zeitfenster zu. Diese fast schon naive Heuristik erreicht eine Approximationsgarantie von 1/2, wenn alle Jobs den gleichen Wert haben. Das bedeutet: Selbst im schlimmsten Fall, mit bösartig konstruierten Job-Profilen und Kapazitätsverläufen, schafft Greedy mindestens die Hälfte der Jobs, die ein allwissender optimaler Algorithmus unterbringen könnte. „Das entspricht den Garantien, die Greedy auch auf einfacheren Maschinen mit Einheitskapazität genießt“, so Purohit. Wenn Jobs unterschiedliche Profite bringen, sinkt die Garantie auf 1/4 - ein Preis für die zusätzliche Komplexität der Wertunterschiede.
Wenn die Zukunft unbekannt ist
Die eigentliche Härte zeigt sich im Online-Setting. Hier treffen Jobs unvorhersehbar ein, und der Scheduler muss sofort entscheiden - ohne zu wissen, ob in der nächsten Sekunde ein viel lukrativerer Job anklopft. Standard-Algorithmen, die einmal gestartete Jobs nie unterbrechen, versagen hier vollständig: Ihre Competitive Ratio, also das Verhältnis zum Optimum, geht gegen null. Der Grund ist einleuchtend: Eine einzige Fehlentscheidung, etwa einen sehr langen Job zu starten, kann die Möglichkeit zerstören, viele kurze, aber in Summe wertvollere Jobs abzuarbeiten.
Um das Problem lösbar zu machen, führten die Forscher zwei realistische Flexibilisierungen ein. Die erste erlaubt Unterbrechungen mit Neustart: Ein laufender Job darf abgebrochen werden, wobei die bereits geleistete Arbeit verloren geht, der Job aber im System bleibt und später erneut gestartet werden kann. In diesem Modell erreicht eine Variante von Greedy weiterhin eine Competitive Ratio von 1/2 - eine bemerkenswerte Robustheit. Die zweite, strengere Variante erlaubt Unterbrechungen ohne Neustart: Der abgebrochene Job wird endgültig verworfen. Hier bricht die Competitive Ratio erneut ein, weil jeder Abbruch unwiderruflichen Schaden anrichtet.
Für den praktisch äußerst relevanten Fall, dass alle Jobs eine gemeinsame Deadline haben - etwa wenn sämtliche Datenverarbeitungen bis zum nächtlichen Batch-Lauf abgeschlossen sein müssen - entwickelte das Team dennoch einen Algorithmus mit konstanter Competitive Ratio. Seine Logik ist intuitiv: Bei jedem neuen Job prüft das System vier mögliche Aktionen in fester Reihenfolge:
- Einfügen: Der Job wird in ein leeres Zeitintervall des vorläufigen Plans gesetzt.
- Ersetzen: Ein anderer, zukünftiger Job wird verdrängt, wenn der neue deutlich kleiner ist.
- Unterbrechen: Der aktuell laufende Job wird gestoppt, wenn der neue Job kürzer ist als die verbleibende Laufzeit des aktuellen.
- Verwerfen: Der neue Job wird ignoriert, wenn keine der obigen Aktionen sinnvoll ist.
Für allgemeine Kapazitätsprofile erreicht dieser Algorithmus eine Competitive Ratio von 1/11. Das klingt auf den ersten Blick bescheiden - nur rund 9 Prozent des Optimums. Doch in der theoretischen Informatik ist eine konstante Garantie, die unabhängig von der Problemgröße gilt, ein bedeutender Fortschritt. In der Praxis, wo Job-Sequenzen selten bösartig konstruiert sind, liegt die tatsächliche Leistung meist weit darüber.
Google · Deine QuellenWissnox höher in Ihrem Google - mit einem KlickZu bevorzugten Quellen hinzufügen →Was das für die Cloud bedeutet
Die Arbeit der Google-Forscher liefert mehr als nur theoretische Einsichten. Sie schafft ein formales Fundament für robustere Scheduler in volatilen Cloud-Umgebungen. Die Erkenntnis, dass einfache, myopische Strategien selbst unter widrigsten Bedingungen eine beweisbare Mindestleistung erbringen, hat direkte Konsequenzen für das Design von Ressourcen-Management-Systemen. Statt komplexer, schwer durchschaubarer Heuristiken könnten künftige Scheduler auf algorithmisch abgesicherte Bausteine setzen, deren Verhalten auch in Extremsituationen vorhersagbar bleibt.
Die Studie zeigt zudem, wie wichtig die richtige Abstraktion ist. Indem sie das Problem auf seine Essenz reduzierten - Jobs mit Release-Zeit, Deadline, Dauer und Wert, kombiniert mit einem zeitvariablen Kapazitätsprofil - konnten die Forscher allgemeingültige Aussagen treffen, die für eine Vielzahl realer Systeme relevant sind. Die Grenzen sind klar benannt: Sobald Jobs nach einer Unterbrechung endgültig verloren sind und keine gemeinsame Deadline existiert, versagen auch die besten Online-Algorithmen. Doch genau diese Klarheit ist wertvoll, denn sie zeigt Systemarchitekten, wo sie ansetzen müssen: entweder durch die Möglichkeit von Neustarts oder durch die Bündelung von Jobs unter gemeinsamen Deadlines.
Die Wolke, in der unsere Daten und Berechnungen leben, ist eben kein statisches Gebilde, sondern ein dynamischer Organismus. Ihn zu bändigen erfordert Algorithmen, die mit Unsicherheit umgehen können, ohne in Panik zu verfallen. Die Google-Studie beweist: Manchmal ist die einfachste Strategie nicht nur die eleganteste, sondern auch die robusteste.
Quellen:
- Scheduling in a changing world: Maximizing throughput with time-varying capacity (Google Research Blog)
- Designing synthetic datasets for the real world: Mechanism design and reasoning from first principles (Google Research Blog)
- Databricks brings GPT-5.5 to enterprise agent workflows (OpenAI Blog)
- A new personal finance experience in ChatGPT (OpenAI Blog)
- Introducing Trusted Contact in ChatGPT (OpenAI Blog)
- Testing ads in ChatGPT (OpenAI Blog)
More on this from WISSNOX

 medizin·Die stille Wurzelinfektion, die Ihren Blutzucker sabotiertEine tiefe Zahnwurzelinfektion verursacht oft keine Schmerzen - doch sie kann eine chronische Entzündung im Körper auslösen, die die Insulinfunktion stört.